
Regresjon
I all forskning og analyse er det svært vanlig å samle inn informasjon om flere variabler for å undersøke sammenhengene mellom dem. Det kan innebære at man samler inn sosioøkonomiske data (inntekt, utdanning, etnisitet osv.), antropometriske data (vekt, høyde, BMI osv.), sykdomshistorie (forekomst av diabetes, revmatisme, lungesykdom, kreft osv.), biomarkører (kolesterol, CRP, kreftmarkører osv.) og andre måleverdier (blodtrykk, alder osv.). Hvis man vil undersøke sammenhengen mellom disse variablene, er regresjon et kraftig verktøy. Regresjon lar oss gjøre følgende:
- Studere relasjonen (assosiasjonen) mellom én avhengig variabel () og én eller flere uavhengige variabler (prediktorer, ).
- Studere hvor sterk relasjonen (assosiasjonen) er mellom hver enkelt prediktor () og den avhengige variabelen ().
- Lage en prediksjonsmodell som kan brukes til å predikere, noe som innebærer at vi på grunnlag av informasjon om kan forutsi .
I en regresjonsanalyse predikeres én variabel () av minst én prediktor (). Terminologisk sier man at er avhengig av ; er derfor den avhengige variabelen og er den uavhengige variabelen.
| Oppgave i modellen | Synonym | |
|---|---|---|
| Y | Variabelen som skal predikeres | Avhengig variabel, dependent variable, outcome, utfall, utfallsmål, label, target |
| X | Brukes til å predikere Y | Prediktor, predictor, feature, kovariat, covariate |
Prediksjon vs. effektestimering
Som nevnt ovenfor kan regresjon brukes til å studere relasjonen mellom variabler, studere styrken i sammenhengene og/eller utføre prediksjoner. I praksis innebærer det at vi enten studerer hvordan én eller flere prediktorer er assosiert med utfallsmålet, eller at vi lager en prediksjonsmodell for å kunne forutsi en verdi eller en hendelse (). Man bør skille regresjonsmodeller som har prediksjon som mål (dvs. å gjøre prediksjoner), fra modeller som har effektestimering som mål (dvs. å studere styrken og formen på sammenhengene).
Prediksjon: Anta at vi har samlet inn data om 10000 personer og fulgt dem i flere år for å studere insidensen av kreft. For hver person har vi blant annet samlet inn opplysninger om alder, kjønn, yrke, sosioøkonomi, røyking, sykdommer, legemiddelbruk og bosituasjon. Hvis målet er å kunne forutsi hvilke personer som kommer til å utvikle lungekreft, er formålet med regresjonsanalysen å gjøre prediksjoner.
Effektestimering: Anta at vi har samlet inn data om 10000 personer og fulgt dem i flere år for å studere insidensen av lungekreft. For hver person har vi blant annet samlet inn opplysninger om alder, kjønn, yrke, sosioøkonomi, røyking, sykdommer, legemiddelbruk og bosituasjon. Hvis vårt mål er å studere relasjonen mellom (for eksempel) røyking og risikoen for kreft, er formålet med regresjonsanalysen å estimere effekten av én prediktor (røyking). Da er det viktig at sammenhengen mellom røyking og kreft ikke forstyrres av andre faktorer. Det kan for eksempel være slik at røykere har en tendens til å ha lavere sosioøkonomisk status, som også påvirker risikoen for kreft. Det ville derfor være ønskelig å ta høyde for (med andre ord justere for) sosioøkonomisk status. Dette kan gjøres ved å inkludere sosioøkonomisk status som en prediktor i modellen. Når man konstruerer regresjonsmodeller for effektestimering, er det viktig å ta hensyn til konfundere (se kapittelet Kausal inferens) av denne typen.
Enkel lineær regresjon: én avhengig variabel og én prediktor
Dette er en kort repetisjon av kapittelet Lineær regresjon.
Den vanlige regresjonsligningen ser slik ut:
- er interceptet, som er punktet der regresjonslinjen krysser Y-aksen (se figuren ovenfor).
- er koeffisienten for
mass, som innebærer at det er verdien for regresjonslinjens stigningstall. - er differansen mellom modellens predikerte verdi av og den observerte verdien av . Dette er altså modellens feil (error).
Følgende figur viser sammenhengen mellom prediktoren mass (kroppsvekt) og utfallet glucose (blodsukker).
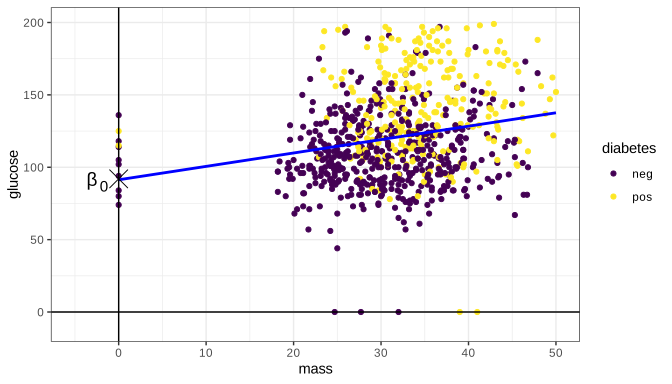
Regresjonslinjen ovenfor viser en positiv sammenheng mellom og ; når øker, øker . Det visuelle inntrykket av figuren ovenfor er altså at kan brukes til å predikere . Vi kan nå skrive om ligningen for lineær regresjon med variablene mass og glucose:
Hvis vi ønsker å analysere sammenhengen mellom mass og glucose justert for alder, kreves multippel regresjon. Det innebærer at multippel regresjon brukes til å studere sammenhengen mellom minst to prediktorer og ett utfall.
Multippel regresjon
<!-- video: https://science.nu/wp-content/uploads/Regressionsplan.mp4 -->
Multippel regresjon er en modell med flere, minst 2, prediktorer. Den matematiske formelen for multippel regresjon med to prediktorer ser slik ut:
Denne sammenhengen kan ikke lenger fremstilles med en rett regresjonslinje. Sammenhengen mellom og prediktorene og utgjør nå et tredimensjonalt regresjonsplan, som eksemplifiseres i figuren ovenfor.
Statistisk signifikans: er sammenhengen mellom X og Y statistisk signifikant?
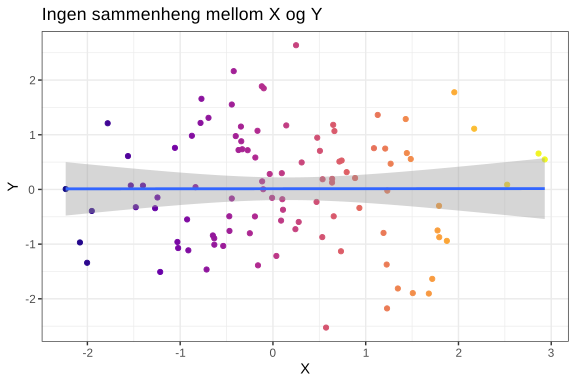
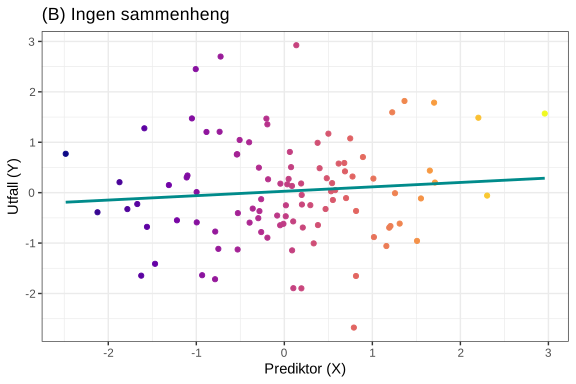
Et sentralt spørsmål er om sammenhengen mellom og er statistisk signifikant. Dette spørsmålet kan delvis besvares gjennom en visuell vurdering av den grafiske sammenhengen. Visuelle vurderinger er imidlertid subjektive, og det er dessuten vanskelig å vurdere tredimensjonale regresjonsplan (eller regresjonsplan med enda flere dimensjoner ). Det trengs et formelt mål på om sammenhengen mellom og er signifikant. Dette kan gjøres innenfor rammen av hypotesetesting, dvs. ved å etablere en nullhypotese. I denne sammenhengen er nullhypotesen at det ikke finnes noen sammenheng mellom og , noe som innebærer at stigningstallet (koeffisienten) for prediktoren er lik 0. Hvis stigningstallet er 0, finnes det ingen sammenheng mellom og . En slik sammenheng er illustrert i figuren nedenfor.
Signifikanstesting med t-test (t-statistic)
For å undersøke om det finnes en statistisk signifikant sammenheng mellom og må vi teste nullhypotesen. Nullhypotesen er at koeffisienten for prediktoren ikke har noe stigningstall, noe som innebærer at verdien av ikke endres når X økes eller reduseres. Oppgaven blir å beregne sannsynligheten for at nullhypotesen stemmer. Hvis den sannsynligheten er <5 % (p<0,05), forkaster vi nullhypotesen og sier dermed at det finnes en sammenheng, dvs. at er en statistisk signifikant prediktor.
Nullhypotesen kan testes med en t-test. Verdien som beregnes kalles t-statistic, og den beregnes ved at koeffisienten () divideres med sin standardfeil (standard error). Den aktuelle t-verdien kan deretter oversettes til en p-verdi. Alle statistikkprogrammer, inkludert R, gjør disse beregningene automatisk. Det innebærer at når man lager en regresjonsmodell, får man automatisk t-tester og p-verdier for samtlige prediktorer i modellen.
Nå skal vi lage en regresjonsmodell og tolke resultatene i detalj.
Øvingseksempel med multippel regresjon
Her følger to øvelser med multippel regresjon, der vekten ligger på tolkning av resultatene. Øvelsene gjennomføres i R. Du kan kopiere koden nedenfor til R og gjøre de samme kjøringene.
Vi kommer til å bruke flere pakker for å forenkle og effektivisere arbeidet. Multippel lineær regresjon finnes i base R (standardinstallasjonen av R). Funksjonen heter lm(). I tillegg trenger vi pakkene sjPlot, broom og tidyverse for å hente ut og presentere resultatene. Vi kommer til å bruke PimaIndiansDiabetes-data (fra pakken mlbench), som inneholder informasjon om pimaindianere, som har høy risiko for diabetes. For å installere og aktivere pakkene samt dataene skriver man følgende kommandoer:
install.packages(c("sjPlot", "broom", "mlbench"))
library(sjPlot)
library(broom)
library(tidyverse)

## Data om pimaindianere
library(mlbench)
data("PimaIndiansDiabetes")

## Kopier dataene til et objekt med kortere navn
pima <- PimaIndiansDiabetes

## Inspiser de første 5 radene
head(pima, 5)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
6 148 72 35 0 33.6 0.627 50 pos
1 85 66 29 0 26.6 0.351 31 neg
8 183 64 0 0 23.3 0.672 32 pos
1 89 66 23 94 28.1 0.167 21 neg
0 137 40 35 168 43.1 2.288 33 posI neste steg lager vi en regresjonsmodell. Dette gjøres med funksjonen lm() (linear model), som brukes når den avhengige variabelen er kontinuerlig. I dette tilfellet er den avhengige variabelen (utfallet, Y) blodsukker (glucose).
Med funksjonen lm() brukes tegnet ~ for å spesifisere modellen. Til venstre for ~ plasseres den avhengige variabelen (glucose), og til høyre spesifiseres alle prediktorer adskilt med +. Resultatet lagrer vi i objektet my_model. Deretter kjører vi objektet for å se resultatet.
my_model <- lm(glucose ~ mass + age + insulin + pressure, data=pima)
my_modelCall:
lm(formula = glucose ~ mass + age + insulin + pressure, data = pima)
Coefficients:
(Intercept) mass age insulin pressure
68.89351 0.58340 0.72475 0.08665 0.03373Ovenfor ser vi modellens spesifikasjon under overskriften Call. Under overskriften Coefficients ser vi koeffisientene. Det var altså en temmelig sparsom presentasjon av modellen. La oss bruke funksjonen summary() på objektet i stedet.
summary(my_model)Call:
lm(formula = glucose ~ mass + age + insulin + pressure, data = pima)
Residuals:
Min 1Q Median 3Q Max
-123.65 -17.78 -2.50 16.23 86.57
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 68.893507 5.491146 12.546 < 2e-16 ***
mass 0.583397 0.138432 4.214 2.81e-05 ***
age 0.724746 0.090398 8.017 4.06e-15 ***
insulin 0.086647 0.009137 9.483 < 2e-16 ***
pressure 0.033732 0.057169 0.590 0.555
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 28.52 on 763 degrees of freedom
Multiple R-squared: 0.2087, Adjusted R-squared: 0.2045
F-statistic: 50.3 on 4 and 763 DF, p-value: < 2.2e-16Dette henter ut mer informasjon om modellen. For hver prediktor presenteres nå koeffisienten (Estimate), standardfeilen (Std. Error), t-statistic (t value) og p-verdien (Pr(>|t|)). Resultatene tolkes slik:
- (Intercept): Vi er ikke interessert i interceptet. Det er svært sjelden at interceptet er av interesse. Interceptet angir hva Y-verdien (glucose) er når alle X-verdiene er 0, og dette er ikke biologisk meningsfullt (f.eks. er det ingen mennesker som veier 0 kilo). Interceptet rapporteres likevel alltid.
- Prediktorene:
- mass: Når mass øker med 1 enhet, øker glucose med 0,583397 enheter.
- age: Når age øker med 1 enhet, øker glucose med 0,724746 enheter.
- Likeledes er de øvrige prediktorene også positivt assosiert med glucose, ettersom alle koeffisientene er positive.
- Alle prediktorer, bortsett fra pressure, har signifikante p-verdier (p<0,05). Det betyr at sammenhengen mellom pressure og glucose ikke er statistisk signifikant.
- Assosiasjonen for hver prediktor er justert for alle de andre prediktorene. Det betyr at hver koeffisient viser hvordan prediktoren påvirker glucose når de øvrige prediktorene holdes konstante.
- R2 og Adjusted R2: R2 er modellens forklaringsevne. I dette tilfellet er R2 0,2087, noe som innebærer at modellen forklarer 20,87 % av all variasjon i glucose.
Det finnes flere funksjoner og pakker som kan hente ut og presentere modellens resultater. Vi begynner med pakken sjPlot, som har flere nyttige funksjoner for formålet. Med tab_model() presenteres modellens resultater i en tabell:
library(sjPlot)
tab_model(my_model)| Predictor | Estimates | 95% CI | P value |
|---|---|---|---|
| (Intercept) | 68.89 | 58.11 – 79.67 | <0.001 |
| mass | 0.58 | 0.31 – 0.86 | <0.001 |
| age | 0.72 | 0.55 – 0.90 | <0.001 |
| insulin | 0.09 | 0.07 – 0.10 | <0.001 |
| pressure | 0.03 | -0.08 – 0.15 | 0.555 |
| Observations | 768 | ||
| R2 / R2 adjusted | 0.209 / 0.205 |
I resultatene ovenfor presenteres også et konfidensintervall som angir innenfor hvilket intervall den sanne koeffisienten befinner seg med 95 % sannsynlighet. Med 95 % sannsynlighet ligger koeffisienten for mass mellom 0,31 og 0,86. Merk at dette intervallet ikke inkluderer 0 (null), noe som innebærer at vi med 95 % sikkerhet kan si at en økning i mass gir en økning i glukose. Dette stemmer med p-verdien, som er <0,001. Sammenhengen mellom mass og glukose er altså statistisk signifikant. Denne effekten av mass er justert for effekten av de øvrige prediktorene (kovariatene) i modellen.
Koeffisienten for mass angir hvor stor effekt 1 enhets økning i mass har på glucose når alle andre prediktorer (kovariater) holdes konstante. Det samme prinsippet gjelder for de øvrige prediktorene.
Merk raden Observations i tabellen. Den viser hvor mange observasjoner som ble inkludert i regresjonsmodellen. Husk at hvis en observasjon mangler opplysning (dvs. har "missing") på noen av prediktorene som inngår i modellen, ekskluderes den observasjonen fra hele modellen. Det innebærer at hvis en observasjon for eksempel mangler opplysning om mass, men har verdier for alle øvrige variabler, ekskluderes den personen fra modellen, og vi mister én observasjon.
Med funksjonen plot_model() får vi en grafisk presentasjon av resultatene. Funksjonen har en lang rekke argumenter som du kan bruke for å justere grafen.
plot_model(my_model, show.values = T)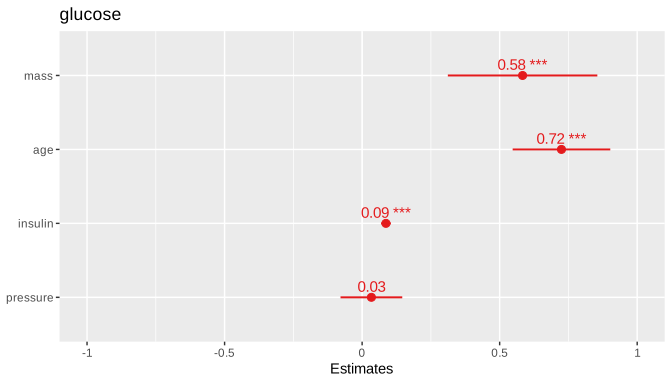
Linearitet (Linearity)
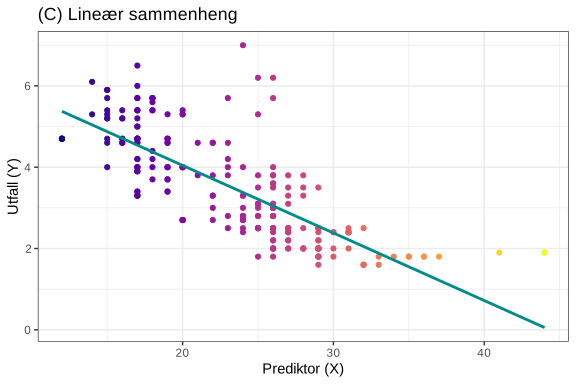
Bruk av lineær regresjon krever at hver prediktor er lineært assosiert med Y. Figuren nedenfor viser en lineær regresjonslinje gjennom (A) data med ikke-lineær sammenheng, (B) data uten sammenheng og (C) data med lineær sammenheng. I tilfellet (A) mislykkes den lineære modellen i å fange opp en eksisterende sammenheng. I tilfellet (B) finnes det ingen nevneverdig sammenheng å fange opp.
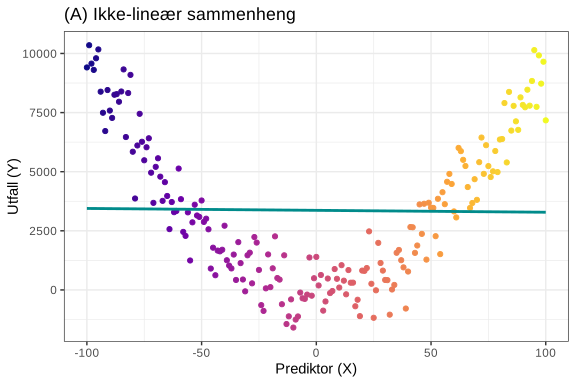
Å logaritmere X hjelper ikke for å fange sammenhengen i tilfellet (A), selv om logaritmering kan gjøre ikke-lineære sammenhenger mer lineære. For å fange sammenhengen i tilfellet (A) kreves en mer fleksibel linje. Metoder for å håndtere ikke-linearitet er diskutert i kapittelet Håndtering av kontinuerlige variabler.
Modellspesifikasjon: å spesifisere modellen korrekt
Hvis en regresjonsmodell er feilaktig spesifisert, er koeffisientene ikke pålitelige. Å utelate viktige kovariater eller interaksjoner mellom variabler, eller å ignorere ikke-lineære sammenhenger, er vanlige årsaker til at modellen er feilaktig spesifisert. Dette kan føre til at effekten av én eller flere prediktorer overestimeres, underestimeres eller feiltolkes. En interaksjon innebærer at to (eller flere) prediktorer samvirker med hverandre, i den forstand at effekten av den ene prediktoren avhenger av den andre prediktoren.
Interaksjoner
Anta at legemiddel X brukes til å behandle hodepine. Legemiddelet virker bare på kvinner fordi substansen aktiveres av et enzym som finnes i brystkjertler. Effekten av legemiddelet avhenger altså av kjønn. Det finnes med andre ord en interaksjon mellom legemiddelets effekt og kjønn. Å ikke ta hensyn til denne interaksjonen fører til en feilaktig modell. Den feilaktige modellen spesifiseres slik:
Modellen er feilaktig fordi den behandler kjønn og legemiddel som to separate parametere (prediktorer). Den korrekte modellen spesifiseres med interaksjonen mellom legemiddel og kjønn. Interaksjonen innebærer at man multipliserer legemiddel med kjønn (rent matematisk innebærer det at kombinasjonen av hvert nivå av kjønn og hvert nivå av legemiddel introduseres som en prediktor):
For å avgjøre om interaksjonen er signifikant, vurderer man p-verdien for interaksjonsleddet. All statistisk programvare (inkludert R) rapporterer p-verdi (og 95 % konfidensintervall) for interaksjonsledd. Hvis interaksjonsleddet er signifikant (p < 0,05), er det bevis for at det finnes en interaksjon mellom prediktorene.
Multicollinearity (Multikollinearitet)
Formålet med multippel regresjon er å kvantifisere den uavhengige effekten av hver enkelt prediktor. Det finnes imidlertid situasjoner der en prediktor ikke kan gjøres uavhengig av én eller flere andre prediktorer. Anta at vi undersøker hvordan BMI (body mass indeX) påvirker blodsukker. Vi lager en regresjon der blodsukker er utfallsmål, og BMI og alder er prediktorer:
La oss si at effekten (koeffisienten) for BMI er 0,5, noe som innebærer at for hver enhet BMI øker, stiger blodsukkeret med 0,5 enheter. Denne effekten av BMI er uavhengig av alder, ettersom vi har justert for alder. Man kan også si at dette er effekten av BMI når vi holder alder konstant. Hvis vi skulle introdusere enda en kovariat, nemlig vekt, kan multicollinearity oppstå. BMI og vekt er nemlig svært sterkt relatert (BMI er en funksjon av vekt og høyde), i den forstand at når BMI øker, har også kroppsvekten en tendens til å øke. Man kan da ikke hevde at koeffisienten for BMI representerer effekten av BMI når vekt holdes konstant, ettersom vekt med all sannsynlighet også øker når BMI øker. Dette er et eksempel på multikollinearitet, dvs. når to eller flere prediktorer er sterkt korrelert med hverandre.
Denne typen korrelasjon mellom prediktorer svekker koeffisientenes presisjon. Det innebærer også at vi bruker mer informasjon enn nødvendig. Hvis informasjonen som finnes i BMI også finnes i vekt, og omvendt, er det tilstrekkelig at én av disse prediktorene inkluderes i modellen.
Risikoen for multicollinearity er høy hvis korrelasjonen (se kapittelet Korrelasjon) mellom to prediktorer er 0,9 eller høyere. Multicollinearity kan imidlertid bli et problem også ved lavere korrelasjonsgrader. Med variance inflation factor (VIF) kan man undersøke multicollinearity.
Test for multikollinearitet (multicolinearity)
Det finnes flere ulike mål for å teste multikollinearitet. Dette kan testes globalt for hele modellen og for enkeltprediktorer i modellen. Et vanlig mål på multikollinearitet er VIF (variance inflation factor). VIF er et mål på hvor oppblåst en prediktors varians er som følge av multikollinearitet i modellen. Hvis VIF er større enn 5, foreligger det multikollinearitet. Hvis VIF er >10, bør variabelen ekskluderes fra modellen.
Vi lager nå en modell med data fra pimaindianerne. Denne gangen bruker vi alle variablene i dataene til å predikere blodsukker (glucose). Vi aktiverer pakken mlbench for å laste inn dataene om pimaindianerne.
library(mlbench)
data("PimaIndiansDiabetes")
my_model <- lm(glucose ~ ., data=PimaIndiansDiabetes)
Deretter installerer vi pakken performance og bruker funksjonen check_model() for å hente ut VIF grafisk og i tabellformat:
install.packages("performance")
library(performance)

## Grafisk
check_model(my_model, check="vif")

## I tabellformat
multicollinearity(my_model)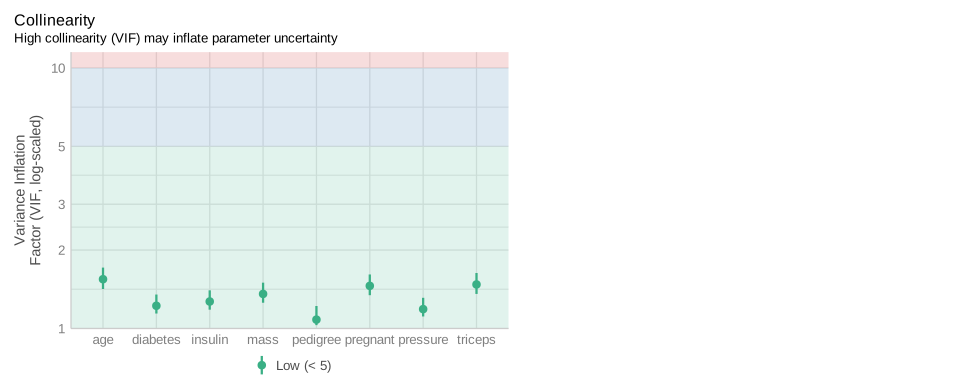
## Check for Multicollinearity

Low Correlation

     Term  VIF   VIF 95% CI Increased SE Tolerance Tolerance 95% CI
 pregnant 1.46 [1.34, 1.61]         1.21      0.69     [0.62, 0.75]
 pressure 1.19 [1.11, 1.31]         1.09      0.84     [0.76, 0.90]
  triceps 1.48 [1.36, 1.63]         1.21      0.68     [0.61, 0.74]
  insulin 1.27 [1.18, 1.40]         1.13      0.79     [0.71, 0.85]
     mass 1.36 [1.26, 1.50]         1.17      0.74     [0.67, 0.80]
 pedigree 1.08 [1.03, 1.22]         1.04      0.92     [0.82, 0.97]
      age 1.55 [1.42, 1.71]         1.24      0.65     [0.58, 0.71]
 diabetes 1.22 [1.14, 1.35]         1.11      0.82     [0.74, 0.88]
Som det fremgår ovenfor, fantes det ingen prediktor med VIF >5, så kollinearitet er ikke noe problem i vår modell.
Kategoriske prediktorer (factors)
Hittil har diskusjonen bare omhandlet prediktorer som er kontinuerlige variabler. Selvfølgelig kan man studere prediktorer som er kategoriske variabler, som kjønn, behandling, by, land osv. Regresjonsmodeller inneholder gjerne både kontinuerlige og kategoriske prediktorer.
La oss si at vi studerer hvordan alder, vekt og fødeland påvirker blodtrykk. Modellen ser slik ut:
Alder og vekt er kontinuerlige variabler. Fødeland (land) er derimot en kategorisk variabel med følgende kategorier: (1) Sverige, (2) Norden og (3) Europa. Når vi inkluderer land i modellen, må én av disse kategoriene brukes som referansekategori, og de øvrige kategoriene sammenlignes med den referansen. La oss nå tolke resultatene fra regresjonsmodellen ovenfor:
| Estimate | 95% CI | P values | |
|---|---|---|---|
| (Intercept) | 83.68 | 73.47 – 90.90 | <.001 |
| BMI | 0.91 | 0.76 – 1.05 | <.001 |
| Alder | 1.14 | 1.01 – 1.30 | <.001 |
| Fødeland | |||
| Sverige | ref | ||
| Norden | 3.0 | 2.0 – 4.1 | <.001 |
| Europa | 2.1 | 1.5 – 2.7 | <.001 |
| Observations | 150 | ||
| R2 / adj. R2 | .837 / .832 |
Vi ser at det finnes koeffisienter (Estimate) for Norden og Europa, men for Sverige står bare teksten "ref". Dette skyldes at kategorien Sverige er referansekategori, som Norden og Europa sammenlignes med. Effektene som presenteres for Norden og Europa, er altså i sammenligning med Sverige. Da blir tolkningen slik:
- For hver enhet BMI øker, øker blodtrykket med 0,91 enheter, og dette er statistisk signifikant.
- For hvert år man blir eldre, øker blodtrykket med 1,14 enheter, og dette er statistisk signifikant.
- Sammenlignet med svensker har personer født i Norden 3,0 enheter høyere blodtrykk. Dette er statistisk signifikant (p<0,001), og den sanne verdien ligger mellom 2,0 og 4,1 enheter lavere blodtrykk.
- Sammenlignet med svensker har personer født i Europa 2,1 enheter høyere blodtrykk. Dette er statistisk signifikant (p<0,001), og den sanne verdien ligger mellom 1,5 og 2,7 enheter lavere blodtrykk.