
Korrelasjon er ikke regresjon
Å undersøke sammenhengen (assosiasjonen, relasjonen) mellom to eller flere variabler er vanlig i all forskning og analyse. I dette tilfellet er begrepene sammenheng, assosiasjon og relasjon synonymer. Eksempler på sammenhenger som kan undersøkes, er sammenhengen mellom kolesterol og hjerteinfarkt, eller mellom BMI (Body Mass Index) og blodsukker. Når man har kartlagt assosiasjonen mellom variabler, kan følgende spørsmål besvares:
- Finnes det en relasjon mellom variablene?
- Hvor sterk er relasjonen mellom variablene?
- Hvordan ser relasjonen ut?
For å studere assosiasjoner mellom variabler brukes oftest korrelasjon og regresjon. Med korrelasjon kan man studere hvor sterk en lineær sammenheng mellom to variabler er. Regresjon er et kraftigere verktøy; med regresjon kan man nemlig studere hvor sterk sammenhengen er, man kan studere flere enn to variabler samtidig, og man kan bruke resultatet til å predikere (gjøre prediksjoner). Å predikere innebærer at man bruker en statistisk modell til å forutsi verdien av en variabel med ukjent verdi, ut fra variabler med kjente verdier. Variabler som brukes til å predikere, kalles prediktorer. Variabelen som skal predikeres, betegnes matematisk med og har flere synonymer, f.eks. utfall, utfallsmål, outcome, avhengig variabel, label osv.
Anta at vi studerer relasjonen mellom BMI (Body Mass Index) og blodsukker. Med korrelasjon kan vi klarlegge hvor sterk relasjonen mellom BMI og blodsukker er. Med regresjon kan vi, i tillegg til å uttale oss om relasjonens styrke, også beskrive hvordan sammenhengen ser ut og lære å predikere (forutsi) blodsukker for ulike verdier av BMI.
Korrelasjon og regresjon: kausalitet eller assosiasjon?
Kausalitet har vært diskutert tidligere. Se kapitlet Kausal inferens (kausalitet) for detaljer.
Begrepet kausalitet er sentralt i all forskning og analyse. En kausal sammenheng mellom to faktorer innebærer at den ene faktoren påvirker den andre. Det finnes altså en årsak og virkning mellom faktorene. Det finnes en kausal sammenheng mellom LDL-kolesterol og risikoen for koronarsykdom. Det innebærer at etter hvert som LDL-kolesterolet stiger, øker risikoen for koronarsykdom. Sammenhengen mellom LDL-kolesterol og koronarsykdom er altså kausal. Som diskutert i kapitlet Kausal inferens (kausalitet) er dette temaet temmelig komplisert. Det sentrale teoremet er at en matematisk assosiasjon (enten den er påvist med korrelasjon, regresjon eller machine learning) ikke nødvendigvis er kausal. Alle assosiasjoner skal tolkes med forsiktighet, og vurderingen av at en sammenheng er kausal, skal baseres på omfattende, multidisiplinær og reproduserbar vitenskap.
Et eksempel på en ikke-kausal sammenheng følger:
Anta at vi undersøker sammenhengen mellom gule fingre og risikoen for lungekreft. Vi undersøker 5000 personer og graderer fingrene deres fra 0 til 50 med hensyn til hvor gule fingrene er, og vi oppdager at jo gulere fingre, desto høyere risiko for lungekreft. I dette tilfellet er sammenhengen mellom gule fingre og lungekreft ekte, dvs. det finnes en matematisk bekreftet sammenheng. Gule fingre er imidlertid ikke årsaken til lungekreft; det er mer sannsynlig at personer med gule fingre røyker, og jo mer man røyker, desto gulere blir fingrene. Det er røyking som forklarer både gule fingre og lungekreft. Selv om gule fingre ikke var årsaken til kreften, er det likevel viktig å klarlegge sammenhengen, fordi (1) gule fingre kan brukes klinisk til screening og (2) gule fingre kan lede oss til den virkelige årsaken til kreften.
Korrelasjon og korrelasjonskoeffisienten
En korrelasjon omfatter to variabler (heretter og ). Disse variablene behandles likt, i den forstand at ingen av dem betraktes som prediktor eller utfall (outcome). Korrelasjonen mellom og representerer sammenhengen mellom variablene. Korrelasjonen går fra –1 til +1, og denne verdien, som kalles korrelasjonskoeffisienten, har ingen enhet. Hvis korrelasjonskoeffisienten er +1, indikerer det en perfekt positiv lineær sammenheng mellom og . Hvis koeffisienten i stedet er –1, indikerer det en perfekt negativ lineær sammenheng mellom og . Hvis korrelasjonskoeffisienten er 0, finnes det ingen sammenheng mellom og .
Vi skal nå visualisere og beregne korrelasjonen for to variabler i mtcars-dataene. For å visualisere korrelasjonen og beregne korrelasjonskoeffisienten bruker vi pakken ggpubr, som har funksjonen ggscatter(). Kommentarene nedenfor forklarer argumentene.
library(tidyverse)
data("mtcars")

library(ggpubr)
ggscatter(mtcars,
          x = "wt",
          y = "mpg",
          size = 3,
          add = "reg.line",
          cor.coef = TRUE,
          cor.coeff.args = list(method = "pearson", label.x = 3, label.sep = "\n"))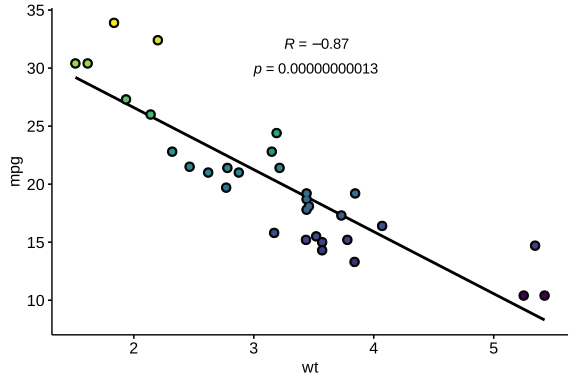
Korrelasjonskoeffisienten var -0,87. Det er en sterk negativ sammenheng. Merk at linjen i grafen ovenfor er en regresjonslinje. Korrelasjoner resulterer ikke i linjer gjennom dataene.
Vi kan generere en korrelasjonsmatrise for mange variabler samtidig med funksjonen ggpairs() i pakken GGally. Koden og resultatet er som følger:
library(GGally)
ggpairs(mtcars,
        # Hvilke kolonner?
       columns = 1:4,
       ggplot2::aes(colour=factor(am)))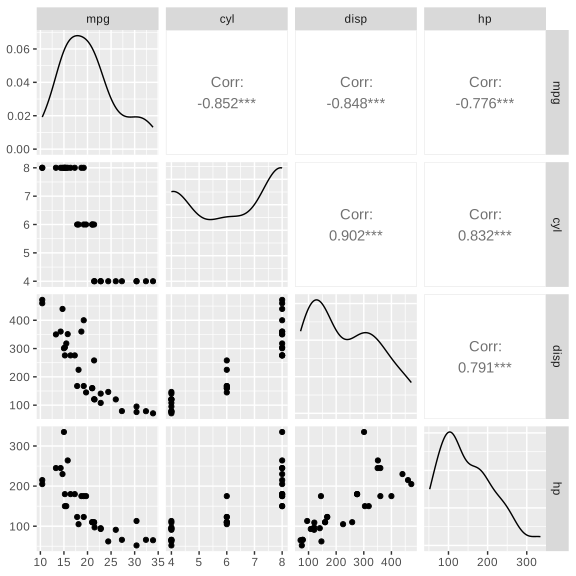
Korrelasjonskoeffisienten er et mål på den lineære sammenhengen mellom X og Y. Koeffisienten kan maksimalt være –1 eller +1, avhengig av om sammenhengen er henholdsvis negativ eller positiv. Jo nærmere korrelasjonen er 0, desto svakere er sammenhengen. Jo nærmere korrelasjonen er –1 eller +1, desto sterkere er sammenhengen. Hvis korrelasjonskoeffisienten er 0, fører en endring i X ikke til en endring i Y.
Pearsons korrelasjonskoeffisient
Korrelasjonskoeffisienten må beregnes ut fra dataene. Det finnes flere alternativer for å beregne koeffisienten. Den mest populære korrelasjonskoeffisienten er Pearson’s Product-Moment Coefficient of Correlation, eller bare Pearsons korrelasjonskoeffisient. Denne forkortes med bokstaven r. Pearsons korrelasjonskoeffisient fås ved å dividere kovariansen til variablene og med produktet av standardavvikene deres.
Kovarians og korrelasjon
Kovarians minner om korrelasjon. Kovarians er et mål på samvariasjonen mellom to variabler (, ) (dvs. hvordan og samvarierer). Hvis høyere verdier av X tilsvarer høyere verdier av Y, og omvendt, finnes det en samvariasjon mellom og . Positiv kovarians innebærer at høyere verdier av tilsvarer høyere verdier av . Negativ kovarians innebærer det motsatte.
Kovarians er den lineære samvariasjonen mellom og , noe som minner mye om korrelasjonen mellom og . Kovarians er imidlertid vanskeligere å tolke og sammenligne. For eksempel kan man ikke sammenligne om kovariansen mellom alder og kroppsvekt er like sterk som kovariansen mellom alder og høyde, fordi kovariansen er skalaavhengig (hvis variablene ikke har samme skala, kan de ikke sammenlignes). Løsningen på problemet er å normalisere kovariansen. Dette gjøres ved å dividere kovariansen med en faktor som representerer skalaen og variasjonen i og . Dette gir en verdi som går fra –1 til +1 uansett hvilke variabler man undersøker. Det gjør det også mulig å sammenligne korrelasjoner mellom variabler. For Pearsons korrelasjonskoeffisient er denne faktoren altså produktet av variablenes (, ) standardavvik.
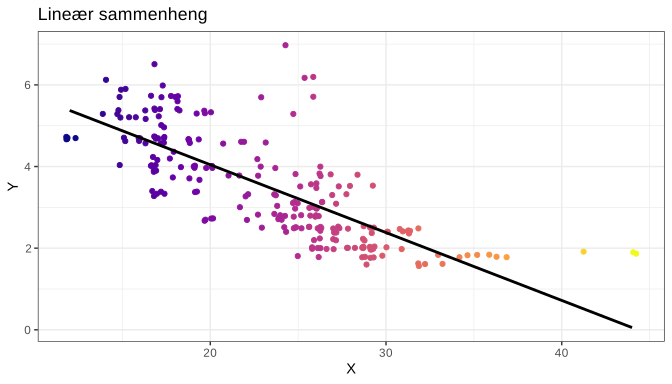
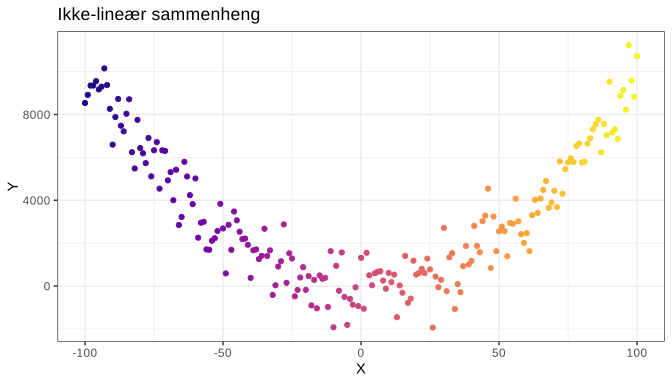
Pearsons korrelasjonskoeffisient bygger på antakelsen om at og er normalfordelte og at sammenhengen mellom og er lineær. Pearsons metode er altså parametrisk (den krever at variablene er normalfordelte). Figuren nedenfor viser henholdsvis en lineær og en ikke-lineær sammenheng.
Spearman rank correlation coefficient (Spearmans korrelasjonskoeffisient)
Hvis variablene ( og ) ikke oppfyller antakelsene ovenfor, finnes det ikke-parametriske metoder (dvs. de krever ikke normalfordeling). Den mest brukte ikke-parametriske metoden er Spearman rank correlation coefficient, eller bare Spearmans korrelasjonskoeffisient. Med denne metoden sammenlignes i stedet rangeringen av og . Ved å bruke rangering blir beregningen mer robust hvis sammenhengen ikke er lineær. Rangeringen reduserer også betydningen av eventuelle outliers (ekstremverdier).
Hvis antakelsene for Pearsons korrelasjonskoeffisient er oppfylt, bør man ikke bruke Spearmans korrelasjon, fordi den er mindre effektiv, noe som innebærer at Pearsons har større mulighet til å oppdage en sammenheng (hvis en slik finnes).
Man kan også transformere eller (eller begge) hvis de ikke oppfyller Pearsons antakelser. Transformasjonen kan for eksempel gjøres ved at en eller begge variabler logaritmeres. Dette kan ofte føre til at Pearsons antakelser blir oppfylt. Transformasjonen påvirker ikke Spearmans korrelasjonskoeffisient, fordi denne bare bruker variablenes rangering, som ikke påvirkes av transformasjonen.
Hvordan undersøker jeg om variablene er normalfordelte?
Svar: Lag et histogram for hver variabel.
Hvordan undersøker jeg om relasjonen mellom og er lineær?
Svar: Spredningsdiagrammer kan brukes til å undersøke (visuelt) hvordan relasjonen ser ut.
Eksempel i R
Aktiver tidyverse og last inn diamonds-dataene, som inneholder informasjon om ulike diamanter.
library(tidyverse)
data(diamonds)
Lag deretter et spredningsdiagram med pris (price) på x-aksen, karat (carat) på y-aksen, og farg punktene etter slipingen (cut).
ggplot(diamonds,
       aes(x=price, y=carat, color=cut)) +
  geom_point() +
  theme_bw()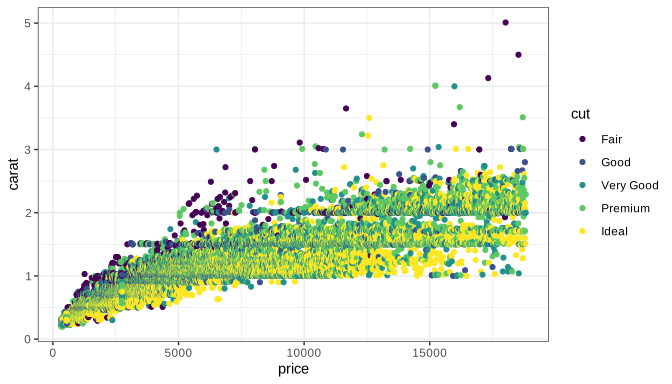
## Hvor sterk er korrelasjonen etter Pearsons metode
cor(tabell$price, tabell$carat, method="pearson")[1] 0.9215913## Hvor sterk er korrelasjonen etter Spearmans metode
cor(tabell$price, tabell$carat, method="spearman")[1] 0.9628828Visuell vurdering av relasjonen
Man bør alltid gjøre en visuell vurdering av en korrelasjon. Et spredningsdiagram er utmerket til dette, særlig hvis en regresjonslinje kan visualiseres i grafen. Grunnen til at en visuell vurdering er viktig, er at selve korrelasjonskoeffisienten ikke karakteriserer sammenhengen mellom variablene.
Korrelasjonskoeffisienten er altså et oppsummerende mål og skal derfor aldri erstatte en visuell vurdering av relasjonen mellom og .