
Logistisk regresjon
Synonym: logit regression, logit model
Med lineær regresjon kan vi undersøke kontinuerlige utfall (), for eksempel kroppsvekt, blodtrykk, inntekt eller pris. Lineær regresjon bør imidlertid ikke brukes til å studere binære utfall, det vil si utfall med to kategorier. Eksempler på binære utfall er slike som klassifiseres som ja/nei, 0/1, syk/frisk, god/dårlig, fornøyd/misfornøyd, lite/mye osv.
Det finnes flere grunner til at lineær regresjon ikke bør brukes til å studere verken binære utfall eller kategoriske utfall med flere enn 2 kategorier. Den første grunnen er konseptuell og kan demonstreres med et kategorisk utfall med tre nivåer. Anta at vi studerer sammenhengen mellom prediktoren og en diagnose , som kan ha én av følgende kategorier: hjerneslag, epilepsi eller Parkinsons sykdom. For å bruke lineær regresjon koder vi disse diagnosene med tallene 1 til 3. Vi definerer utfallet vårt slik:
Det er flere problemer med å definere utfallet på denne måten. Først og fremst hevder dette at det finnes en iboende rekkefølge mellom diagnosene, noe det ikke gjør i dette tilfellet. Dessuten innebærer det at vi hevder at forskjellen mellom hjerneslag og epilepsi (numerisk forskjell på 1) er like stor som forskjellen mellom epilepsi og Parkinsons sykdom (numerisk forskjell på 1), noe som er en irrasjonell sammenligning.
Dersom formålet med regresjonsmodellen er å studere hvordan ulike prediktorer () henger sammen med risikoen for disse diagnosene (Y), fører den lineære modellen til urimelige resultater. For å illustrere dette lager vi en lineær regresjon med data fra PimaIndiansDiabetes, som finnes i pakken mlbench. Pakken kan installeres med kommandoen install.packages("mlbench"). I PimaIndiansDiabetes er variabelen diabetes kodet som neg (negative) eller pos (positive), som vi koder om til henholdsvis 0 og 1 for å kunne gjøre lineær regresjon. I akkurat dette tilfellet lager vi den lineære regresjonen direkte i ggplot() (vanligvis brukes funksjonen lm()). Med ggplot() tegner vi et spredningsdiagram med glucose på x-aksen og diabetes på y-aksen, deretter bruker vi geom_smooth() for å lage en lineær regresjon i dataene.
library(mlbench)
data("PimaIndiansDiabetes")

## Koder om diabetes til 0 / 1
PimaIndiansDiabetes$diabetes <- ifelse(PimaIndiansDiabetes$diabetes=='pos', 1, 0)

## Lineær regresjonsmodell
PimaIndiansDiabetes %>%
  ggplot(aes(glucose, diabetes)) +
  geom_point(alpha = 0.5, size=3) +
  geom_smooth(method = "lm") +
  labs(title = "Linjär regression med binärt utfall",
       x = "Glucose",
       y = "Sannolikhet för diabetes")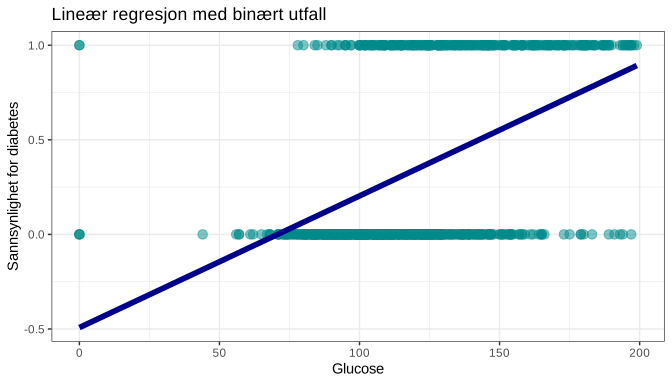
Grafen ovenfor er problematisk. Først og fremst predikerer modellen negative sannsynligheter ved glucose <75. En sannsynlighet kan aldri være negativ. Dessuten ville modellen predikere en sannsynlighet >1 ved høye verdier (>200) av glucose. En sannsynlighet kan aldri overstige 1,0. Det er dermed tydelig at lineær regresjon er uegnet for kategoriske utfall.
Den matematiske løsningen på problemet ovenfor er å lage en regresjonsmodell som alltid gir en prediksjon mellom 0 og 1, uavhengig av verdien på prediktoren . For å gjøre dette må utfallet håndteres som en sannsynlighet (, probabilitet), som alltid ligger mellom 0 og 1. Dette kan oppnås med funksjonen logit eller log odds :
I formelen ovenfor er ekvivalent med odds for utfallet. For å forstå den videre diskusjonen er begrepet odds viktig.
Odds
Odds er sentralt i logistisk regresjon. I en logistisk regresjon er utfallet binært (0/1). Vi kan betrakte dette som en situasjon der en hendelse kan utebli (0) eller inntreffe (1). Den logistiske modellen beregner odds for at hendelsen skal inntreffe. Odds er sannsynligheten for at noe skal inntreffe delt på sannsynligheten for at det ikke skal inntreffe. Nedenfor vises odds for et utfall definert som ja/nei, der er sannsynligheten.
Dette er ekvivalent med:
Eksempel 1: Hva er oddsen for å få et partall (2, 4 eller 6) ved ett terningkast?
Svar: En terning har seks tall (1, 2, 3, 4, 5, 6). Sannsynligheten for å få 2, 4 eller 6 er 3/6. Sannsynligheten for ikke å få 2, 4 eller 6 er også 3/6. Odds beregnes slik:
En odds på 1,0 innebærer at det er like stor sjanse for at utfallet inntreffer som for at utfallet ikke inntreffer.
Eksempel 2: Hva er oddsen for å få ett av tallene 1, 2, 3 eller 4 ved ett terningkast?
Svar: Sannsynligheten for å få 1, 2, 3 eller 4 er 4/6, og sannsynligheten for et annet resultat er 2/6. Odds beregnes som:
Oddsen er dermed 2,0, noe som innebærer at det er dobbelt så høy sannsynlighet for at hendelsen skal inntreffe, sammenlignet med at den ikke skal inntreffe.
Vi går nå tilbake til diskusjonen om logit.
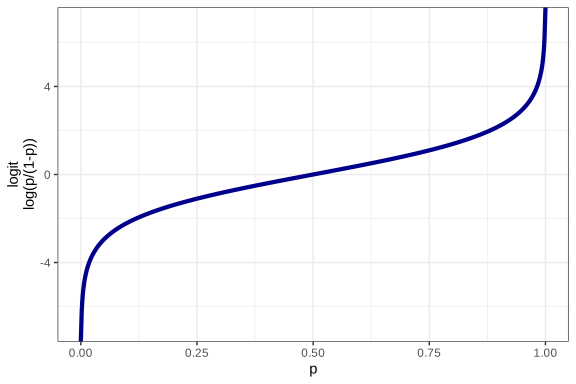
I figuren nedenfor visualiseres mot logit (log odds). Figuren viser at sannsynligheter kan oversettes til hvilken som helst odds ved hjelp av logit.
Vi kan beregne sannsynligheter ut fra log odds ved hjelp av den logistiske funksjonen (logistic function):
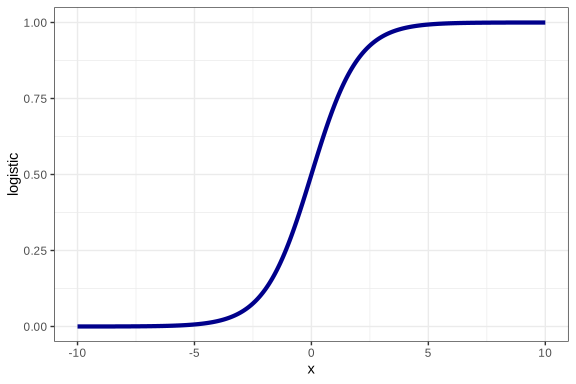
Denne formelens funksjon kan visualiseres som vist i figuren nedenfor. Merk at sannsynligheten (y-aksen) ligger mellom 0 og 1, uavhengig av verdien på prediktoren .
Ved å bruke logit til å transformere sannsynligheten får vi en verdi som kan predikeres med en lineær ligning, slik:
Logit-funksjonen gjør det altså mulig å koble til . Logit kan derfor betraktes som en linkfunksjon (link function). I logistisk regresjon er altså logaritmen av odds en lineær funksjon av prediktorene.
Dersom denne funksjonen brukes på de samme dataene som ovenfor (prediksjon av diabetes), får regresjonsmodellen følgende funksjon:
PimaIndiansDiabetes %>%
  ggplot(aes(glucose, diabetes)) +
  geom_point(alpha = 0.5) +
  geom_smooth(method = "glm", method.args = list(family = "binomial")) +
  labs(title = "Logistisk regression med binärt utfall",
       x = "Glucose",
       y = "Sannolikhet för diabetes")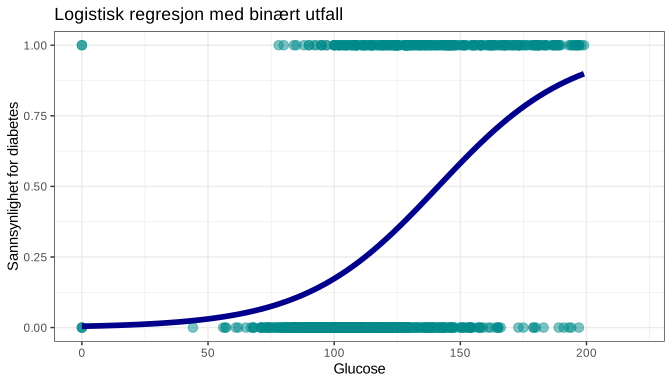
Denne modellen vil alltid gi sannsynligheter mellom 0 og 1.
Tolkning av logistisk regresjon
Regresjonskoeffisienten () representerer hvordan logaritmen av odds for hendelsen endres når prediktoren øker med 1 enhet. Dette minner om lineær regresjon, der representerer hvordan endres når prediktoren øker med 1 enhet. Ved logistisk regresjon er det altså logaritmen av odds for hendelsen som endres.
Odds ratio (oddsratio)
Sannsynlighet (probabilitet) er et vanskelig begrep å forstå. Å tolke logaritmerte sannsynligheter er enda vanskeligere. Derfor transformerer vi regresjonskoeffisienten ved å eksponensiere den og dermed lage en oddsratio (odds ratio, OR). Odds ratio er betydelig enklere å tolke. Eksempel følger:
- For prediktoren får vi en regresjonskoeffisient på 0,5, noe som innebærer at når prediktoren øker med 1 enhet, øker logaritmen av odds for at hendelsen skal inntreffe med 0,5.
- Vi eksponensierer koeffisienten:
- Dette innebærer at når prediktoren øker med 1 enhet, øker odds for hendelsen med 65 %.
Man kan altså omregne en oddsratio til prosent! Dette gjøres med formelen: .
Eksempel 1: Odds ratio = 1,10 Beregning: 100•(1,10 – 1) = 10 %. Tolkning: For hver enhet prediktoren X øker, øker odds for hendelsen med 10 %.
Eksempel 2: Odds ratio = 0,90 Beregning: 100•(0,9 – 1) = –10 %. Tolkning: For hver enhet prediktoren X øker, reduseres odds for hendelsen med 10 %.
En odds ratio (oddsratio) på 1,0 innebærer at prediktoren ikke har noen sammenheng med , fordi en økning/reduksjon av ikke påvirker odds for hendelsen . Hvis odds ratio er større enn 1,0, øker odds for hendelsen, og hvis odds ratio er mindre enn 1,0, reduseres odds for hendelsen. Odds ratio på 1,50 innebærer 50 % økt odds, og odds ratio 0,5 innebærer 50 % redusert odds.
Når man bruker odds ratio, er den prosentvise endringen i odds den samme hver gang prediktoren øker med 1 enhet. Dette skyldes at den logistiske regresjonen forutsetter at forholdet mellom og log(odds) er lineært.
Eksempel på logistisk regresjon
Vi lager en logistisk regresjon med data fra PimaIndiansDiabetes, som finnes i pakken mlbench. Installer pakken med kommandoen install.packages("mlbench"). I dataene er variabelen diabetes kodet som pos (positive) eller neg (negative). Den logistiske regresjonen lages ved hjelp av funksjonen glm(), som finnes i grunninstallasjonen av R. GLM står for generalized linear model, som estimerer lineære modeller ved hjelp av en linkfunksjon (link function). I logistisk regresjon er log odds (logit) linkfunksjonen. Modellen spesifiseres slik:
diabetes="pos" ~ glucose + ageinnebærer at det er kategorien "pos" vi vil predikere ved hjelp av variablene glucose og age.family = binomial(link = logit)spesifiserer hvilken linkfunksjon GLM skal bruke.
library(mlbench)
data("PimaIndiansDiabetes")

min_modell <- glm(diabetes=="pos" ~ glucose + age,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)
Resultatet av modellen med base R-funksjonen summary():
summary(min_modell)Call:
glm(formula = diabetes == "pos" ~ glucose + age, family = binomial(link = logit),
data = PimaIndiansDiabetes)
Deviance Residuals:
Min 1Q Median 3Q Max
-2.3367 -0.7775 -0.5087 0.8367 3.1630
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -5.912449 0.462620 -12.78 < 0.0000000000000002 ***
glucose 0.035644 0.003290 10.83 < 0.0000000000000002 ***
age 0.024778 0.007374 3.36 0.000778 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Dispersion parameter for binomial family taken to be 1)
Null deviance: 993.48 on 767 degrees of freedom
Residual deviance: 797.36 on 765 degrees of freedom
AIC: 803.36
Number of Fisher Scoring iterations: 4Under overskriften Coefficients presenteres regresjonskoeffisientene. Begge koeffisientene (se Estimate for glucose og age) er positive (>0). Dessuten er p-verdiene <0,005, noe som innebærer at koeffisientene er statistisk signifikante.
I en vitenskapelig publikasjon er man som oftest interessert i å presentere odds ratio (OR) med 95 % konfidensintervall. For å gjøre dette bruker vi funksjonen tidy fra pakken broom. Husk at koeffisienten er log odds for Y, noe som innebærer at koeffisienten må eksponensieres for å få odds ratio. Med kommandoen nedenfor ber vi om både eksponensiering og 95 % konfidensintervall:
library(broom)
tidy(min_modell, exponentiate=T, conf.int=T)
## A tibble: 3 × 7
term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 0.00271 0.463 -12.8 2.11e-37 0.00106 0.00653
2 glucose 1.04 0.00329 10.8 2.37e-27 1.03 1.04
3 age 1.03 0.00737 3.36 7.78e- 4 1.01 1.04Resultatet ovenfor tolkes slik:
- Estimate er odds ratio for hendelse Y.
- Når glucose øker med 1 enhet, øker risikoen for diabetes med 4 %.
- Når age øker med 1 enhet, øker risikoen for diabetes med 3 %.
- conf.low og conf.high angir et 95 % konfidensintervall. Med 95 % sikkerhet ligger odds ratio mellom 1,03 og 1,04 for glucose, noe som innebærer at 1 enhets økning i glucose med 95 % sikkerhet gir 3 % til 4 % høyere sannsynlighet for diabetes.
Modelldiagnostikk kan fås effektivt med funksjonen check_model() fra pakken easystats:
library(easystats)
check_model(min_modell)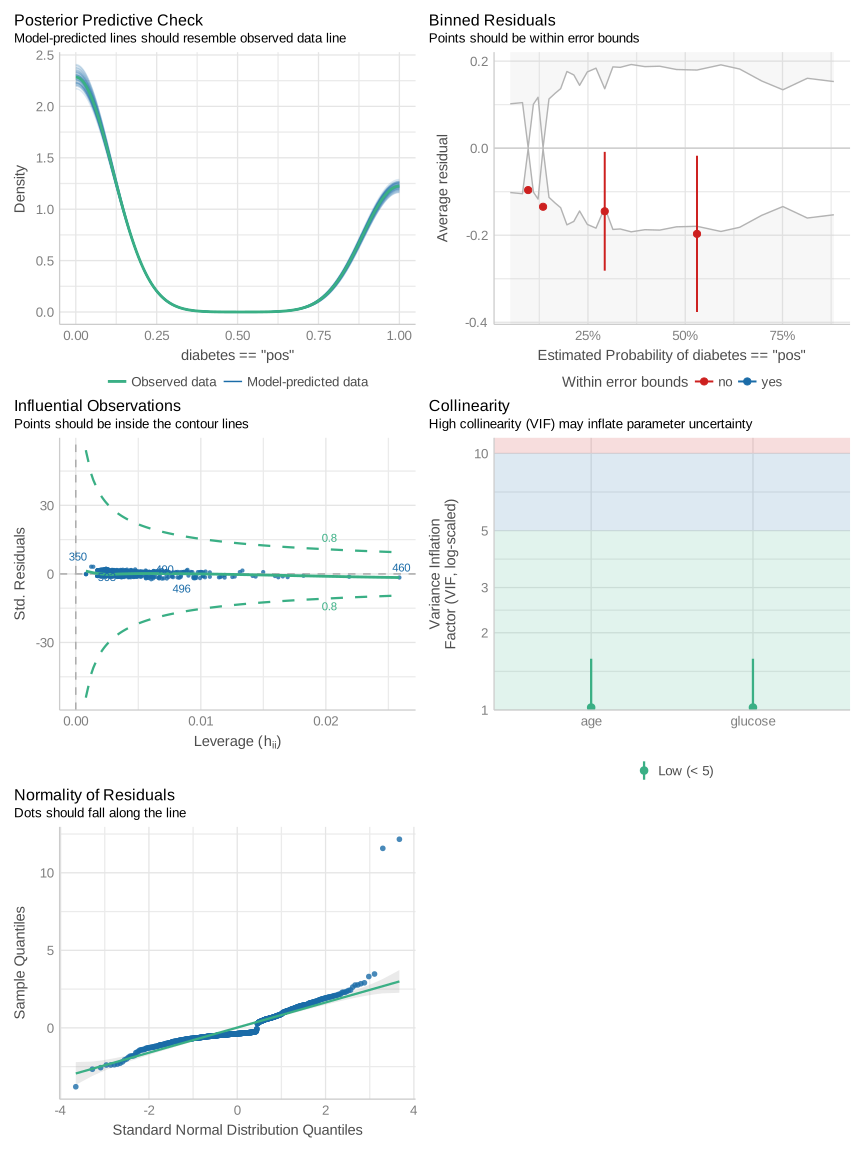
Predikere med logistisk regresjon
Vi kan gjøre prediksjoner med regresjonsmodellen ved hjelp av funksjonen predict(). Her følger to eksempler der vi predikerer for én enkelt person ved å lage en ny dataframe med personens verdi for glucose og age:
## Definer en ny observasjon og kall objektet "new_patient"
new_patient = data.frame(age=50,
                         glucose=150)

## Prediker sannsynligheten for diabetes
predict(min_modell, newdata=new_patient, type="response")0.00422564Tallet ovenfor er sannsynligheten () for at personen har diabetes.
ROC-kurve for modellen
Evaluering av modellens prediktive evne gjøres som regel ved hjelp av en ROC-kurve. Nedenfor lager vi tre varianter av modellen og sammenligner dem ved hjelp av ROC. Merk imidlertid at en sammenligning av ulike modeller helst bør gjøres med en eller annen form for resampling, fortrinnsvis kryssvalidering (se kapittelet Evaluere og sammenligne modeller).
## En modell med glucose og age
min_modell_1 <- glm(diabetes=="pos" ~ glucose + age,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

## En modell med glucose, age, insulin og pressure
min_modell_2 <- glm(diabetes=="pos" ~ glucose + age + insulin + pressure,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

## En modell med alle tilgjengelige prediktorer i dataene
## Punktum (.) er en snarvei for "alle prediktorer"
min_modell_3 <- glm(diabetes=="pos" ~ .,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

library(easystats)
plot(performance_roc(min_modell_1, min_modell_2, min_modell_3))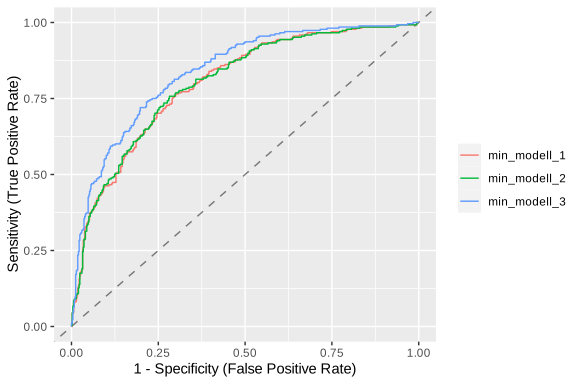
Multippel logistisk regresjon
Som det fremgår av eksemplene ovenfor, kan man ta med flere prediktorer i den logistiske modellen, og den aksepterer både kategoriske og kontinuerlige prediktorer. Dersom modellen inneholder flere prediktorer, tolkes koeffisienten for hver enkelt prediktor som dens "effekt" når de øvrige prediktorene holdes konstante. "Effekten" av prediktoren er dermed den som observeres når det justeres for de øvrige prediktorene i modellen.
Maximum Likelihood Estimation (MLE): Beregning av regresjonskoeffisienter i logistisk regresjon
Husk at den lineære modellen har en enkel formel for å finne modellens parametere (intercept og regresjonskoeffisienter). Ligningen er den regresjonslinjen som best beskriver dataene. Dette gjøres ved å minimere summen av alle feilledd (errors) (se Lineær regresjon). For logistisk regresjon finnes det ingen enkel ligning å løse. I stedet må programvaren finne parameterne ved hjelp av optimeringsfunksjoner (optimizer functions). Den vanligste metoden for å gjøre dette er MLE (maximum likelihood estimation).
Maximum likelihood estimation (MLE, sannsynlighetsmaksimeringsmetoden) brukes generelt til å beregne parameterne i en sannsynlighetsfordeling. Metoden velger de parameterne som maksimerer sannsynligheten for å få de observerte utfallene. Metoden krever at en sannsynlighetsfordeling for brukes, som er Bernoulli-fordelingen når det gjelder logistisk regresjon. Gitt denne fordelingen kan en likelihood-funksjon beregnes for de observerte dataene. Funksjonen kan deretter optimeres for å finne parameterne som best beskriver dataene. Den nøyaktige beregningen av disse parameterne ligger utenfor rammen av dette kurset.