
Regresjon
Med regresjon undersøker man sammenhengen (assosiasjonen) mellom to eller flere variabler. I en regresjonsanalyse predikeres én variabel () av minst én prediktor (). Rent terminologisk sier man at er avhengig av ; er derfor den avhengige variabelen, og er den uavhengige variabelen.
| Oppgave i modellen | Synonym | |
|---|---|---|
| Y | Variabelen som skal predikeres | Avhengig variabel, dependent variable, outcome, utfall, utfallsmål, label, target |
| X | Brukes til å predikere Y | Prediktor, predictor, feature, kovariat, covariate |
Tenk deg at vi undersøker sammenhengen mellom BMI (body mass index) og blodsukker. Med regresjon kan vi bruke den ene variabelen til å predikere verdien av den andre. I dette tilfellet brukes BMI til å predikere blodsukker. BMI er altså uavhengig (prediktor), og glukose er avhengig (outcome).
Vi skal illustrere lineær regresjon med data fra pimaindianere, som har svært høy risiko for diabetes. Data fra pimaindianere finnes i pakken mlbench. Installer mlbench og aktiver pakken, samt dataene med pimaindianere, med følgende kommando:
library(mlbench)
data(PimaIndiansDiabetes)

## Graf med sammenhengen mellom mass og glucose
ggplot(data=PimaIndiansDiabetes,
       aes(x=mass, y=glucose, color=diabetes)) +
  geom_point() +
  geom_smooth()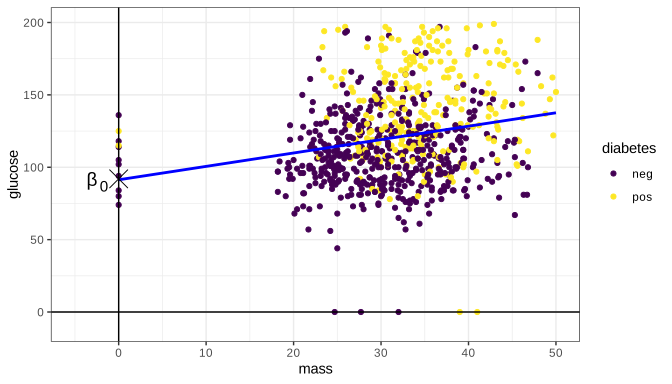
Figuren over viser hvordan BMI (mass) er assosiert med blodsukker (glucose). I grafen ser man en rett blå linje som utgjør regresjonslinjen for mass. Sammenhengen mellom mass og glucose kan beskrives med en enkel formel.
- er interceptet, det vil si punktet der regresjonslinjen krysser Y-aksen (se figuren over).
- er koeffisienten for
mass, det vil si verdien av regresjonslinjens stigningstall. - er differansen mellom modellens predikerte verdi av og den observerte verdien av . Dette er altså modellens feil (error).
Oppsummert er dette en modell som predikerer ved hjelp av en regresjonslinje med stigningstall . Interceptet () er vi svært sjelden interessert i. Modellens feil () er et mål på hvor god modellen er.
Målet er å lage en regresjonslinje der stigningen tilpasses slik at den representerer sammenhengen mellom og . Linjens stigning avhenger av sammenhengen mellom mass og glucose. Stigningstallet for mass kalles også koeffisienten for mass. Hvis glucose øker med økende mass, vil regresjonslinjen ha en positiv stigning. I figuren over ser man at linjen har en positiv stigning, og derfor er koeffisienten for mass positiv.
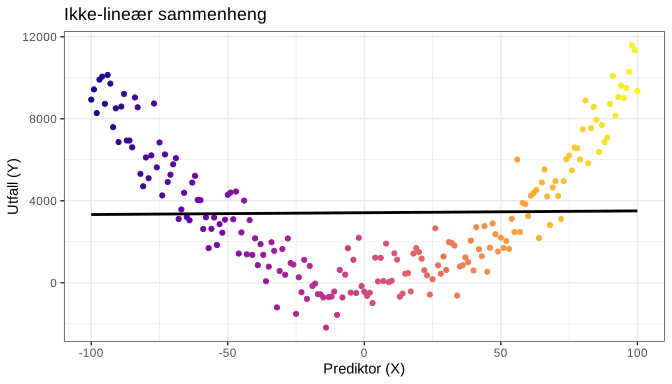
Merk at relasjonen mellom og må være lineær for at den lineære modellen skal kunne brukes. Hvis sammenhengen ikke er lineær, kan den lineære modellen bli misvisende. Her følger et eksempel på en ikke-lineær sammenheng mellom og . Den beregnede regresjonslinjen klarer ikke å fange opp sammenhengen mellom og .
Vi fortsetter med å lage en lineær regresjonsmodell i R. Dette gjøres med funksjonen lm(), som finnes i base R (du trenger ikke å installere noen pakke).
modell <- lm(glucose ~ mass, data=PimaIndiansDiabetes)

summary(modell)Call:
lm(formula = glucose ~ mass, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-128.970 -20.756 -3.705 19.509 81.568
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 92.2129 4.7083 19.585 < 0.0000000000000002 ***
mass 0.8965 0.1429 6.274 0.000000000589 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.2 on 766 degrees of freedom
Multiple R-squared: 0.04887, Adjusted R-squared: 0.04763
F-statistic: 39.36 on 1 and 766 DF, p-value: 0.0000000005891Av resultatet over fremgår følgende:
- Interceptet er 92,2, noe som betyr at regresjonslinjen krysser Y-aksen ved Y=92,2, og det ser ut til å stemme med den grafiske undersøkelsen.
- , altså koeffisienten for mass, er 0,8965. Det betyr at hvis
massøker med 1 enhet, økerglucosemed 0,8965 enheter.
Beregning av regresjonslinjen
Grunnleggende for regresjonsanalyse er beregningen av regresjonslinjen. Den vanligste metoden er least-squares method (på norsk minste kvadraters metode). Least-squares kan også kalles ordinary least-squares. Metoden lager en linje som minimerer summen av error. I figuren nedenfor er de samme dataene som over (pimaindianerne) forstørret i intervallet 50 til 150 på x-aksen og y-aksen for å tydeliggjøre hva kvadratsummer er. I figuren nedenfor ser man også en regresjonslinje.
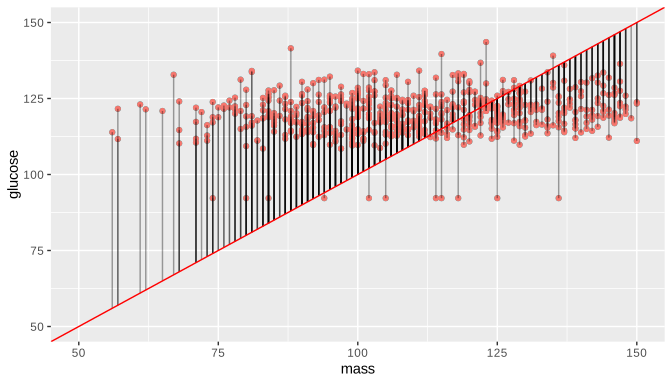
Least-squares har som mål å lage en regresjonslinje som minimerer summen av alle observasjonenes error. I figuren over fremgår det at avstanden fra regresjonslinjen til punktene varierer mye. I intervallet 100 til 140 på x-aksen ligger linjen nær punktene (error blir lite), men utenfor dette intervallet ligger linjen lenger unna punktene (error blir større). Metoden med kvadratsummer går ut på å minimere samlet (total) error. Linjen vippes frem og tilbake til stigningen minimerer summen av alle error. Før man legger sammen alle error, kvadreres de; hensikten med dette er at alle negative error (de som ligger under linjen) skal bli positive verdier. Summen av alle kvadrerte error kalles RSS (Residual Sum of Squares). Den lineære modellens oppgave er altså å finne og som minimerer RSS. Formelen for RSS er som følger:
Coefficient of determination: R2
For å estimere styrken på sammenhengen mellom og kan man bruke coefficient of determination, også kalt . Denne verdien går fra 0 til 1. Hvis er 0, finnes det ingen sammenheng, og hvis er 1, finnes det en perfekt sammenheng, noe som betyr at kan forklare hele variasjonen i .
Forutsetninger for regresjon med least-squares method
Følgende forutsetninger kreves for at least-squares skal kunne brukes:
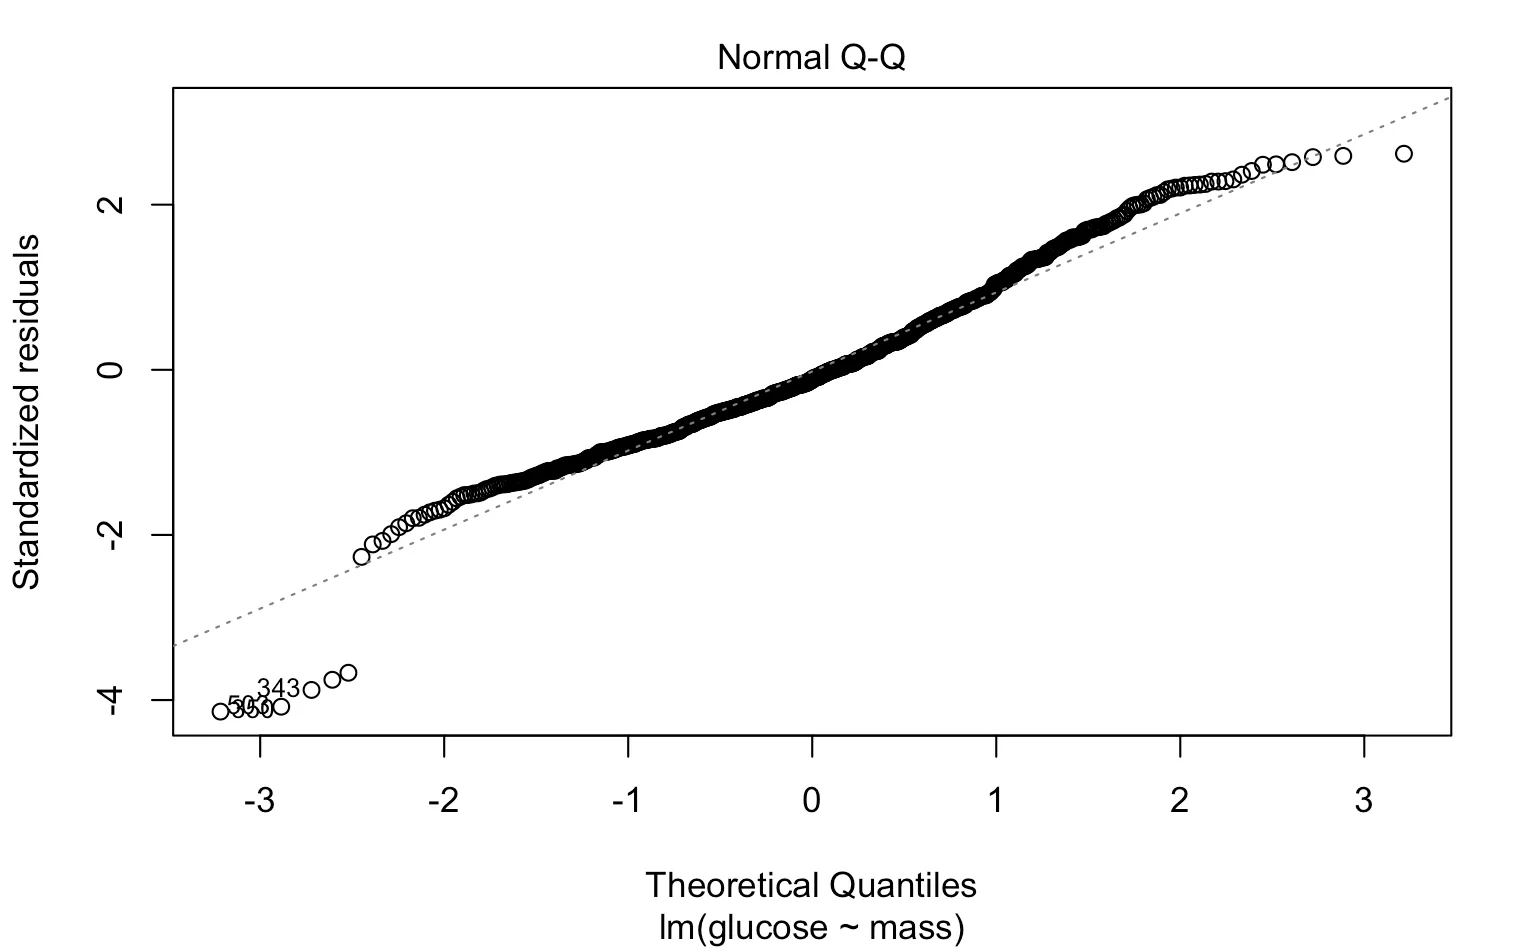
- Residualene skal være normalfordelte med gjennomsnitt 0. Dette kan kontrolleres med et såkalt quantile-quantile plot. I et quantile-quantile plot skal man se en rett linje dersom forutsetningen er oppfylt.
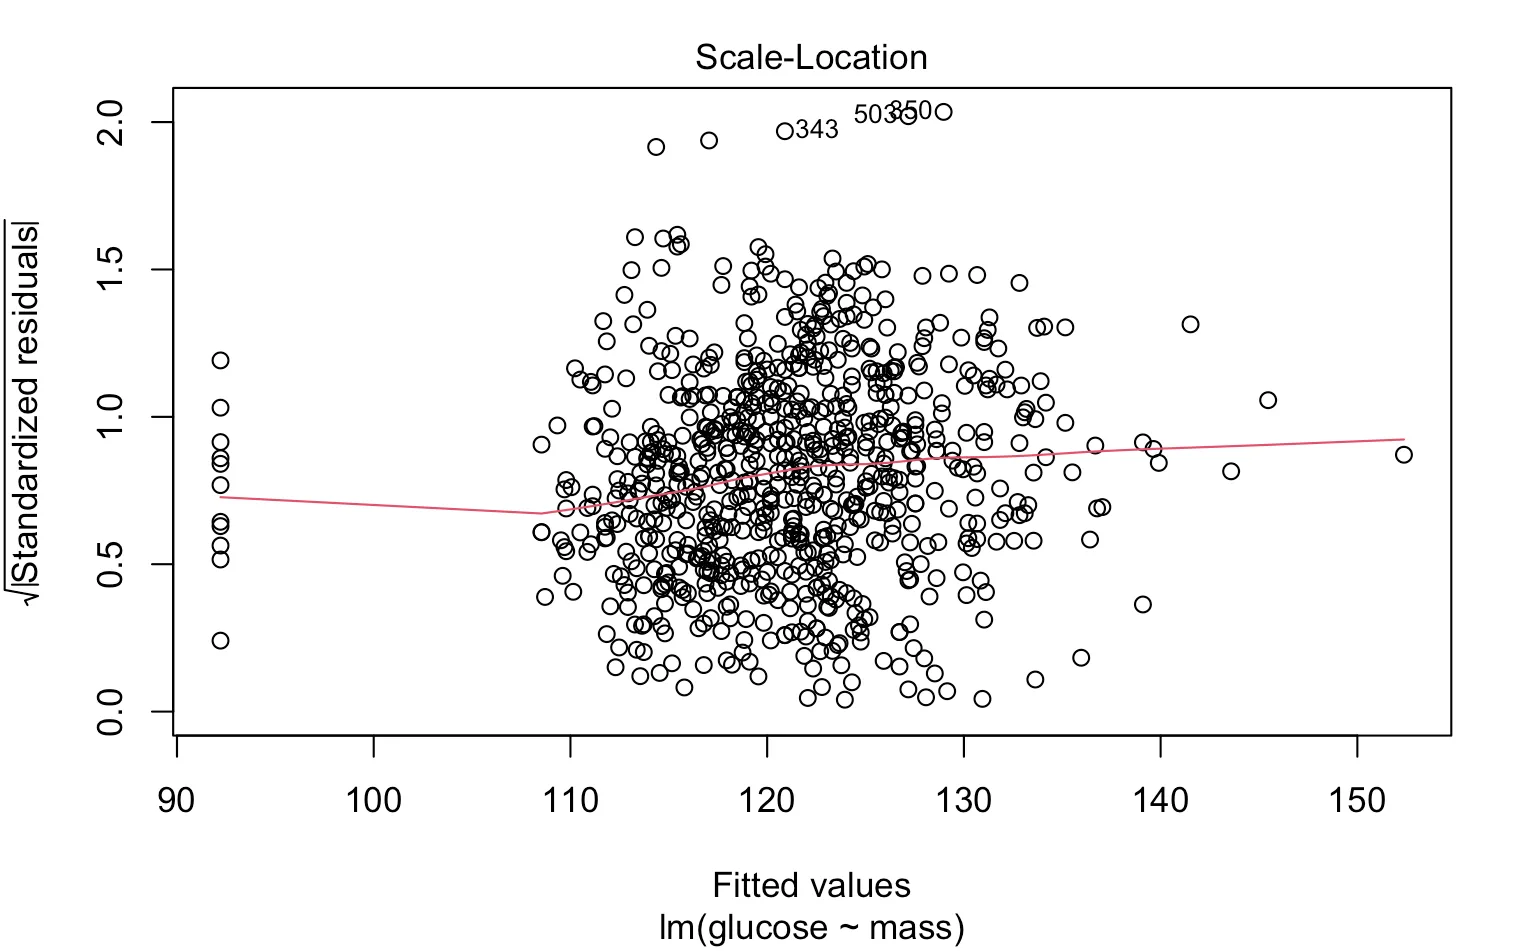
- Residualene skal ha konstant varians. Dette kan kontrolleres med et spredningsdiagram (scatterplot) med estimerte residualer mot fitted values. Spredningsdiagrammet skal vise en sky uten noen sammenheng mellom verdiene.
- Residualene skal være uavhengige av hverandre. Dette er sjelden et problem, med mindre samme person/celle/bakterie/enhet/etc. inngår flere ganger i studiepopulasjonen. Hvis samme person inngår flere ganger i studiepopulasjonen (for eksempel gjennom gjentatte målinger av BMI og glukose), er residualene for disse observasjonene avhengige av hverandre.
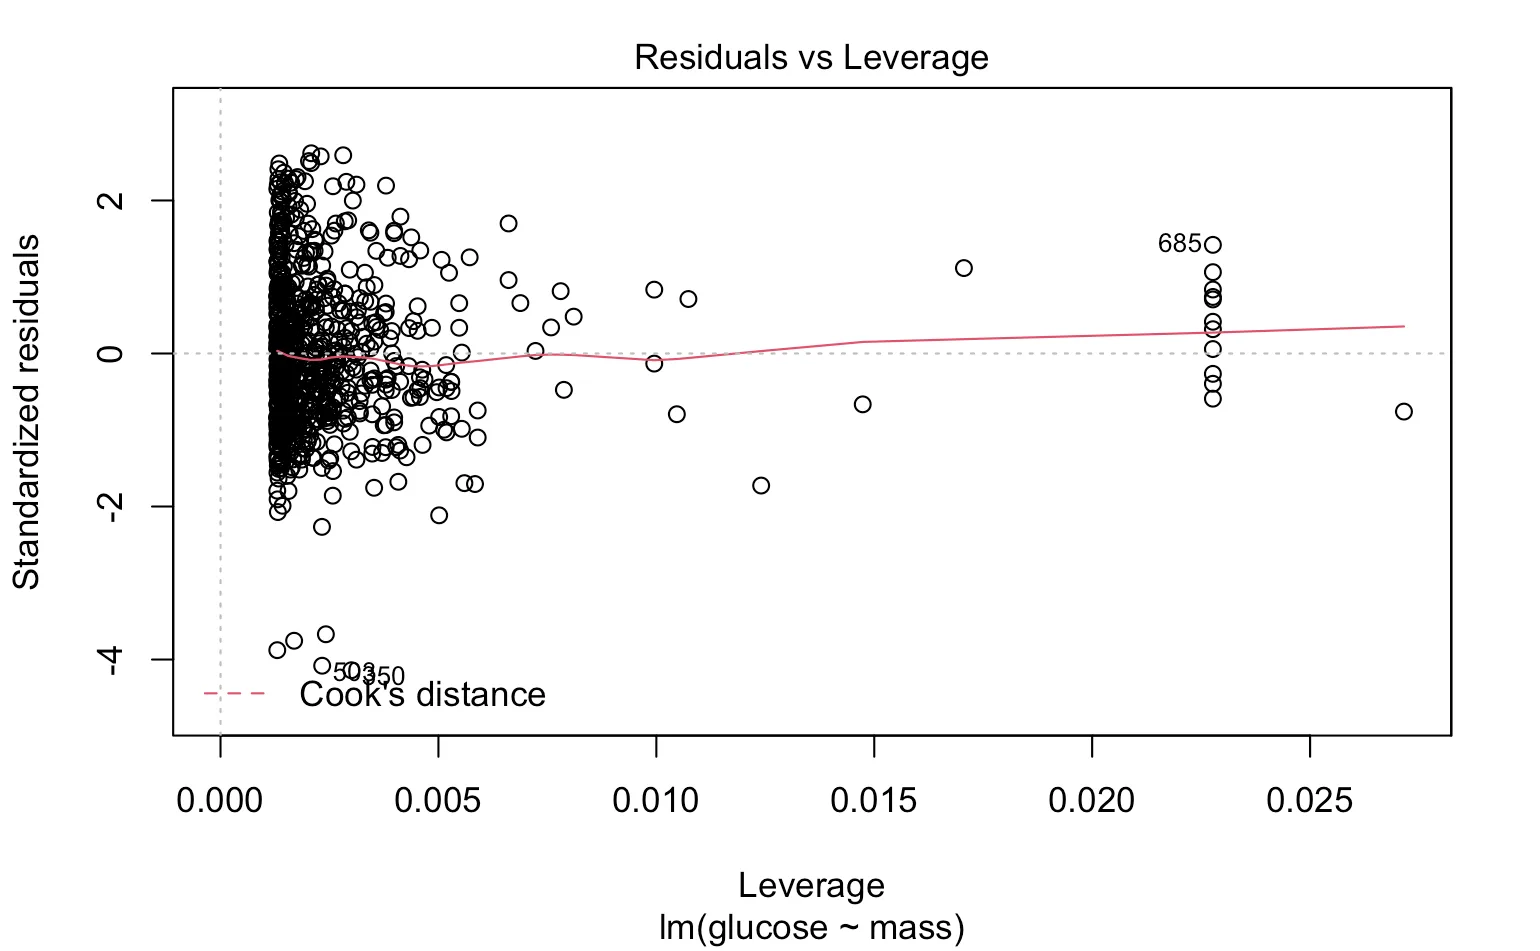
Punkt (1) og (2) kan enkelt undersøkes i R med følgende kommando, som returnerer alle nødvendige grafer:
plot(modell)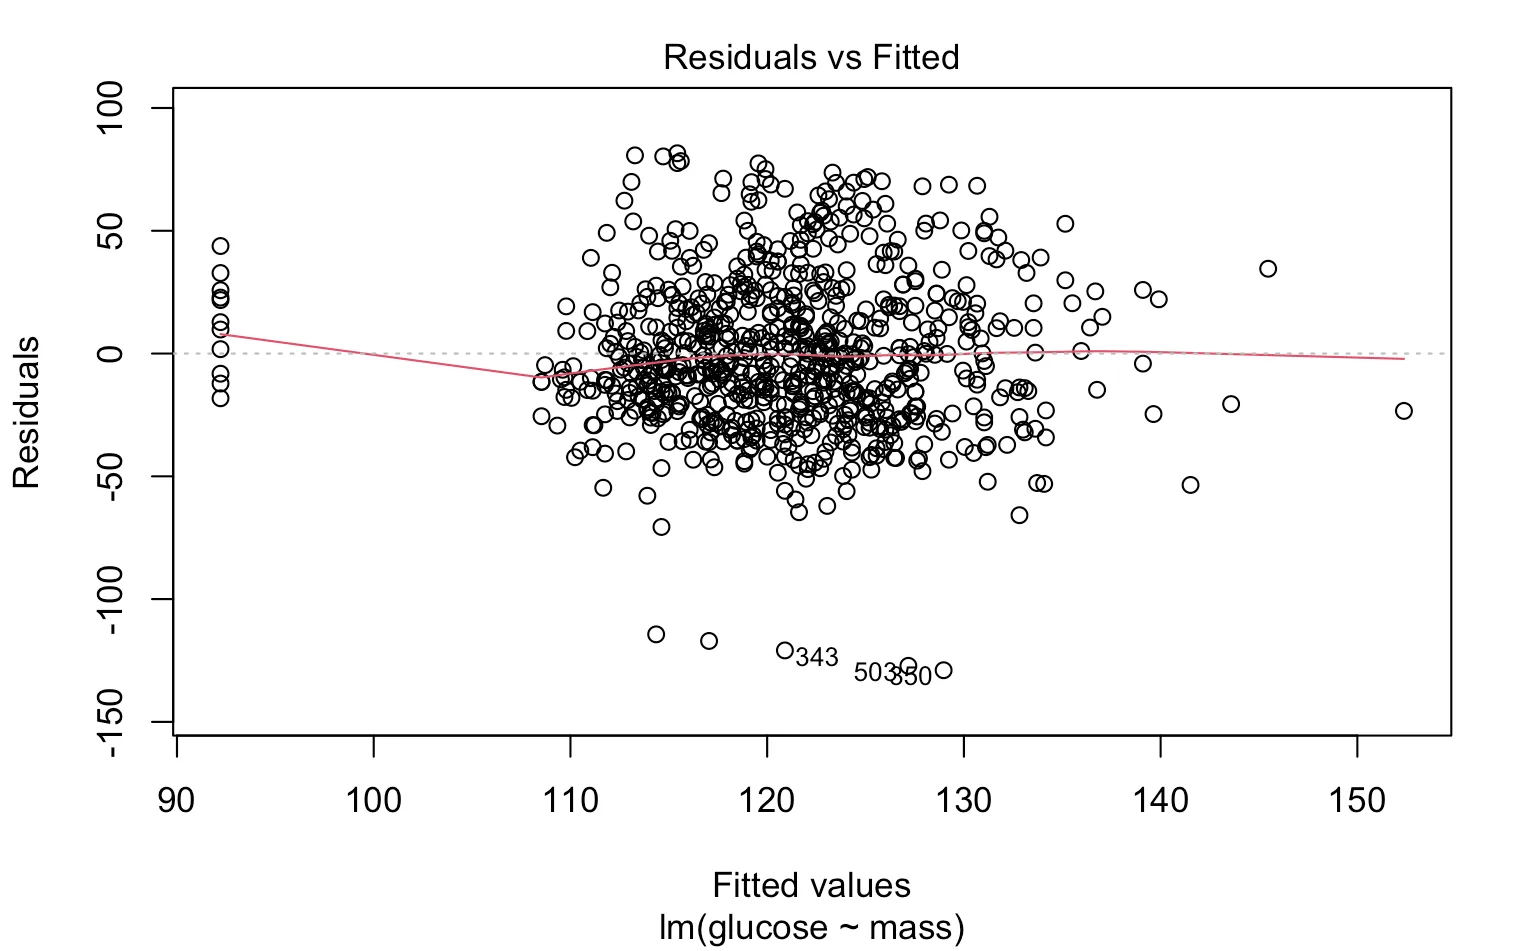
Prediksjon med regresjon
Regresjonsmodellen kan brukes til prediksjon. Det betyr at vi kan anslå verdien av Y for en gitt verdi av X. Det kan for eksempel være av interesse å forutsi hva glucose vil være ved en gitt mass. For å gjøre dette lager vi nå en ny modell med spesifikasjonen glucose ~ ., som betyr at vi modellerer glucose mot alle de andre variablene. Deretter bruker vi predict() med modellobjektet (modell_2) og angir hvilke data vi vil teste modellen på. I dette tilfellet tester vi på de samme dataene som vi trente på, noe som ikke anbefales. Vi lagrer den predikerte verdien som en ny kolonne (Predicted_Glucose) i samme dataframe. Helt til slutt skriver vi ut de første 10 radene med observerte og predikerte verdier.
modell_2 <- lm(glucose ~ ., data=PimaIndiansDiabetes)

PimaIndiansDiabetes$Predicted_Glucose <- predict(modell_2, newdata=PimaIndiansDiabetes)

select(PimaIndiansDiabetes, glucose, Predicted_Glucose) %>%
  slice(1:10)
glucose Predicted_Glucose
1 148 134.03797
2 85 100.53489
3 183 130.46052
4 89 106.04599
5 137 145.69693
6 116 106.94069
7 78 128.57557
8 115 98.26398
9 197 181.40914
10 125 136.97599Multippel regresjon
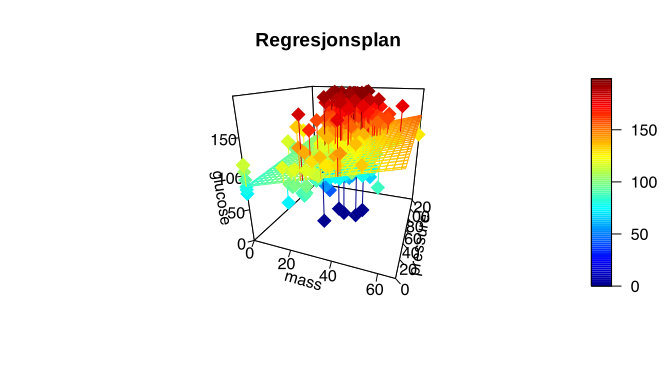
Hvis vi vil undersøke hvordan BMI (mass) samvarierer med glukose (glucose) og samtidig ta hensyn til alder, bruker vi multippel regresjon. Definisjonen av multippel regresjon er ganske enkelt regresjon med minst 2 prediktorer. Multippel regresjon følger de samme prinsippene som den lineære regresjonen vi har diskutert så langt. Metoden least-squares brukes som vanlig, men i dette tilfellet tilpasses ikke en regresjonslinje, men i stedet et regresjonsplan gjennom datapunktene. Dette planet har et tredimensjonalt utseende, som illustreres nedenfor med de samme dataene. Den andre prediktoren er pressure (blodtrykk).
Koden for regresjonsmodellen blir:
modell_2 <- lm(glucose ~ mass + pressure, data=PimaIndiansDiabetes)
summary(modell_2)Call:
lm(formula = glucose ~ mass + pressure, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-129.725 -20.893 -3.277 19.206 80.092
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 84.60294 5.48135 15.435 < 0.0000000000000002 ***
mass 0.78442 0.14834 5.288 0.000000161 ***
pressure 0.16201 0.06042 2.681 0.00749 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.08 on 765 degrees of freedom
Multiple R-squared: 0.05773, Adjusted R-squared: 0.05526
F-statistic: 23.43 on 2 and 765 DF, p-value: 0.0000000001326Tolkningen av koeffisientene er som følger.
- Når
massøker med 1 enhet, økerglucosemed 0,78442 enheter. Denne effekten er justert for pressure. - Når
pressureøker med 1 enhet, økerglucosemed 0,16201 enheter. Denne effekten er justert formass.