Håndtering av prediktorer: kategoriske, kontinuerlige
Under datainnsamling og ved utvikling av prediksjonsmodeller skal man alltid tilstrebe å bruke kontinuerlige variabler. En kontinuerlig variabel inneholder alltid mer informasjon (uavhengig av modell) enn en kategorisk variabel, og det er som regel feil å kategorisere en kontinuerlig variabel, enten variabelen er utfallet () eller en prediktor (). Likevel blir kontinuerlige variabler ofte kategorisert uten at det er begrunnet.
Det finnes imidlertid scenarioer der det er begrunnet å kategorisere en kontinuerlig variabel. Anta at vi undersøker hvordan kroppsvekt (kg) påvirker risikoen for å utvikle diabetes. Vi lager da en prediksjonsmodell med kroppsvekt (kg) som prediktor og diabetes (ja/nei) som utfall. Hvis kroppsvekt er en kontinuerlig variabel (kg), vil regresjonskoeffisienten vise hvor mye risikoen for diabetes øker for hvert kg (kilogram) kroppsvekten øker. Risikoøkningen som følger av at vekten øker med 1 kg, kan fremstå som liten og muligens til og med uten klinisk relevans. Da kan det være begrunnet å dele kroppsvekt inn i kategorier (for eksempel i kategoriene normalvekt, overvekt, fedme). Når prediksjonsmodellen i stedet bruker denne kategoriserte prediktoren, blir "effekten" (dvs. regresjonskoeffisienten) kraftigere. I dette tilfellet kan det altså være meningsfullt å kategorisere prediktoren. Det tjener imidlertid bare et pedagogisk formål; modellen med den kategoriserte prediktoren vil i prinsippet alltid være dårligere enn modellen med den kontinuerlige prediktoren.
Prospektive studier bør samle inn data som kontinuerlige variabler så langt det er mulig. Da har man muligheten til å kategorisere variablene på et senere tidspunkt.
Antakelsen om linearitet: lemping med restricted cubic splines og polynomer
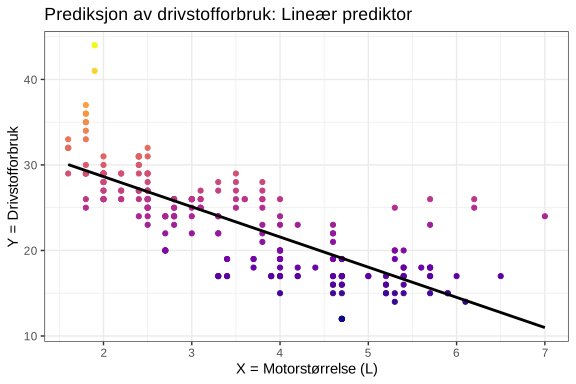
Lineære modeller, eller modeller som er nært beslektet med den lineære modellen, dominerer analyser som gjøres for effektestimering og prediksjon. Den lineære modellen bygger på antakelsen om at det finnes en lineær sammenheng mellom prediktoren og utfallet (se figur nedenfor). Denne antakelsen er en bekvemmelighet, fordi lineære sammenhenger er enkle å håndtere matematisk. Faktum er imidlertid at naturen sjelden er helt lineær, og det kan være naivt å gå ut fra at sammenhenger er lineære. Forklaringen på at analytikere og forskere ofte nøyer seg med lineære funksjoner, er at de gir en akseptabel tilnærming til virkeligheten. I figuren nedenfor ser vi en regresjonslinje (svart) som viser hvordan prediktoren forholder seg til drivstofforbruk (). Av figuren fremgår det at regresjonslinjen er en akseptabel tilnærming til sammenhengen, men ved lave (<2) og høye verdier (>5) av ligger regresjonslinjen lenger unna datapunktene (feilen er større).
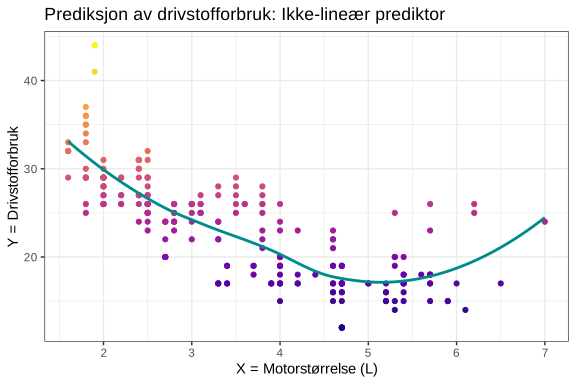
La oss gjøre om modellen ovenfor og la prediktoren ha en ikke-lineær sammenheng med . Dette innebærer at sammenhengen mellom og får variere (være fleksibel) over intervallet til . Resultatet blir som følger:
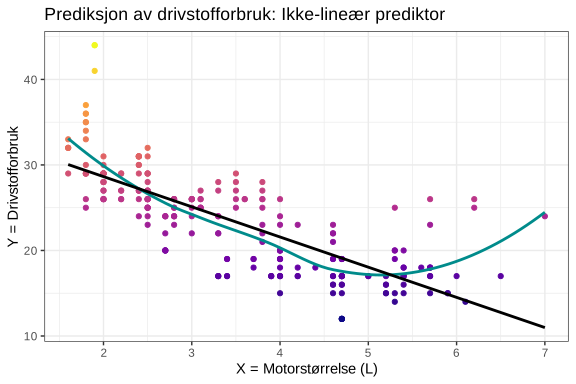
Hvis grafene legges oppå hverandre, blir det tydeligere at den ikke-lineære modellen har høyere presisjon:
Antakelsen om linearitet bør som regel stilles spørsmål ved. Antakelsen kan enkelt undersøkes som i eksemplet ovenfor (se kapittelet Lineær regresjon). Den lineære modellens validitet er høyere hvis prediktorene er korrekt spesifisert.
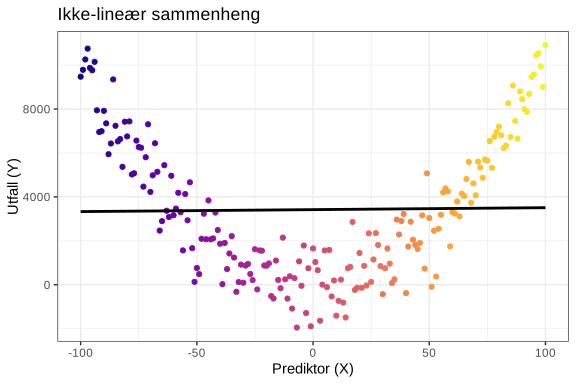
Hvis sammenhengen mellom og ikke er lineær, kan det føre til feilaktige konklusjoner. Figuren nedenfor viser en sterkt ikke-lineær sammenheng som fører til den feilaktige konklusjonen at det ikke finnes noen sammenheng mellom og , noe regresjonslinjen viser ved at linjen i prinsippet mangler stigning (β ≈ 0).
Det trengs en mer fleksibel regresjonslinje. Antakelsen om linearitet må lempes for at regresjonslinjen skal følge (predikere) dataene bedre. Å transformere prediktoren var tidligere en populær metode. La oss logaritmere prediktoren og visualisere regresjonslinjen på nytt:
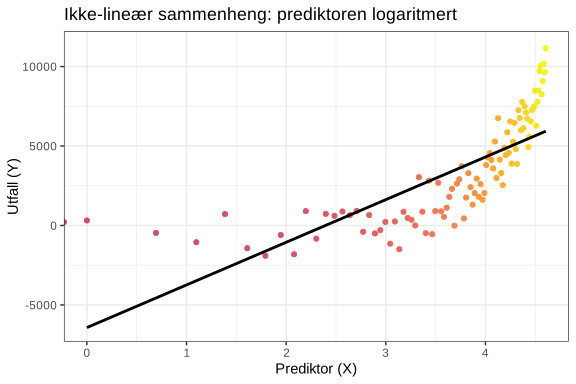
Å transformere prediktoren gir i tilfellet ovenfor en bedre modell, men den er ikke optimal (se intervallet < 2), og i tillegg blir koeffisienten nå vanskeligere å tolke (tenk deg at vi hadde logaritmert kroppsvekt i kg). Det er bedre å bruke ikke-lineære funksjoner av , som ikke forutsetter at sammenhengen mellom og er lineær. Vi lager prediksjonsmodellen på nytt med en ikke-lineær funksjon, uten å logaritmere , noe som gir følgende resultat:
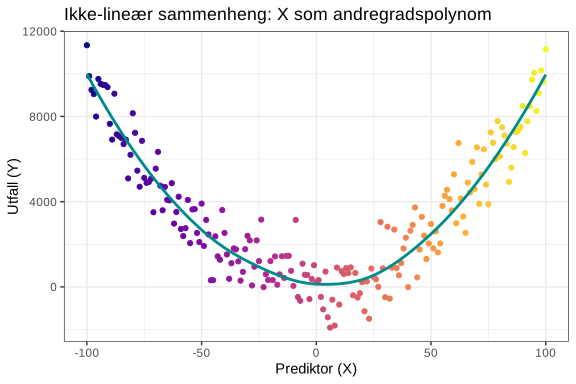
I figuren ovenfor er modellert med et andregradspolynom, noe som innebærer at er multiplisert med . Dette er den enkleste måten å lempe på antakelsen om linearitet, og det innebærer at man bruker et polynom (eng. polynomial), det vil si heltallspotenser av prediktoren . Følgende polynomer finnes:
- Andregradspolynom:
- Tredjegradspolynom:
- Fjerdegradspolynom:
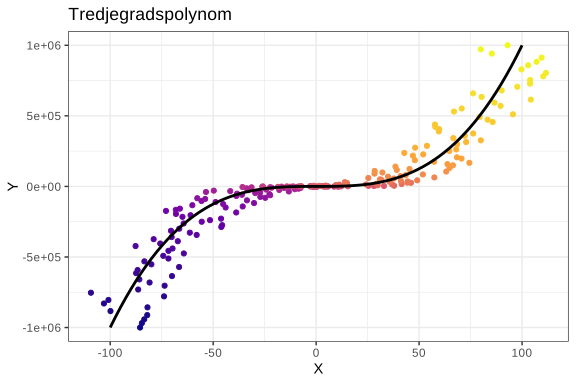
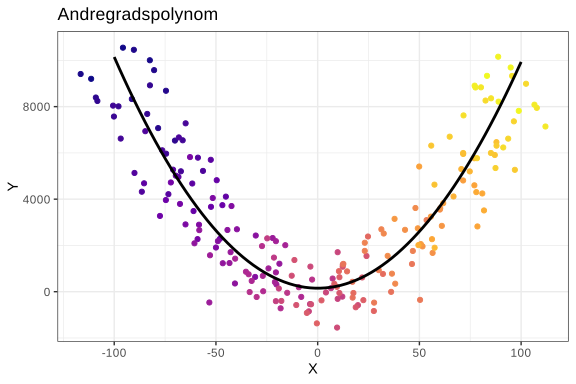
Hvis man ønsker å inkludere polynomer i en regresjon, må alle lavere grader av prediktoren også inkluderes. Det innebærer at hvis et tredjegradspolynom () for alder skal inkluderes i modellen, skal også og inkluderes som enkeltstående prediktorer. En ofte brukt, og like ofte kritisert, metode for å inkludere polynomer i modeller er å teste polynomene og beholde dem hvis koeffisientene er statistisk signifikante (P < 0,05), fordi dette er bevis for at det finnes en ikke-lineær funksjon i dataene. Syntaksen for en lineær modell med et tredjegradspolynom for prediktoren x er som følger:
lm(y ~ x + poly(x, 2) + poly(x, 3), data=data)Faktum er at R alltid inkluderer lavere grader av et polynom selv om man ikke spesifiserer dette. Det innebærer at modellen ovenfor er ekvivalent med følgende:
lm(y ~ poly(x, 3), data=data)La oss lage en lineær regresjon med et tredjegradspolynom i mpg-dataene. Vi bruker pakken broom for å hente ut resultater fra modellen.
library(tidyverse)
data(mpg)

my_fit <- lm(hwy ~ drv + cyl + poly(displ, 3), data=mpg)

library(broom)
tidy(my_fit)| term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
| (Intercept) | 24.8304756 | 2.1392664 | 11.607005 | 0.000000 |
| drvf | 4.4553554 | 0.5050549 | 8.821528 | 0.000000 |
| drvr | 4.1892200 | 0.6871610 | 6.096417 | 0.000000 |
| cyl | -0.6548109 | 0.3682590 | -1.778126 | 0.0767217 |
| poly(displ, 3)1 | -41.8215567 | 9.8728249 | -4.236027 | 0.000033 |
| poly(displ, 3)2 | 17.0200984 | 3.2063213 | 5.308295 | 0.000000 |
| poly(displ, 3)3 | 2.0802160 | 3.0357794 | 0.685233 | 0.493896 |
Som det fremgår ovenfor, er tredjegradspolynomet ("poly(displ, 3)3") ikke statistisk signifikant (p=0.493896), men andregradspolynomet er derimot statistisk signifikant (p=0.000000), i likhet med den lineære prediktoren (p=0.000033). Polynomer har imidlertid flere svakheter som kan føre til utilfredsstillende prediksjoner. Splines foretrekkes ofte fremfor polynomer.
Regression splines: lineære splines, cubic splines, restricted cubic splines
En spline er en fleksibel funksjon som består av flere polynomer. Hvert polynom representerer et intervall av fordelingen til prediktoren , og alle polynomene er koblet sammen i endene.
Den enkleste spline-funksjonen er den lineære. En enkel lineær spline innebærer ganske enkelt at prediktoren er delt inn i intervaller, noe som fører til at egentlig deles opp i flere prediktorer. Selv om de enkelte intervallene er lineære funksjoner, kan de til sammen danne en ikke-lineær funksjon. I figuren nedenfor er delt inn i 3 intervaller ved hjelp av to knutepunkter (eng. knots). Antallet og plasseringen av disse knots kan justeres.
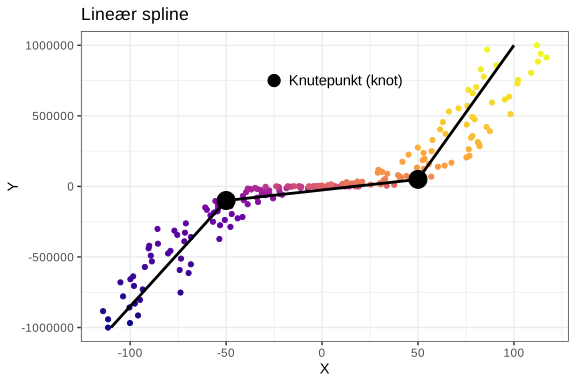
En enkel lineær spline gjør det mulig å modellere ikke-lineære funksjoner og krever bare at sammenhengen mellom og skal være lineær innenfor hvert intervall.
Ligningen for den opprinnelige modellen (uten spline) er som følger:
Y = β0 + β1X1
Hvis prediktoren X1 utvides til en spline med 3 intervaller, blir ligningen:
Y = β0 + β1X1 + β2X2 + β3X3
Cubic splines (CS)
En lineær spline er som oftest å foretrekke fremfor polynomer, men dessverre er lineære splines ikke fleksible nettopp i knutepunktene, og derfor blir modellering av bøyde/krumme sammenhenger ikke optimal. For å løse dette kan man bruke cubic splines, som er det samme som lineære splines, men der man bruker polynomer i hvert intervall. Dette gjør at overgangene mellom intervallene blir myke, og cubic splines er bedre (enn lineære splines) til å beskrive bøyde/krumme sammenhenger. Hvis en cubic spline har 3 knutepunkter (knots), må totalt 6 regresjonskoeffisienter (β1 til β6) estimeres. Antallet koeffisienter som må estimeres, er nemlig k+3, der k er antallet knots. Det innebærer at bruk av cubic splines blir kostbart, fordi flere parametere må estimeres.
Restricted cubic splines (RCS, natural splines)
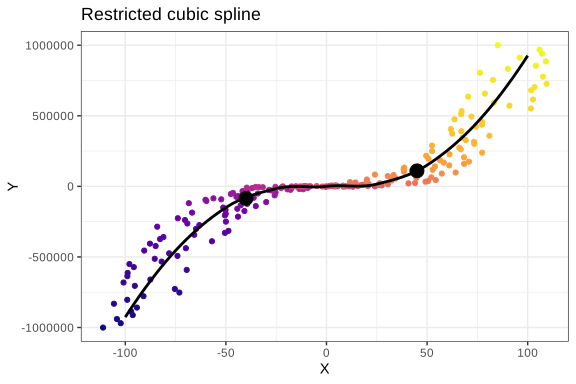
Den beste og mest brukte spline-funksjonen er restricted cubic spline. Disse spline-funksjonene er som cubic splines, men funksjonen tvinges til å være lineær i halene (i begynnelsen og slutten av prediktorens fordeling). Dette gir bedre presisjon i modellen. Bruk av restricted cubic splines straffer modellen med k+1 parametere. Det innebærer at hvis 3 knots brukes, må 4 koeffisienter estimeres.
Trengs splines?
Hvis en prediktor utvides til en spline-funksjon, kan man bruke P-verdien til å avgjøre om spline-funksjonen er nødvendig. Nullhypotesen er at koeffisientene (for de enkelte spline-intervallene) er lik 0, og hvis P-verdien er < 0,05, er dette usannsynlig, og da beholder man disse splines.
Hvor mange knutepunkter (knots) trengs?
Hvis man kjenner sammenhengen mellom prediktoren og utfallet , og vet hvor det finnes krumninger og ikke-lineariteter, kan man selv spesifisere hvor knutepunktene skal plasseres. Man trenger ikke å vite hvor ikke-linearitet finnes. Det går utmerket å bruke splines uten kunnskap om dette, forutsatt at knutepunktene plasseres jevnt fordelt over intervallet til .
I R spesifiserer du antallet knutepunkter du ønsker, og disse plasseres automatisk i riktige intervaller. Man bruker minst 3 knutepunkter (selv om eksemplene ovenfor er illustrert med to knutepunkter), og det er sjelden nødvendig å bruke flere enn 6 knutepunkter. Jo flere observasjoner man har, desto flere knutepunkter kan brukes.
Restricted cubic splines kan brukes i lineær regresjon, logistisk regresjon, Poisson-regresjon, Cox-regresjon osv.
Man bør være raus med å bruke restricted cubic splines, fordi det er naivt å forutsette at sammenhenger er lineære. Man bør imidlertid forhåndsspesifisere sine splines før modellen bygges. Å foregripe dette ved å visualisere sammenhenger mellom variabler (f.eks. med korrelasjonsdiagrammer) anbefales ikke. Man bør være særlig raus med splines for prediktorer som er sterkt relatert til utfallsmålet. Det lønner seg som oftest ikke å investere frihetsgrader i variabler med svake sammenhenger med utfallsmålet.
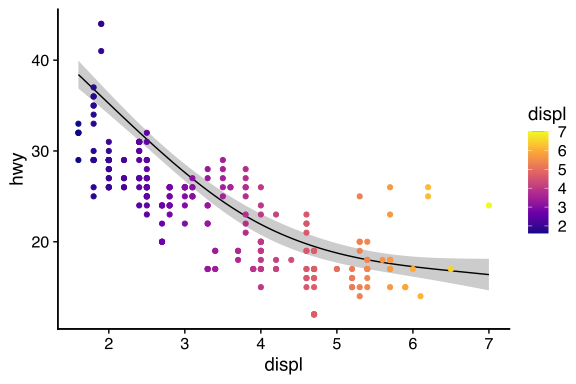
I koden nedenfor aktiverer vi pakkene tidyverse, Hmisc og rms, for deretter å laste inn mpg-dataene. Pakken rms har funksjoner for restricted cubic splines (rcs()). For å bruke rms må vi fortelle pakken hvilke fordelinger som finnes i mpg-dataene. Deretter stiller vi inn dette i options(). Så bygger vi en modell med ols() (dette er funksjonen for lineær regresjon i pakken rms), der prediktoren displ modelleres med en spline-funksjon. Sammenhengen visualiseres deretter med ggplot(). Merk at vi lager to grafer og legger dem oppå hverandre med cowplot().
library(Hmisc)
library(rms)

## Fordelinger
ddist <- datadist(mpg)
options(datadist='ddist')

## Lager modellen
model <- ols(hwy ~ rcs(displ, 3), data=mpg, x=T, y=T)

## Lager graf av spline-funksjonen
p1 <- ggplot(Predict(model, "displ"), ylab="Y (hwy)") +theme_half_open()

## Lager graf med x- og y-verdiene tegnet inn
p2 <- ggplot(mpg, aes(x=displ, y=hwy, color=displ)) + geom_point() + scale_color_viridis_c(option = "plasma") + theme_half_open()

## Legger grafene oppå hverandre
library(cowplot)
aligned_plots <- align_plots(p1, p2, align="hv", axis="tblr")
ggdraw(aligned_plots[[1]]) + draw_plot(aligned_plots[[2]])