
I dette kapittelet brukes data om pimaindianere. Diabetes er vanligere blant pimaindianere, og i disse dataene er 768 individer undersøkt med hensyn til diabetes, blodsukker osv. Dataene finnes i pakken mlbench. Du må først installere mlbench og deretter aktivere dataene. Vi skal dessuten lage en kopi av dataene som objektet pima.
## Installer og aktiver mlbench
install.packages("mlbench")
library(mlbench)

## Aktiver data
data(PimaIndiansDiabetes)

## Kopier data
pima <- PimaIndiansDiabetes

## Inspiser data
head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 pos
2 1 85 66 29 0 26.6 0.351 31 neg
3 8 183 64 0 0 23.3 0.672 32 pos
4 1 89 66 23 94 28.1 0.167 21 neg
5 0 137 40 35 168 43.1 2.288 33 pos
6 5 116 74 0 0 25.6 0.201 30 negDen siste kolonnen (diabetes) angir om personen har diabetes (pos) eller ikke (neg). I neste steg koder vi om kolonnen diabetes til Yes eller Nei i stedet for henholdsvis pos og neg.
pima$diabetes = recode_factor(pima$diabetes,
                              'pos'='Yes',
                              'neg'='No')

head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 Yes
2 1 85 66 29 0 26.6 0.351 31 No
3 8 183 64 0 0 23.3 0.672 32 Yes
4 1 89 66 23 94 28.1 0.167 21 No
5 0 137 40 35 168 43.1 2.288 33 Yes
6 5 116 74 0 0 25.6 0.201 30 NoLag treningsdata og testdata
Deretter bruker vi funksjonen initial_split() for å lage treningsdata og testdata. Vi angir prop=0.7 for at 70 % av dataene skal brukes til trening. Med funksjonene training() og testing() trekker vi deretter ut treningsdata og testdata til separate filer.
## Lager trening og test
pima_split <- initial_split(pima, strata=diabetes, prop=0.7)
pima_train <- training(pima_split)
pima_test  <- testing(pima_split)
Legg merke til at vi i koden over angav strata=diabetes, noe som innebærer at vår split stratifiseres på kolonnen diabetes. Det fører til at andelen med Yes og No blir like stor i treningsdata og testdata. Dette er ønskelig for at andelen som rammes av diabetes, skal være like stor i treningsdata og testdata.
Spesifiser modell og metode
Vi begynner med å spesifisere hvilken type modell vi vil bruke. Dette gjøres ved hjelp av funksjoner i parsnip-pakken. Vi begynner med å spesifisere at vi vil bruke logistisk regresjon, noe vi gjør med funksjonen logistic_reg() i parsnip. Hvis vi bare skriver ut funksjonens navn og kjører koden, får vi følgende resultat:
logistic_reg()Logistic Regression Model Specification (classification)
Computational engine: glmAv det ovenstående kan vi lese at en logistisk modell er spesifisert for å gjøre klassifisering (classification), noe som innebærer at utfallet er en kategorisk variabel. Dette skal gjøres med glm (generalized linear model), som er den klassiske formen for logistisk regresjon. Metoden ("engine") GLM er altså standardmetoden for logistisk regresjon i Tidymodels. Vi kan imidlertid spesifisere andre metoder for logistisk regresjon. Det gjør vi ved å legge til funksjonen set_engine() og spesifisere en metode. Alle alternativene for logistic_reg() finnes i dokumentasjonen her.
Vi har ennå ikke lagret spesifikasjonen vår. Nedenfor spesifiserer vi en logistisk regresjon ved hjelp av GLM, og den skal brukes til klassifisering. Det sistnevnte spesifiseres med funksjonen set_mode(). Denne funksjonen er særlig viktig hvis modellen kan brukes både til klassifisering (predikere kategoriske utfall) og regresjon (predikere kontinuerlige utfall). Vi lagrer spesifikasjonen i objektet log_mod.
log_mod <-
  logistic_reg() |>
  set_engine("glm") |>
  set_mode("classification")

log_mod
Logistic Regression Model Specification (classification)
Computational engine: glmSpesifiser en formel
Vi går videre med å spesifisere selve formelen med funksjonen fit() og legger dette til objektet log_mod. Legg merke til at formelen diabetes ~ . betyr at vi lager en modell der diabetes er utfallet og alle andre variabler er prediktorer, noe som spesifiseres med punktumet (.):
log_fit <-
  log_mod |>
  fit(diabetes ~ ., data=pima_train)

## Skriv ut resultatet
log_fit
parsnip model object
Call: stats::glm(formula = diabetes ~ ., family = stats::binomial,
data = data)
Coefficients:
(Intercept) pregnant glucose pressure triceps insulin mass pedigree age
8.591e+00 -1.499e-01 -3.117e-02 1.470e-02 5.995e-06 1.321e-03 -1.056e-01 -7.798e-01 -2.357e-02
Degrees of Freedom: 536 Total (i.e. Null); 528 Residual
Null Deviance: 694.2
Residual Deviance: 500.4 AIC: 518.4Trekk ut resultater
Resultatet blir ryddigere med funksjonen tidy() fra pakken broom. Vi angir at argumentene exponentiate og conf.int er TRUE for å få eksponensierte koeffisienter samt konfidensintervaller:
tidy(log_fit, exponentiate=T, conf.int=T) term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 5382. 0.873 9.84 7.85e-23 1040. 32053.
2 pregnant 0.861 0.0386 -3.88 1.05e- 4 0.797 0.928
3 glucose 0.969 0.00431 -7.24 4.61e-13 0.961 0.977
4 pressure 1.01 0.00648 2.27 2.32e- 2 1.00 1.03
5 triceps 1.00 0.00843 0.000711 9.99e- 1 0.984 1.02
6 insulin 1.00 0.00102 1.29 1.97e- 1 0.999 1.00
7 mass 0.900 0.0192 -5.51 3.52e- 8 0.866 0.933
8 pedigree 0.458 0.365 -2.14 3.27e- 2 0.222 0.930
9 age 0.977 0.0109 -2.16 3.04e- 2 0.956 0.998Kolonnen estimate er odds ratio (oddsratio). Kolonnene conf.low og conf.high er henholdsvis nedre og øvre grense for 95 % konfidensintervall.
Prediker
I neste steg brukes modellen til å predikere på testdata (pima_test). Dette gjøres med funksjonen predict(). Resultatet lagres i en ny kolonne i pima_test. Den nye kolonnen kalles predicted:
pima_test$predicted <- predict(log_fit,
                               new_data = pima_test,
                               type="prob")
Hvis vi undersøker pima_test, ser vi at den nye kolonnen faktisk består av to kolonner, nemlig .pred_Yes og .pred_No. Det innebærer at dette er en "nestet" kolonne, siden den består av flere kolonner.
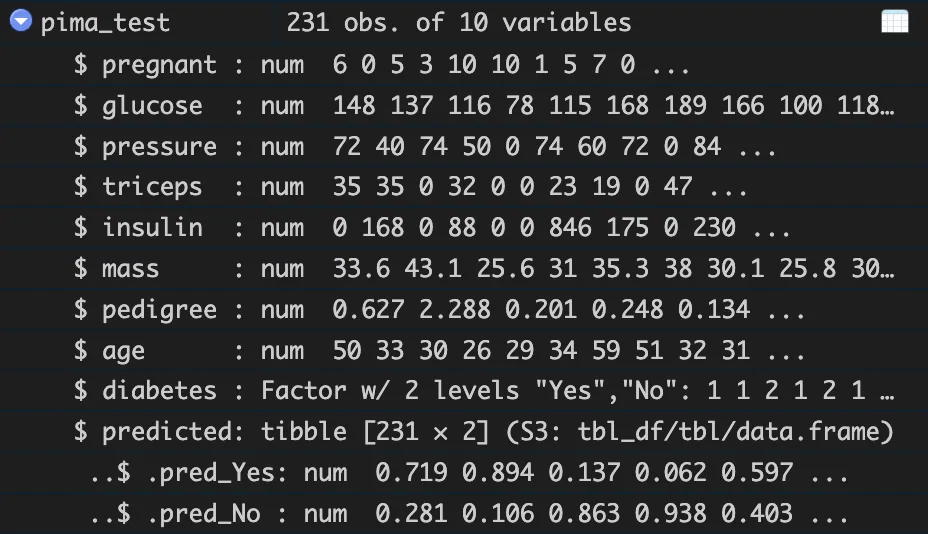
Nestede kolonner er riktignok en effektiv måte å lagre data på, men i dette tilfellet noe upraktisk. Derfor bryter vi ut kolonnene til separate kolonner ved hjelp av funksjonen unnest(), slik:
pima_test <- unnest(pima_test, predicted)

## Inspiser data
head(pima_test)
pregnant glucose pressure triceps insulin mass pedigree age diabetes .pred_Yes .pred_No
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <fct> <dbl> <dbl>
1 6 148 72 35 0 33.6 0.627 50 Yes 0.719 0.281
2 0 137 40 35 168 43.1 2.29 33 Yes 0.894 0.106
3 5 116 74 0 0 25.6 0.201 30 No 0.137 0.863
4 3 78 50 32 88 31 0.248 26 Yes 0.0620 0.938
5 10 115 0 0 0 35.3 0.134 29 No 0.597 0.403
6 10 168 74 0 0 38 0.537 34 Yes 0.885 0.115
7 1 189 60 23 846 30.1 0.398 59 Yes 0.760 0.240
8 5 166 72 19 175 25.8 0.587 51 Yes 0.658 0.342
9 7 100 0 0 0 30 0.484 32 Yes 0.361 0.639
10 0 118 84 47 230 45.8 0.551 31 Yes 0.384 0.616Kolonnene .pred_Yes og .pred_No er de predikerte sannsynlighetene for henholdsvis utfallet Yes og No ifølge den logistiske regresjonsmodellen. Summen av sannsynligheten for Yes og No er alltid 1,0.
Evaluer modellen
Hvis vi bare ser på sannsynligheten for Yes (.pred_Yes), kan vi for eksempel velge å predikere at individet har diabetes hvis sannsynligheten er >0,5 (større enn 0,5). Grensen 0,5 brukes ofte som standard i mange pakker og funksjoner, fordi verdier >0,5 innebærer at det er mer sannsynlig at hendelsen inntreffer (i dette tilfellet diabetes) enn at den uteblir. Denne grensen kalles ofte decision threshold. Man kan selvsagt senke decision threshold til 0,4, 0,35, 0,2 eller enda lavere. Jo lavere terskelen er, desto flere individer med diabetes vil bli oppdaget, men desto flere individer får falskt positive diagnoser. Det finnes enkle funksjoner for å evaluere sensitivitet og spesifisitet for et stort antall decision thresholds. Med funksjonen roc_curve() beregner vi sensitivitet og spesifisitet for over 200 decision thresholds:
pima_test %>%
  roc_curve(diabetes, .pred_Yes)
.threshold specificity sensitivity
<dbl> <dbl> <dbl>
1 -Inf 0 1
2 0.00171 0 1
3 0.0133 0.00667 1
4 0.0176 0.0133 1
5 0.0190 0.0200 1
6 0.0210 0.0267 1
7 0.0260 0.0333 1
8 0.0279 0.0400 1
9 0.0282 0.0467 1
10 0.0297 0.0533 1
....Vi kan automatisk beregne arealet under ROC-kurven med følgende kode:
pima_test %>%
  roc_auc(diabetes, .pred_Yes)
.metric .estimator .estimate
roc_auc binary 0.840AUC ROC er 0,840.
ROC-kurven fås med følgende kode:
pima_test %>%
  roc_curve(diabetes, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal()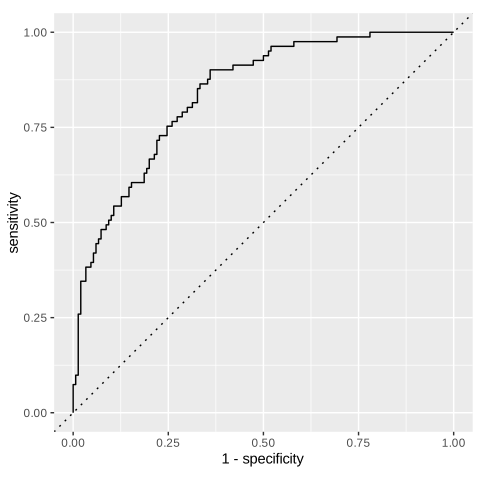
For interessens skyld kan vi gjøre om modellen, men denne gangen med extreme gradient boosting (XGBoost), som er en svært kraftig modell. XGBoost finnes i funksjonen boost_tree(). Den har hyperparametre (for eksempel tree_depth) som egentlig må optimaliseres, men det gjøres ikke i dette eksempelet. Hyperparametrene får én enkelt standardverdi for enkelhets skyld. På linje 13 lager vi en ny data frame kalt resultat, som bare inneholder kolonnen diabetes fra pima_test. På linje 16 bruker vi XGBoost-modellen vår til å predikere sannsynligheten for diabetes, og resultatet sendes til kolonnen predicted2 i resultat. På linje 21 unnester vi kolonnen predicted2. Deretter beregnes AUC-ROC og ROC-kurven.
## Spesifiser modell og metode
xgb_mod <-
  boost_tree(tree_depth = 4,
             trees = 600,
             learn_rate = 0.005,
             min_n = 5,
             sample_size = 0.5) |>
  set_engine('xgboost') |>
  set_mode('classification') |>
  fit(diabetes ~ ., data=pima_train)

## Lag en data frame med faktiske diagnoser
resultat <- data.frame(diabetes = pima_test$diabetes)

## Prediker diagnose
resultat$predicted2 <- predict(xgb_mod,
                               new_data = pima_test,
                               type="prob")

## Unnest kolonnen predicted2
resultat <- unnest(resultat, predicted2)

## ROC AUC
resultat %>%
    roc_auc(diabetes, .pred_Yes)

## ROC-kurven
resultat |>
  roc_curve(diabetes, .pred_Yes) |>
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal()
.metric .estimator .estimate
roc_auc binary 0.844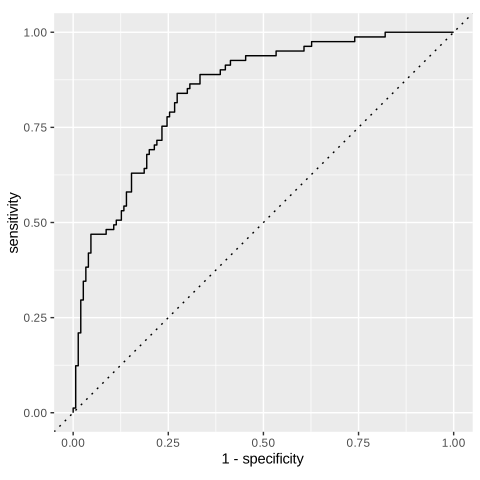
ROC for XGBoost uten hyperparametertuning var 0,844 sammenlignet med 0,840 for logistisk regresjon.
Variable importance
Maskinlæring av denne typen har innebygde metoder for å sammenligne prediktorenes relative betydning. Dette kalles relative variable importance. Pakken vip (variable importance) kan brukes til å trekke ut denne informasjonen fra Tidymodels-objekter, slik:
library(vip)
xgb_mod %>% vip(geom = "point")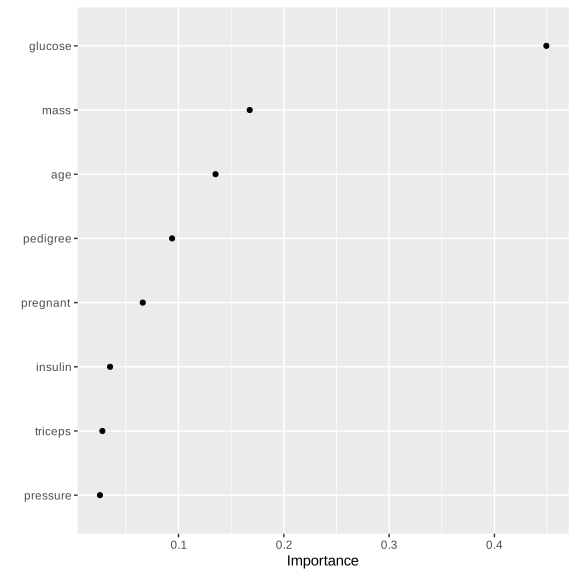
Spørsmål og svar
Hvor finnes listen over tilgjengelige modeller og metoder? Klikk her for å komme til parsnips dokumentasjon.