
Å sammenligne og velge mellom flere modeller
Hvis målet er å utvikle en prediksjonsmodell med høy prediktiv evne, må ulike modeller testes og sammenlignes. Å bare lage og evaluere én modell er en kardinalfeil dersom hensikten er å bruke modellen til å gjøre prediksjoner. For å evaluere og sammenligne ulike modeller trengs en standardisert arbeidsflyt, som oppsummeres i følgende flytskjema.
graph TD;
    D(1. Data) --> |"75%"| TD(2. Treningsdata);
    D --> |"25%"| Test(7. Testdata);
    TD --> Kand(3. Kandidatmodeller) --> CV(4. Cross-Validation<br>Kryssvalidering)
CV --> BP(5. Finn beste parametere)
TD --> OM(6. Tren modellen på nytt)
BP-->OM
OM-->Test
Test-->SE(8. Endelig evaluering)
Kandidatmodeller (Candidate models)
Begrunnelsen for å teste ulike typer modeller er at vi ikke vet på forhånd hvilken modell som er best. Eksempler på modeller for kontinuerlige utfallsmål er lineær regresjon, random forest, gradient boosting, etc. For binære utfall kan vi teste logistisk regresjon, random forest, gradient boosting, etc. Faktisk kan vi for hver type modell teste ulike spesifikasjoner av modellen. Du innser ganske snart at man for enhver gitt oppgave kan teste et svært stort antall modeller, og dette er tidkrevende arbeid. Heldigvis finnes det en rekke pakker og funksjoner i R som gjør dette arbeidet enklere. Dette diskuteres senere.
Training
Når et antall ulike modeller er valgt ut, skal de trenes på en delmengde av alle dataene. En tommelfingerregel er at 70-80% av dataene brukes til trening ("training set"). Deretter testes modellene på testdata ("test set"), som utgjør de resterende 20-30% av dataene.
Overfitting
Å evaluere modellene på testdata er et enkelt, men briljant grep. Praktisk talt alltid viser modeller høy prediktiv evne på treningsdata, noe som forklares av at modellene har sett alle observasjonene i treningsdataene. Det innebærer at modellene kjenner mønstre og sammenhenger i treningsdataene. Dette gir falskt høy presisjon i treningsdataene. Den store utfordringen er å lage en modell med høy presisjon på fremtidige data (som modellen aldri har observert), og dette er hensikten med testdata. Modellene må aldri trenes på testdata. Observasjonene i testdataene er dermed "nye" for modellene. Presisjonen på testdata viser modellens forventede presisjon på nye og fremtidige data.
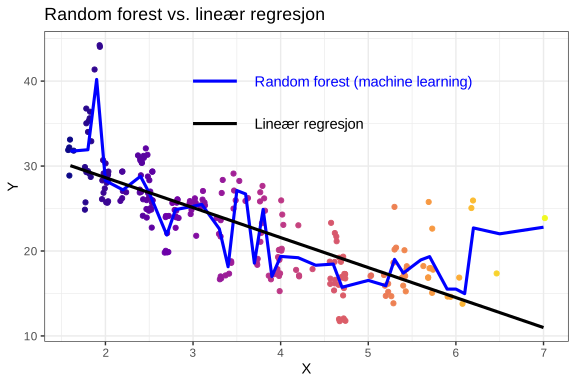
Betydningen av det ovenstående blir enda tydeligere med machine learning. De fleste modeller innen machine learning lager ikke lineære sammenhenger mellom og . Modellene kan tilpasse svært fleksible funksjoner som følger dataene ekstremt nøye. Det innebærer at selv små, ubetydelige avvik i sammenhenger kan fanges opp og modelleres. Dette illustreres i figuren nedenfor, der resultatet av to prediksjonsmodeller sammenlignes. Den ene er klassisk lineær regresjon og den andre er machine learning med random forest. Begge modellene er trent og testet i samme datasett (testdata er ikke brukt). Bildet viser at random forest er en svært fleksibel modell som følger dataene svært presist. Det kan virke imponerende, men det er en stor ulempe. Fenomenet kalles overfitting og innebærer at modellens prediksjon er utmerket i treningsdataene (på grunn av modellens fleksibilitet), og dette villeder modellen hvis den testes på nye data som den ennå ikke har observert. En god modell kan generaliseres til testdata og vise høy presisjon på observasjoner den ennå ikke har erfart.
Kryssvalidering (Cross Validation)
k-Fold Cross Validation
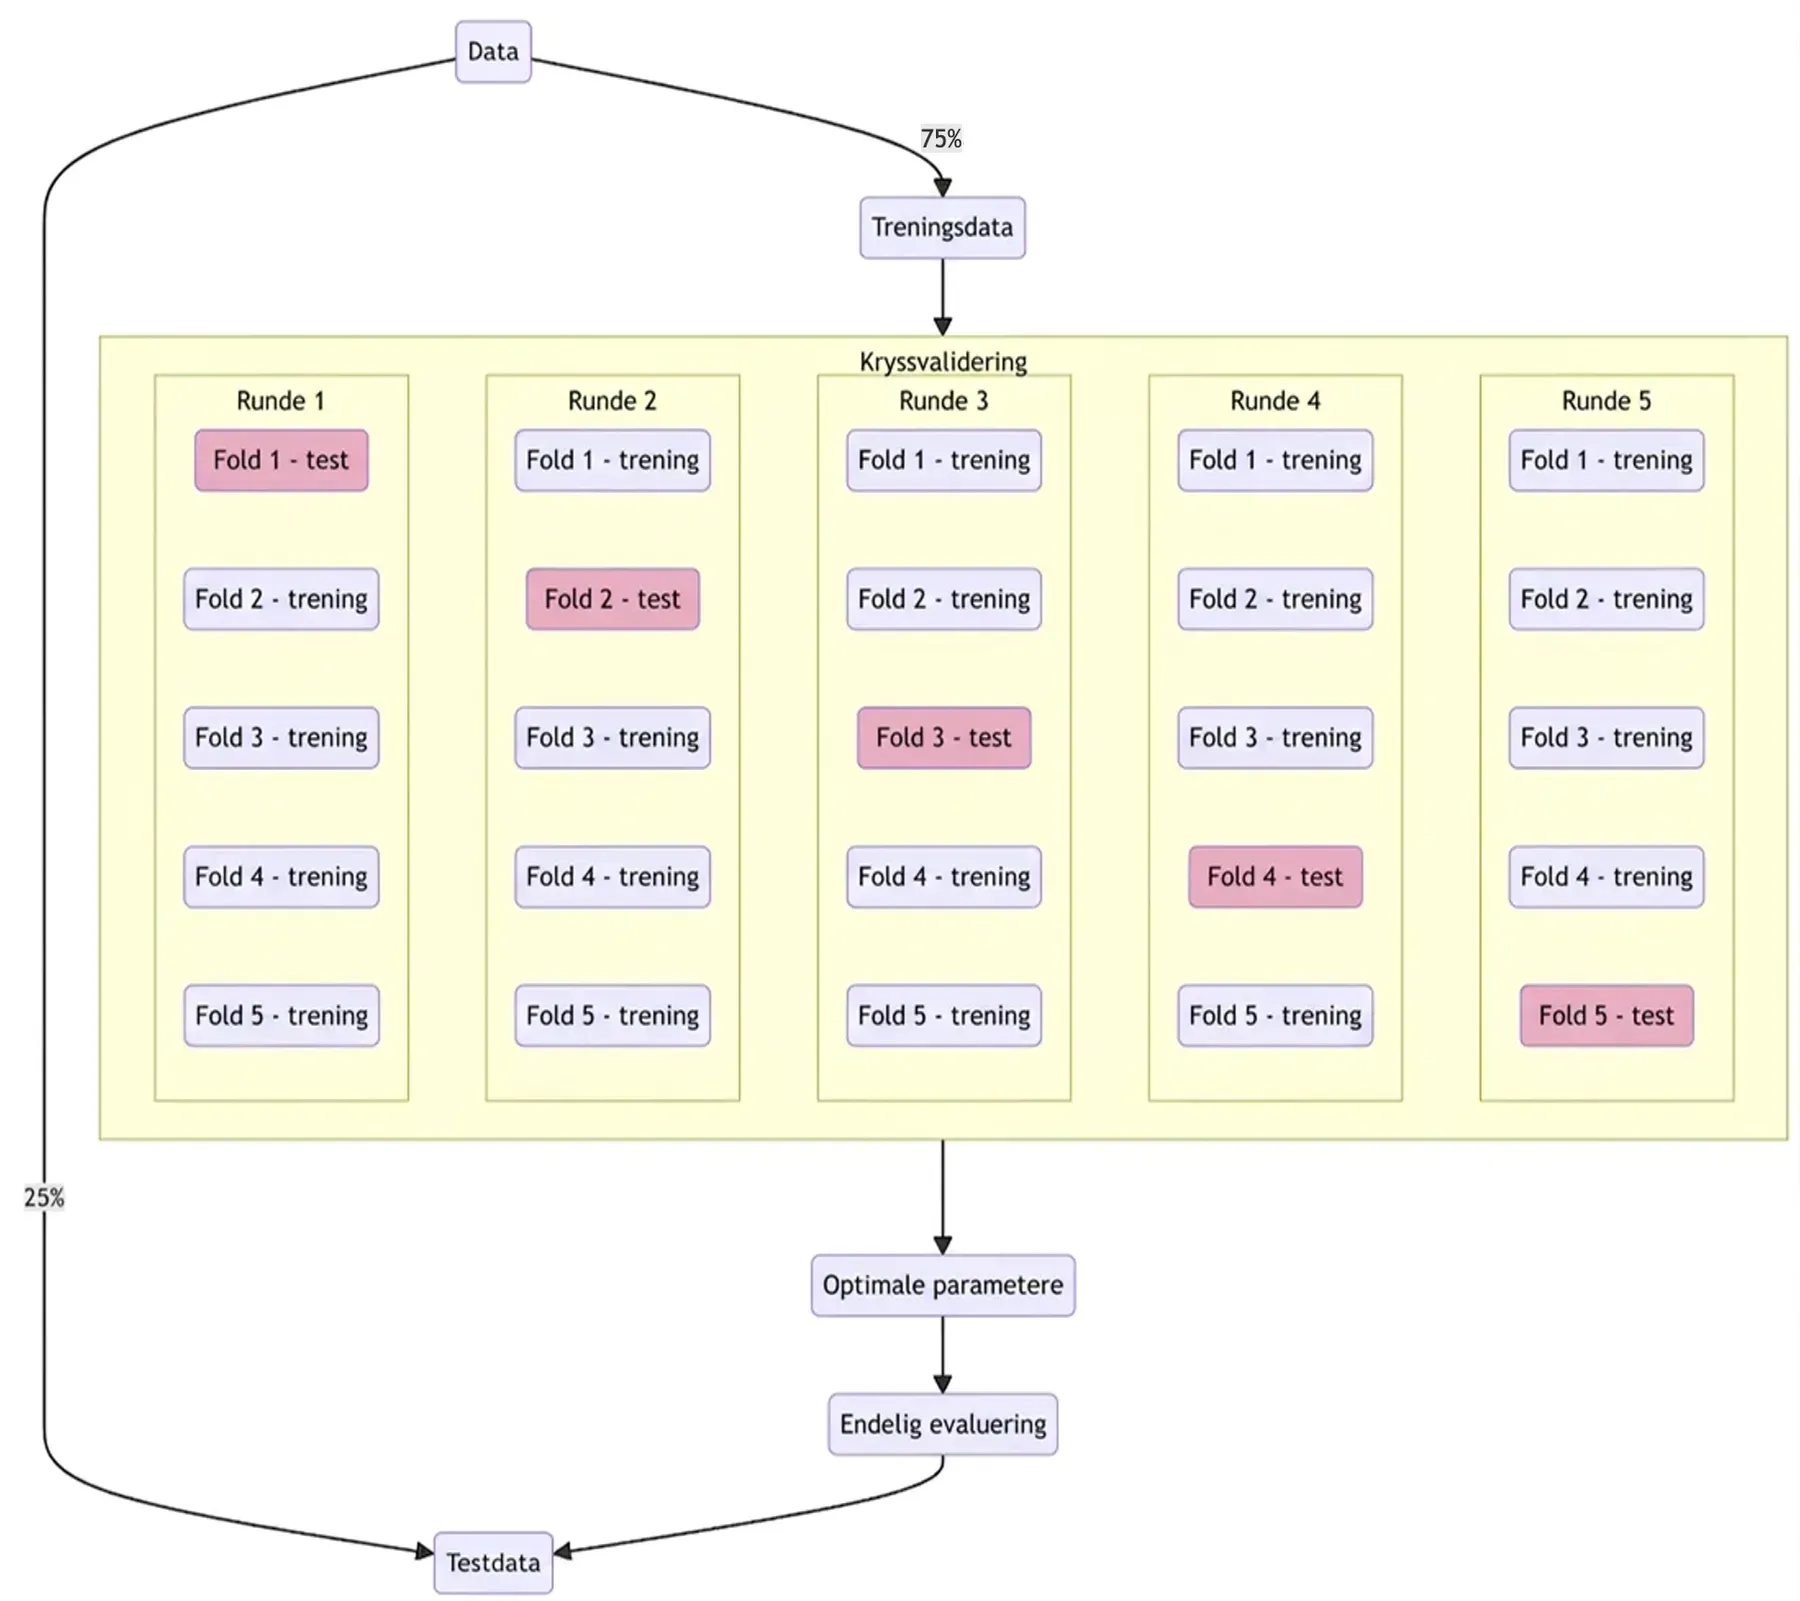
Den mest brukte metoden for å evaluere modeller i treningsdata er kryssvalidering (cross validation). Flytskjemaet nedenfor viser hvordan kryssvalidering fungerer.
- Det opprinnelige datasettet deles tilfeldig i treningsdata og testdata. Fordelingen kan for eksempel være henholdsvis 75% og 25%.
- Folds: Treningsdataene deles deretter tilfeldig inn i like store folds (deler). I eksempelet nedenfor lages 5 folds. Modellen trenes på 4 av disse og testes på den siste folden (som modellen ikke har trent på).
- Repeats (runder): Fremgangsmåten i trinn 2 gjentas, men nå trekkes 5 nye folds tilfeldig. Som i trinn 2 skjer treningen i 4 av disse, og testen gjøres på den siste folden.
Figuren nedenfor viser kryssvalidering med 5 folds gjentatt 5 ganger. I virkeligheten kan det lønne seg å gjøre 10 gjentakelser (runder). Hensikten med kryssvalideringen er å identifisere den beste modellen allerede i treningsdataene ved (i hver runde) ikke å bruke alle treningsdataene til trening. Dermed kan vi evaluere ulike typer modeller og i tillegg evaluere ulike spesifikasjoner for hver modell. Hvis modellen er logistisk regresjon, kan vi evaluere regresjoner med og uten interaksjoner, splinefunksjoner eller andre transformasjoner av prediktorer. Det samme gjelder for machine learning. Det innebærer at vi i dette trinnet kan identifisere de optimale parameterne.
Den beste modellen kan deretter brukes på alle treningsdataene for å estimere parameterne på nytt, og på testdataene for å evaluere modellens presisjon på nye og fremtidige data.
Mål på modellens prediktive evne (Evaluation metrics)
For å sammenligne modeller med kryssvalidering (eller andre metoder) må et mål på presisjon brukes. Det finnes en rekke ulike mål, og hvilket som er optimalt for en gitt problemstilling, varierer. Det finnes likevel tommelfingerregler som er adekvate i de fleste sammenhenger. Disse diskuteres i neste kapittel.