
Overlevelsesanalyse
Overlevelsesanalyse er et kraftig verktøy for å studere hendelser (events). Sentralt i overlevelsesanalyse er informasjon om observasjonstid. Med overlevelsesanalyse studerer man nemlig tid til en hendelse inntreffer. I engelskspråklig litteratur brukes betegnelsene survival analysis eller time-to-event analysis. Den sistnevnte betegnelsen, time-to-event analysis, er egentlig den mest korrekte, ettersom disse analysene kan brukes til å studere alle typer hendelser, ikke bare død. I dette kapittelet vil vi likevel bruke død som eksempel, fordi det gjør det lettere å forstå.
Fundamentet i overlevelsesanalyse er Kaplan-Meier-metoden og Cox-regresjon. Originalpublikasjonene for disse metodene er blant de mest siterte arbeidene noensinne i medisinsk forskning (1, 2).
For å gjennomføre overlevelsesanalyse trengs informasjon om observasjonstid, det vil si tidsperioden individet observeres. I sin reneste form starter observasjonstiden når individet inkluderes i studien, og observasjonstiden slutter når hendelsen inntreffer eller når studiens oppfølgingsperiode er over. Tidsperioden individet observeres kalles survival time.
Overlevelsesanalyse kan brukes til å studere tid til hendelser for andre organismer (for eksempel dyr, bakterier), virus eller til og med teknisk utstyr (for eksempel mobiltelefoner). Dersom formålet er å studere tid til en hendelse inntreffer, kan overlevelsesanalyse brukes uavhengig av hvilken type enhet som studeres.
Formålet med overlevelsesanalyse er som følger:
- Studere overlevelsesprosessen.
- Studere hvordan ulike prediktorer (variabler) påvirker overlevelse.
- Lage en prediksjonsmodell som predikerer (forutsier) overlevelse.
For å studere overlevelsesprosessen kan man bruke deskriptive metoder, hvorav den viktigste er Kaplan-Meier-estimatoren. Med Kaplan-Meier-metoden får man en grafisk (og matematisk) beskrivelse av overlevelse. Med metoden kan man også sammenligne overlevelsen mellom to eller flere grupper. Metoden er imidlertid en rent deskriptiv beskrivelse av overlevelse og tillater dermed ikke analyse av hvordan ulike prediktorer påvirker overlevelsen.
For å studere hvordan ulike prediktorer påvirker overlevelsen, kreves regresjonsanalyse. I dag domineres overlevelsesanalyse av Cox-regresjon (Cox Proportional Hazards Model), som gjør det mulig å lage en regresjonsmodell for overlevelse. Cox-regresjon er et svært kraftig verktøy, og det publiseres daglig tusenvis av artikler der Cox-regresjon er studiens hovedmetode.
Kaplan-Meier-estimatoren og Cox-regresjon er de viktigste verktøyene å beherske, og derfor dreier den videre diskusjonen seg om disse to metodene.
Overlevelsesanalyse vs. logistisk regresjon
Med overlevelsesanalyse studeres altså dikotome (binære) hendelser (events). Formålet er å studere om en hendelse inntreffer eller uteblir. I så henseende har overlevelsesanalyse likheter med logistisk regresjon (se Logistisk regresjon). Faktisk brukes logistisk regresjon også til å studere binære hendelser, inkludert overlevelse. Logistisk regresjon er imidlertid (i prinsippet) alltid et dårligere valg enn overlevelsesanalyse for å studere overlevelse dersom det finnes informasjon om observasjonstid. Dette skyldes at logistisk regresjon ikke kan ta hensyn til observasjonstiden. Selve observasjonstiden er nøkkelen til overlevelsesanalysen (det er faktisk fordelingen av survival time som studeres i overlevelsesanalyse), og den kan ikke tas hensyn til i en logistisk regresjon. La oss illustrere dette med et overdrevet eksempel:
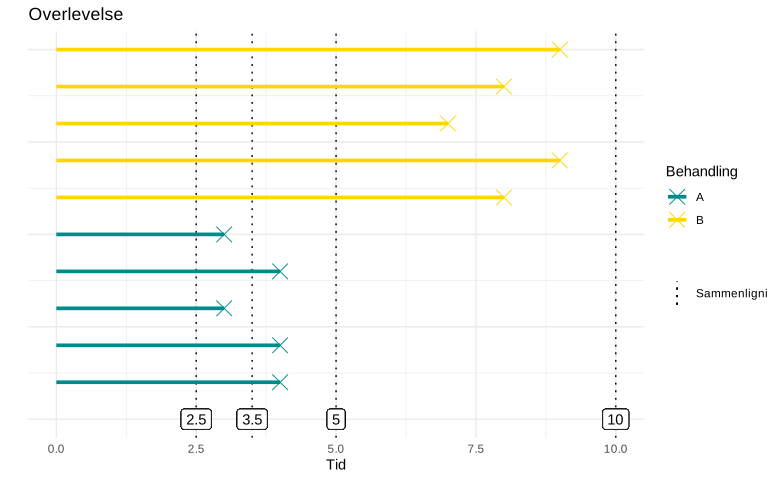
Vi studerer effekten av legemiddel A og B, som ble gitt til 10 pasienter med lungekreft. Disse pasientene ble fulgt fra inklusjon i opptil 10 år. Da oppfølgingen var over, var samtlige pasienter døde (se figuren ovenfor). Det betyr at like mange døde i begge grupper da studiens oppfølging var over. Vi gjennomfører en logistisk regresjon der overlevelse studeres (som et binært utfall) ved følgende tidspunkter:
- Tid 2,5: Ved dette tidspunktet er det ingen forskjell mellom gruppene.
- Tid 3,5: Ved dette tidspunktet er overlevelsen 5 av 5 i gruppe B og 3 av 5 i gruppe A. Risikoen for død er høyere i gruppe A.
- Tid 5: Alle i gruppe A har dødd, mens ingen har dødd i gruppe B. Risikoen for død i gruppe A er uendelig mye høyere enn i gruppe B.
- Tid 10: Alle er døde i begge grupper. Det er ingen forskjell mellom legemiddel A og B.
Det betyr at logistisk regresjon kan gi svært upålitelige resultater for en overlevelsesprosess. Figuren ovenfor viser at legemiddel B sannsynligvis er bedre enn A. Med overlevelsesanalyse ville vi kunne bekrefte dette, ettersom overlevelsesanalyse inkorporerer selve overlevelsestiden (survival time), som er forskjellig mellom gruppene. Med overlevelsesanalyse har vi større sjanse for å finne forskjeller i overlevelse. Man bør alltid foretrekke overlevelsesanalyse fremfor logistisk regresjon for å studere overlevelse. (Det skal imidlertid nevnes at logistisk regresjon under spesielle omstendigheter kan være ekvivalent med Cox-regresjon, men det diskuteres ikke i dette kapittelet.)
Event (outcome, utfallsmål, hendelsen) i overlevelsesanalyse
Utfallet i en overlevelsesanalyse er en hendelse (eng. event). Denne hendelsen kan i prinsippet være av hvilken som helst type. Eksempler på prosesser som kan studeres med overlevelsesanalyse, er som følger:
- Tid til død
- Tid til kreftdiagnose
- Tid til tilfriskning
- Tid til innleggelse på sykehus
- Tid til man blir arbeidsledig
- Tid til en datamaskin må repareres
- Tid til et næringsmiddel ikke lenger kan spises
Man kan altså studere alle typer hendelser med overlevelsesanalyse. Selve hendelsens natur er altså av underordnet betydning. Det er imidlertid forskerens ansvar å definere en tydelig og meningsfull hendelse. Alle personer eller enheter som inngår i populasjonen, skal følges fra tidspunktet de inkluderes i studien (da observasjonstiden starter) til oppfølgingen er over. Det er viktig å kunne datere tidspunktet for hendelsen (med så høy presisjon som mulig), slik at observasjonstiden kan beregnes med høy presisjon. Det er for eksempel bedre å registrere survival time i dager i stedet for måneder. Jo grovere mål på survival time, desto dårligere presisjon i analysen.
Prediktorer, kovariater og uavhengige variabler
Når overlevelsesanalyse brukes til å studere hvordan ulike variabler påvirker utfallet, gjøres det vanligvis med Cox-regresjon (Cox proportional hazards model). Variablene som studeres, kalles prediktorer (alternativt , kovariater eller uavhengige variabler). Alle disse tre betegnelsene kan brukes, og de viser altså til det samme.
Censoring (sensurering)
Overlevelsestid (eng. survival time) er en kontinuerlig variabel, og det kan derfor være fristende å bruke lineær regresjon for å studere overlevelse. Det er imidlertid ikke mulig å bruke lineær regresjon, og dette skyldes *sensurering (*eng. censoring). Det er stor sannsynlighet for at ikke alle personer vil rammes av hendelsen som studeres. De personene som overlever hele oppfølgingen (det vil si de som ikke rammes av hendelsen i løpet av studiens observasjonstid), utgjør et matematisk problem, fordi vi ikke kan si om eller når de vil rammes av hendelsen. Disse personene blir sensurert (eng. censored) når studiens oppfølging slutter (eng. end of follow-up). Det samme problemet oppstår dersom studiedeltakere trekker seg fra studien eller av en annen grunn ikke lenger kan følges opp. Disse personene blir også sensurert (fordi vi ikke vet om eller når de vil rammes).
Sensurering (censoring) innebærer at oppfølgingen er avsluttet og hendelsen ennå ikke har inntruffet.
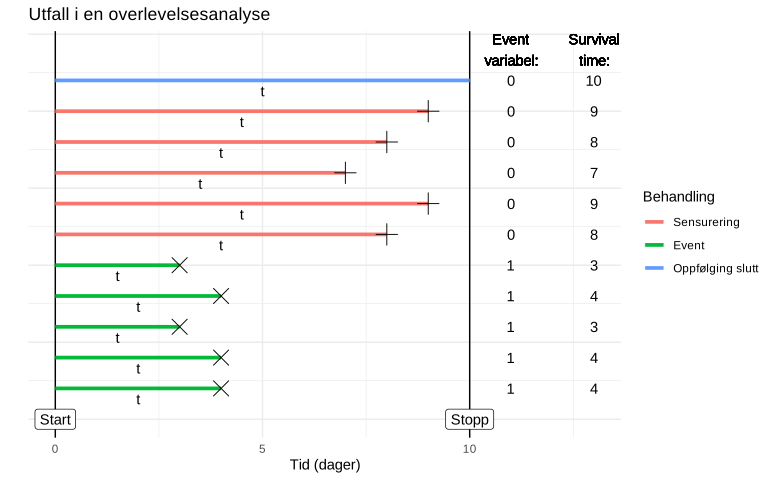
Man skiller mellom tre typer censoring:
- Right censoring: Dersom en person fullfører studien uten at hendelsen inntreffer, blir personen right censored. Det betyr at vi bare kan uttale oss om personens skjebne frem til øyeblikket oppfølgingen slutter. Personer som trekker seg fra studien (uansett grunn), blir også right censored.
- Left censoring: Vi er ofte interessert i hvordan en bestemt eksponering, for eksempel en sykdom, påvirker overlevelsen. Ofte er det imidlertid ukjent når en sykdom debuterer (oppstår). Det er svært vanlig at sykdommer har foreligget i mange år før de oppdages. Dersom det er ukjent når en eksponering startet, er individet left censored i så henseende. Left censoring innebærer altså at det er uklart når individets risiko startet. Dette pleier imidlertid ikke å være noe stort problem.
- Interval censoring: Dersom en person er både left og right censored, er den interval censored.
Koding av overlevelsesvariabler
For å analysere overlevelse trengs minst følgende to variabler:
- Event-variabel: Denne kodes oftest som 0 eller 1 og angir om eventet har inntruffet (1) eller uteblitt (0).
- Survival time: Survival time er observasjonstiden (kontinuerlig variabel).
Figuren ovenfor viser hvordan disse variablene ville blitt kodet for de 10 personene som følges i grafen.
Informativ vs. ikke-informativ censoring
Censoring må være uavhengig av (1) individets kovariater (prediktorer) for overlevelse og (2) hvor lenge individet har klart seg i studien. Censoring underveis i studien (før oppfølgingen er avsluttet) skal være tilfeldig, ellers foreligger det bias i studien. Anta at vi studerer hvordan et legemiddel påvirker risikoen for død. Legemiddelet viser seg å gi alvorlige bivirkninger, i den grad at mange personer som får legemiddelet, blir tvunget til å trekke seg fra studien. I så fall påvirkes censoring av en prediktor, nemlig legemiddelet, og da oppstår bias fordi pasientene trekker seg fra studien før de rekker å utvikle komplikasjoner. Dette fører til underestimering av antall events (dødsfall) og dermed overestimering av overlevelse. Denne typen censoring kalles informativ censoring, som innebærer at censoring ikke var tilfeldig. Dersom censoring er non-informative, vil fordelingen av survival time blant sensurerte tilfeller være lik mellom gruppene som sammenlignes.
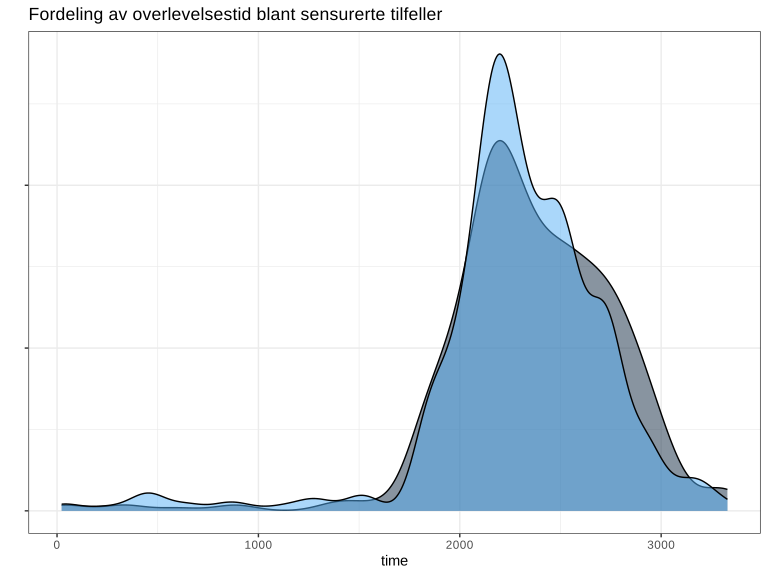
Censoring skal være ikke-informativ, noe som innebærer at censoring skal være tilfeldig. Det må ikke finnes noen mekanisme som påvirker sannsynligheten for censoring.
I neste kapittel diskuteres de to vanligste metodene for å studere overlevelse, nemlig Kaplan-Meier-metoden og Cox-regresjon.