
Cox-regresjon
Cox-regresjon er synonymt med overlevelsesanalyse. Dette skyldes metodens mange fordeler sammenlignet med andre regresjonsmodeller. Alternativene til Cox-regresjon, for eksempel Weibull-regresjon, gir under visse omstendigheter mer korrekte modeller, på bekostning av økt kompleksitet. Cox-regresjon er en enkel og kraftig modell for å studere overlevelse. Forskjellen mellom Cox-regresjon og Kaplan-Meier-estimatoren er at førstnevnte er en regresjonsmodell, noe som innebærer at vi kan studere hvordan flere prediktorer påvirker overlevelsen. Cox-regresjoner kan, i likhet med vanlig multippel regresjon, inkludere én eller flere prediktorer.
Kapitlene Overlevelsesanalyse og Kaplan-Meier-estimatoren bør leses før dette kapitlet. Det er ikke nødvendig å forstå alle formlene nedenfor for å bruke Cox-regresjon. Etter den matematiske diskusjonen nedenfor følger forklaringer og praktiske eksempler på gjennomføring og tolkning av Cox-regresjoner.
Med Cox-regresjon studeres sammenhengen mellom prediktorer (kovariater) og survival time (observasjonstid). For å forstå Cox-regresjon tar vi utgangspunkt i hazard function, , og survival function, .
- : Overlevelsesfunksjonen (survival function) er sannsynligheten for at en person skal være i live etter tidspunkt .
- Tolkning: Hva er sannsynligheten for at jeg lever om 1 år?
- : Hasardfunksjonen (hazard function, hazard rate) er den momentane risikoen (sannsynligheten) for at hendelsen skal inntreffe ved tidspunkt , forutsatt at personen har overlevd til .
- Tolkning: Hva er sannsynligheten for at jeg dør om 1 år, gitt at jeg har overlevd frem til nå?
og har egenskaper som gjør dem egnet til å studere overlevelse. Ikke minst fremgår dette av de relevante spørsmålene som funksjonene besvarer (se tolkning ovenfor).
Survival time (overlevelsestid, T) er en kontinuerlig variabel (ofte angitt som antall dager) og kan derfor beskrives med en kumulativ fordelingsfunksjon (cumulative distribution function, CDF):
beskriver sannsynligheten for at er mindre enn eller lik . Overlevelsestid betegnes med og kan også beskrives med en kumulativ fordelingsfunksjon:
beskriver sannsynligheten for at hendelsen inntreffer senest ved tidspunkt . Sannsynligheten for at et nyfødt barn skal dø ved 90 års alder er cirka 1 %, men hvis barnet når 89 års alder, er sannsynligheten for død på 90-årsdagen 10 %. Med kan vi estimere , som er sannsynligheten for at individet skal overleve tidspunkt :
er sannsynligheten for å overleve tidspunkt .
Hasardfunksjonen (hazard function) har følgende formel:
innebærer at kvoten gjelder når risiko (hazard) studeres over en svært kort tidsperiode, det vil si når (forskjellen i ) går mot . Telleren i inneholder |, som betyr at det er en betinget sannsynlighet. Telleren beskriver sannsynligheten for at hendelsen skal inntreffe i et lite tidsintervall mellom og , betinget på at individet overlevde frem til . Nevneren angir tidsintervallets lengde (). Hasardfunksjonen () er dermed ekvivalent med event rate (hastigheten som hendelser inntreffer med) for individer som ennå ikke har fått hendelsen.
Telleren i utgjør kvoten mellom sannsynligheten for at T skal ligge i intervallet til og , der sistnevnte er ekvivalent med og førstnevnte kan omformuleres som for små . Ved å dividere den kvoten med får vi følgende formel:
Dette er den enkle hasardfunksjonen. Den forteller at hastigheten som hendelser inntreffer med ved tidspunkt , er ekvivalent med tettheten (eng. density) av events ved tidspunkt , dividert med sannsynligheten for å overleve frem til tidspunkt uten å få hendelsen. Telleren er en tetthetsfunksjon (probability density function, PDF). Siden er den deriverte av , kan formelen skrives slik:
Hvis denne integreres fra til , og , kan følgende formel brukes til å beskrive sannsynligheten for å overleve til tidspunkt som en funksjon av hazard ved alle tidspunkter frem til .
Integralfunksjonen ovenfor er cumulative hazard (cumulative risk) og formuleres slik:
Kumulativ hazard er den akkumulerte risikoen et individ pådrar seg når det passerer fra til .
Med kan vi alltid beregne og dermed få . Med kan vi alltid beregne kumulativ hazard og eksponensiere den for å få .
Et individ som har overlevd frem til tidspunkt , er som regel mer interessert i sin betingede sannsynlighet for overlevelse enn i den ubetingede. I praksis betyr dette at et individ som har overlevd frem til tidspunkt etter en kreftdiagnose, er mer interessert i sin forventede overlevelse fra tidspunkt . Dessuten er hasardfunksjonen en enkel og pragmatisk beregning når observasjonene er høyresensurerte.
Cox-regresjon
Med Cox-regresjon beskrives hazard for et individ med prediktorene (kovariatene) slik:
Der er baseline hazard, som er individets risiko når alle variabler har verdien 0 (for kontinuerlige variabler) eller er på referansenivået (for kategoriske variabler), og er eksponensierte prediktorer. Den eneste størrelsen ovenfor som inneholder , er baseline hazard. Som det fremgår nedenfor, vil baseline hazard automatisk elimineres, og dermed blir hazard uavhengig av .
Hvis alle prediktorer har verdien 0, elimineres hele eksponenten, og formelen blir slik:
.
Formelen ovenfor er definisjonen av baseline hazard, altså hazard når alle prediktorer har verdien 0. Baseline hazard er uinteressant i Cox-regresjon. Det gjøres ingen antakelser om baseline hazard, og den får variere fritt. Forklaringen på dette er at formålet med Cox-regresjon er å sammenligne eksponeringer (for eksempel behandlinger, intervensjoner osv.), og når to individer sammenlignes, eliminerer de hverandres baseline hazard, noe som demonstreres nedenfor.
Hvis begge sider av ligningen logaritmeres, får vi en modell der prediktorenes effekter er additive (det vil si at de har en uavhengig innvirkning på utfallet som studeres) og lineære, noe som minner om klassisk lineær regresjon.
Anta at vi studerer assosiasjonen mellom prediktoren kjønn og overlevelse. Kjønn er definert slik:
For denne variabelen er mann referansegruppe. Cox-regresjonen for denne modellen er slik:
Hazard for menn:
Hazard for kvinner:
Hazard ratio (HR, hasardratio)
Hazard ratio (HR) beregnes som kvoten mellom gruppenes hazard, der referansegruppen (menn) utgjør nevneren:
Effekten av er den samme ved alle . Formelen innebærer, og fungerer bare, hvis hazard ratio ikke varierer over tid. Cox' modell kalles også Cox proportional hazards model av denne grunn.
Cox-regresjon innebærer altså at hazard (risiko) ved tidspunkt er produktet av baseline hazard og eksponenten av prediktorenes samlede effekt.
Cox-regresjon i praksis
Baseline hazard i Cox-regresjon
er baseline hazard, og denne størrelsen kan være vanskelig å forstå. Baseline hazard er risikoen individet har når verdien av alle prediktorer er 0. To eksempler følger:
- Anta at vi studerer hvordan alder påvirker dødelighet. I en Cox-regresjon der alder er den eneste prediktoren, ville baseline hazard være risikoen mennesket har ved alder = 0 år. Etter fødselen tilkommer det risiko etter hvert som alderen øker.
- Anta at vi studerer hvordan blodtrykk påvirker dødelighet. I en slik modell ville baseline hazard være individets risiko ved blodtrykk = 0, noe som ikke er biologisk meningsfullt (ingen levende person har blodtrykk = 0). Dette innebærer at baseline hazard er individets risiko når alle prediktorer settes til 0, noe som er det samme som at modellen mangler prediktorer.
Prediktorer (kovariater) i Cox-regresjon
er de prediktorene (kovariatene) som brukes til å modellere et individs hazard function. Samlingen av prediktorer ligner dermed en vanlig multippel (lineær) regresjon. Prediktorene kan være kontinuerlige eller kategoriske variabler. Prediktorene utøver en additiv effekt, noe som innebærer at hver enkelt prediktor har en uavhengig (av de andre prediktorene) effekt på utfallet (). Videre er sammenhengen mellom prediktorene og utfallet lineær. Antakelsene om additivitet og linearitet kan modifiseres (se nedenfor).
Proportional hazards
Som nevnt ovenfor er hazard (risiko) ved tidspunkt produktet av baseline hazard og eksponenten av prediktorenes samlede effekt. Dette stemmer under antakelsen om at hazard er proporsjonal over tid. Proportional hazard innebærer at ratioen (kvoten) mellom to individers hazard function skal være konstant over tid. Dette gjelder for alle karakteristika som definerer individene. Et eksempel følger.
Hvis vi studerer dødelighet blant personer med eller uten diabetes, må kvoten mellom diabetikeres og ikke-diabetikeres hazard function være konstant under hele oppfølgingen. Hvis det er 2 ganger økt risiko for død for diabetikere i begynnelsen av oppfølgingen, skal det være like høy risiko (2 ganger økt risiko) for diabetikere gjennom hele studiens oppfølging.
Kvoten mellom to hazard functions er hazard ratio (HR). Det er altså den relative forskjellen i risiko for to individer. Siden inngår i både telleren og nevneren, elimineres den. I ligningen finnes heller ikke tid. Dermed er det bare verdiene på prediktorene som skiller individ 1 og individ 2; verken baseline hazard eller tid kan påvirke hazard ratio, som derfor er konstant mellom individ 1 og individ 2. Det innebærer også at hvis noen av prediktorene () skulle ha en varierende effekt over tid, vil kravet om proportional hazards ikke være oppfylt, og modellen blir ugyldig.
Hazard ratio (hasardratio)
Hazard ratio beregnes ved å dividere hazard for ett individ med hazard for et annet individ (se formel ovenfor). Hazard ratio beregnes når en hendelse inntreffer. Hvis en hendelse inntreffer ved tidspunkt t, beregnes hazard ratio ved å dividere hazard for individet som fikk hendelsen, med hazard for de øvrige som klarte seg frem til tidspunkt t uten å få hendelsen. Baseline hazard faller bort (se ovenfor) fra kvoten, og likeledes er tidspunktet irrelevant fordi alle individer sammenlignes ved samme tidspunkt. Det som karakteriserer individene, blir dermed prediktorene deres (x1, x2 … xk). Dermed kan effekten av prediktorene analyseres.
I en Cox-regresjon beregnes dermed koeffisientene for prediktorene (), som er disse prediktorenes innvirkning på overlevelsen. Den hazard ratio som oppnås når to individers hazard divideres, er logaritmert, noe som også gjør den vanskelig å tolke. For å rette på dette eksponensieres koeffisienten. Hvis regresjonskoeffisienten er 0,5, blir den eksponensierte koeffisienten e0,5 = 1,65. Når vi bruker termen hazard ratio, refererer vi egentlig til den eksponensierte koeffisienten.
Tolkning av hazard ratio
- For en kontinuerlig prediktor er hazard ratio den økningen/reduksjonen i hazard som følger når prediktoren øker med én enhet.
- For en kategorisk variabel er hazard ratio forskjellen i hazard mellom to (eller flere grupper), der én av gruppene er referansegruppe.
For å forstå dette bedre trenger vi et eksempel, og vi lager dette eksemplet selv i R.
Eksempel på Cox-regresjon i R
Vi skal bruke data fra en klinisk studie om koloncancer (tykktarmskreft). Disse dataene finnes i pakken survival, som også inneholder mange viktige funksjoner for overlevelsesanalyse.
## Aktiver tidyverse
library(tidyverse)

## Aktiver survival-pakken
library(survival)

## Importer eksempeldata
data(cancer)
## Inspiser de første radene
head(colon)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1Vi koder om enkelte variabler slik at de blir korrekt klassifisert som kategoriske:
## Koder om enkelte kategoriske variabler
colon <- colon |>
  mutate(sex = recode_factor(sex, '1'='Man', '0'='Kvinna'),
         perfor = recode_factor(perfor, '1'='Yes', '0'='No'),
         obstruct = recode_factor(obstruct, '1'='Yes', '0'='No'))
Nå lager vi en Cox-regresjon ved hjelp av funksjonen coxph(). Resultatet lagres i objektet min_modell. Merk at vi må spesifisere et overlevelsesobjekt ved hjelp av funksjonen Surv(). I Surv() spesifiserer vi hvilke variabler som utgjør observasjonstid (time) og utfallet (status). I dette tilfellet spesifiserer vi at status==1 angir hvilken verdi på status som innebærer at hendelsen har inntruffet.
min_modell <- coxph(Surv(time, status==1) ~ sex + age + nodes + perfor + obstruct, data=colon)

## Skriv ut resultatet
summary(min_modell)Call:
coxph(formula = Surv(time, status == 1) ~ sex + age + nodes +
perfor + obstruct, data = colon)
n= 1822, number of events= 897
(36 observations deleted due to missingness)
coef exp(coef) se(coef) z Pr(>|z|)
sexKvinna 0.057961 1.059674 0.067077 0.864 0.38753
age 0.001363 1.001364 0.002822 0.483 0.62911
nodes 0.088342 1.092362 0.006342 13.929 < 2e-16 ***
perforNo -0.223009 0.800107 0.181919 -1.226 0.22025
obstructNo -0.249065 0.779529 0.082675 -3.013 0.00259 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
exp(coef) exp(-coef) lower .95 upper .95
sexKvinna 1.0597 0.9437 0.9291 1.2086
age 1.0014 0.9986 0.9958 1.0069
nodes 1.0924 0.9154 1.0789 1.1060
perforNo 0.8001 1.2498 0.5601 1.1429
obstructNo 0.7795 1.2828 0.6629 0.9167
Concordance= 0.635 (se = 0.009 )
Likelihood ratio test= 145.1 on 5 df, p=<2e-16
Wald test = 202.8 on 5 df, p=<2e-16
Score (logrank) test = 206.2 on 5 df, p=<2e-16Utskriften ovenfor er riktignok informativ, men den mangler en del informasjon og er ikke estetisk tiltalende nok til å tas med i en rapport. Ved hjelp av pakken gtsummary kan vi lage en estetisk tiltalende tabell som er lett å modifisere. Funksjonene i gtsummary fungerer som de øvrige funksjonene i tidyverse, noe som innebærer at man trinnvis legger til lag med komponenter, som vist nedenfor. Du kan sannsynligvis gjette hva de ulike funksjonene legger til i tabellen.
library(gtsummary)

min_modell |>
  tbl_regression(exponentiate = TRUE) |>
  add_global_p() |>
  bold_labels() |>
  italicize_levels() |>
  add_nevent() |>
  add_glance_source_note()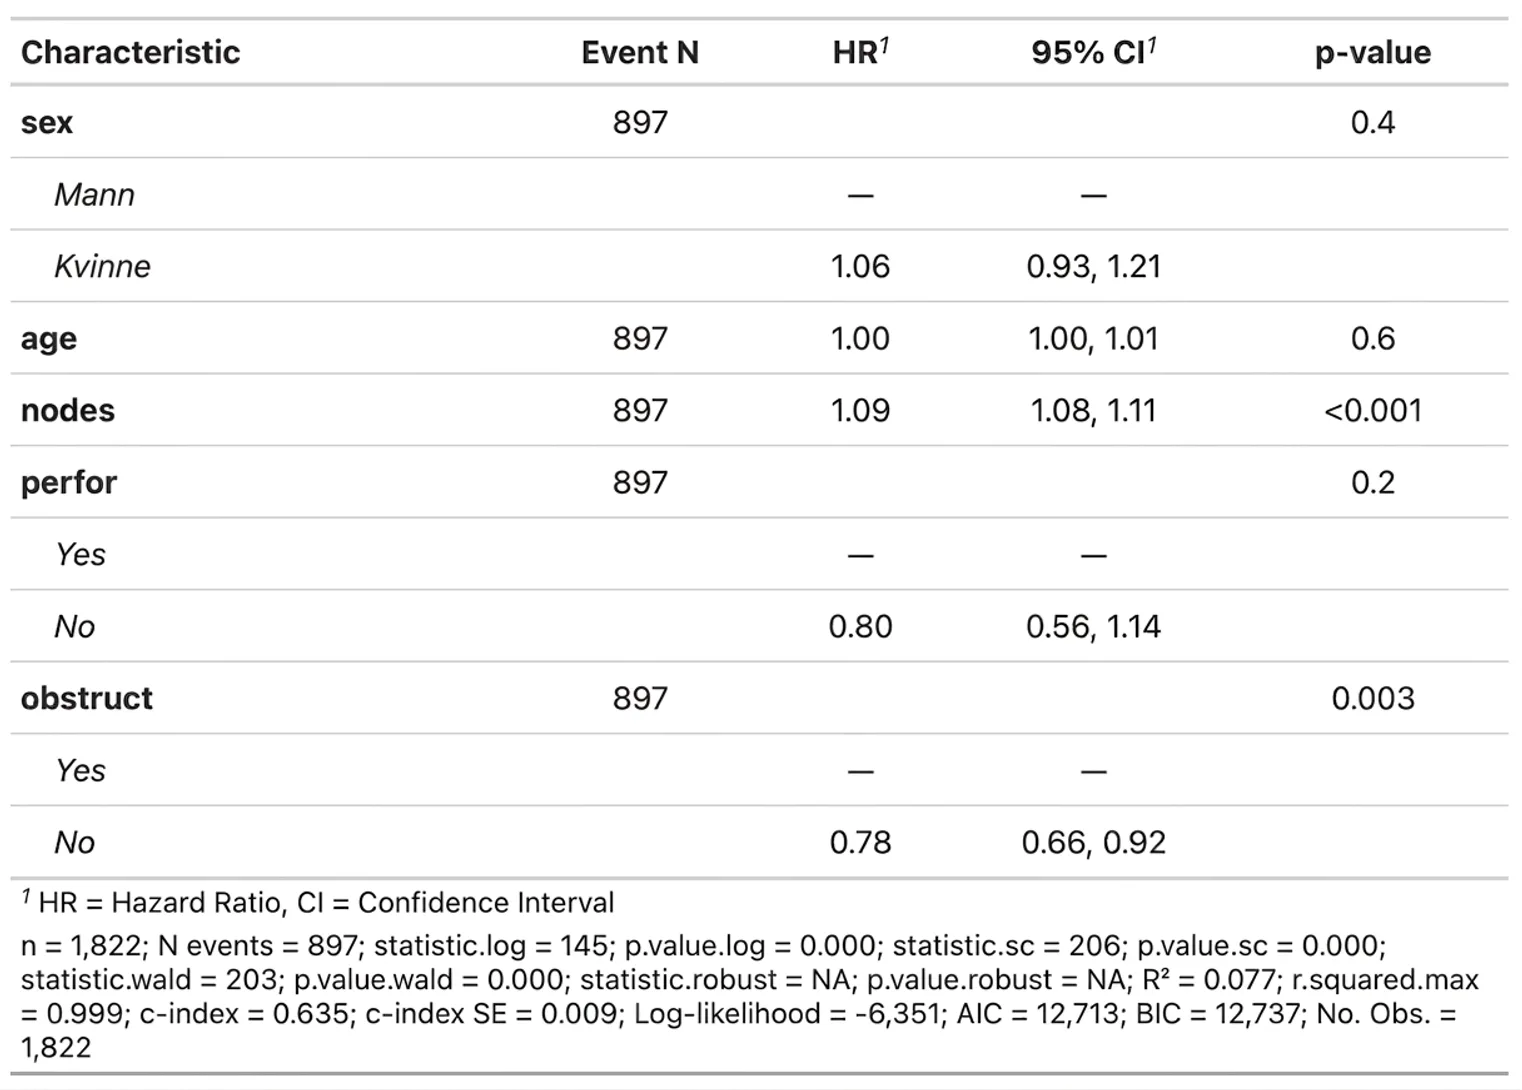
Tolkning av Cox-regresjon
Modellen ovenfor har fem prediktorer: sex, age, nodes, perfor og obstruct. Sex er en kategorisk prediktor med nivåene Man og Kvinna. Age og nodes er kontinuerlige prediktorer. Hazard ratio (HR) presenteres sammen med et 95 % konfidensintervall (95 % KI). Hazard ratio-ene ovenfor tolkes slik:
- For menn er det ikke angitt noen hazard ratio. Dette skyldes at menn er referansenivået for variabelen sex. Alle kategoriske variabler har et referansenivå som de øvrige nivåene sammenlignes med.
- Hazard ratio for kvinner er 1,06, noe som innebærer at den relative risikoen er 1,06 ganger høyere (det vil si 6 % høyere) for kvinner sammenlignet med menn. Konfidensintervallet er 0,93 til 1,21. Det betyr at den sanne risikoen for kvinner med 95 % sannsynlighet ligger mellom 0,93 (som innebærer at risikoen er 7 % lavere for kvinner sammenlignet med menn) og 1,21 (som innebærer at risikoen er 21 % høyere for kvinner sammenlignet med menn). Dette konfidensintervallet omfatter altså tallet 1,0, noe som innebærer at det finnes en sannsynlighet for både lavere og høyere risiko for kvinner sammenlignet med menn. Derfor er variabelen sex ikke statistisk signifikant. Det fremgår også av p-verdien, som er 0,4.
- Av det ovenstående følger at hvis et konfidensintervall omfatter tallet 1,0, er prediktoren ikke statistisk signifikant.
- Av det ovenstående følger også at en kategorisk prediktor må ha et referansenivå som de øvrige nivåene sammenlignes med.
- For variabelen age er hazard ratio 1,00, og konfidensintervallet omfatter også 1,00, noe som gjør at variabelen ikke er en statistisk signifikant prediktor.
- For variabelen nodes er hazard ratio 1,09, noe som innebærer at hver gang nodes øker med 1 enhet, øker risikoen for hendelsen (død) med 9 %. Konfidensintervallet er 1,08 til 1,11, noe som innebærer at den sanne verdien med 95 % sannsynlighet ligger mellom 8 % og 11 % økt risiko for hendelsen hver gang nodes stiger med 1 enhet. P-verdien er <0,001, noe som er tydelig signifikant.
- For hver prediktor i modellen er hazard ratio justert for de øvrige variablene i modellen. Effekten av å øke nodes med 1 enhet er 1,09 (9 % økt risiko), justert for de øvrige prediktorene i modellen.
- Denne modellen inkluderer altså også age og meal.cal, i tillegg til sex. Da er effekten av sex justert for effekten av de øvrige prediktorene i modellen (de øvrige prediktorene «holdes konstante»).
Konfidensintervallet i Cox-regresjon
Oftest brukes Walds konfidensintervall, som er en enkel beregning med standardfeil (standard error, SE):
Nedre grense: HR − 1,96×SE
Øvre grense: HR + 1,96×SE
Der HR er hazard ratio og SE er standardfeilen.
Mer om proportional hazards (PH)
Proportional hazard kan også forklares gjennom interaksjoner mellom en prediktor og tid (oppfølgingstid). Hvis en prediktor oppfyller kriteriet for proportional hazard, skal det ikke finnes noen statistisk signifikant interaksjon mellom den prediktoren og oppfølgingstiden (survival time). Man kan dermed lage et interaksjonsledd (prediktor × oppfølgingstid) og vurdere om det er statistisk signifikant. Hvis interaksjonen ikke er signifikant, innebærer det at prediktoren utøver samme effekt på hazard function ved alle verdier av t (oppfølgingstid), og da er kriteriet for proportional hazard oppfylt. Hvis interaksjonen derimot er signifikant, innebærer det at effekten av prediktoren varierer over tid, og da strider den variabelen mot antakelsen om proportional hazard. Det finnes flere måter å vurdere proportional hazards på, og disse er som følger:
- Vurdering av Schoenfeld-residualer
- Visualisere log(-log S(t)) mot t
Egentlig bør man foretrekke de to sistnevnte metodene fremfor interaksjonsledd. I R finnes enkle funksjoner som presenterer både Schoenfeld-residualer og grafer over log(-log S(t)) mot t.
For å vurdere antakelsen om PH kan følgende kode brukes:
library(survminer)

cox_ph <- cox.zph(min_modell)

ggcoxzph(cox_ph)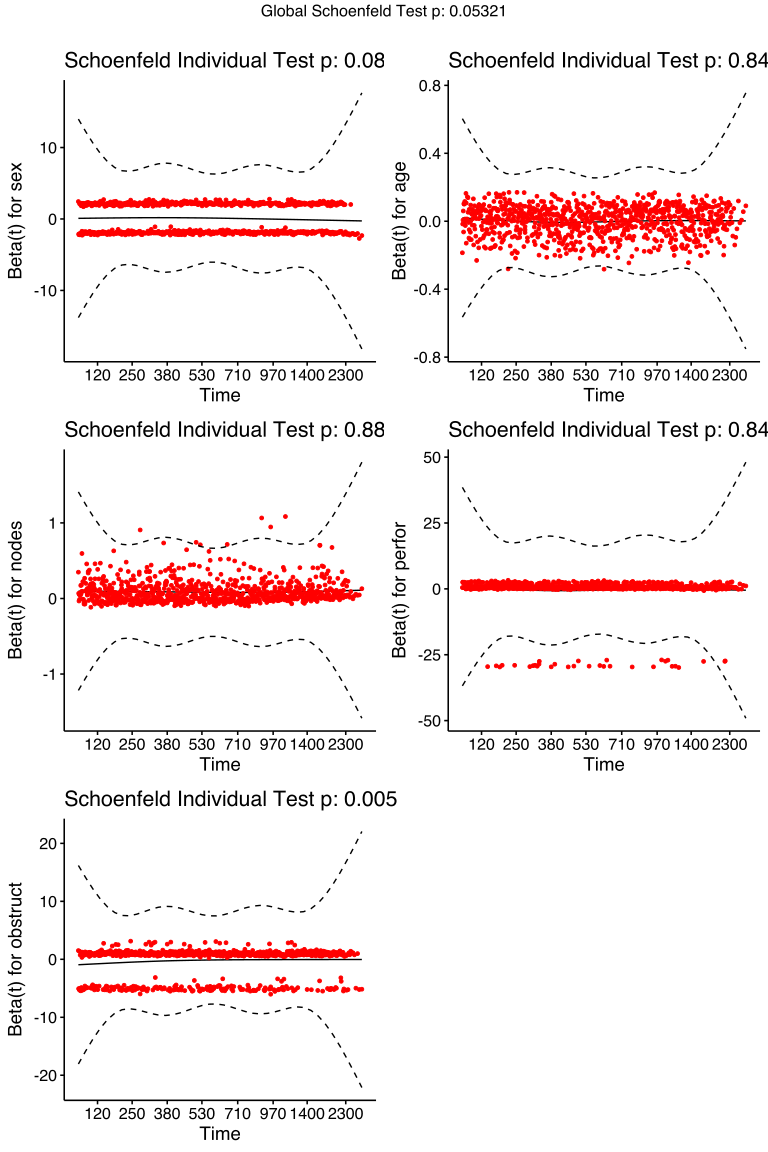
Grafene ovenfor viser hvordan varierer over tid for hver enkelt prediktor. Det skal ikke være noen helning eller systematisk trend bort fra den horisontale linjen. Hvis så er tilfellet, er effekten av konstant over tid, og antakelsen om proportional hazard er oppfylt.
Hvis en variabel strider mot antakelsen om PH, kan dette håndteres på en av følgende måter:
- Inkluder en interaksjon mellom variabelen og tid i modellen.
- Stratifiser på den variabelen som strider mot PH. Ulempen med dette er at man ikke får en hazard ratio for en variabel som brukes til å stratifisere. Dette er imidlertid bare et problem hvis man er interessert i hazard ratio for nettopp den variabelen.
Stratifisert Cox-regresjon
Cox-regresjonen gir mulighet til å justere for variabler som ikke inngår i modellen, og dette gjøres ved å stratifisere. Man må ikke forveksle stratifisering ved Cox-regresjon med stratifisering ved vanlig lineær (multippel) regresjon.
For vanlig lineær (multippel) regresjon innebærer stratifisering at man lager separate modeller ut fra en kategorisk variabel. Anta at vi studerer hvordan alder påvirker blodtrykk, og at vi også har informasjon om vekt. Hvis vi vil vite hvordan alder påvirker blodtrykk i ulike vektkategorier, kan vi stratifisere analysen ved å gjøre én regresjon for normalvektige, én regresjon for overvektige og én regresjon for personer med fedme. Dette er altså tre separate modeller som gir separate koeffisienter for alder.
For Cox-regresjon kan stratifiseringen håndteres annerledes. Cox-regresjon lar oss stratifisere data (observasjonene) ut fra en kategorisk variabel. Baseline hazard tillates å variere mellom disse strata. Modellen kan deretter estimere en samlet (kumulativ) effekt av alder i alle strata. Da får vi bare én koeffisient for alder, i stedet for separate koeffisienter i hvert stratum. Man kan si at effekten av alder «pooles» (vektes sammen) i alle strata.
Det finnes flere situasjoner der det er klokt å stratifisere modellen. Hvis en variabel strider mot antakelsen om proportional hazard, kan man kategorisere variabelen i to eller flere passende nivåer og stratifisere modellen på den variabelen. Da har man justert for variabelen, og man trenger ikke bekymre seg for at den strider mot proportional hazards. Ulempen er at man ikke får noen regresjonskoeffisienter for variabelen (men hvis den uansett ikke er av interesse for analysen, er dette ingen stor ulempe.
Med følgende kode stratifiseres Cox-regresjonen på kjønn (sex):
min_modell <- coxph(Surv(time, status==1) ~ strata(sex) + age + nodes + perfor + obstruct, data=colon)Vi skriver ut resultatet med funksjonen tbl_regression(), slik:
min_modell|>
  tbl_regression(exponentiate = TRUE) |>
  add_global_p() |>
  bold_labels() |>
  italicize_levels() |>
  add_nevent() |>
  add_glance_source_note()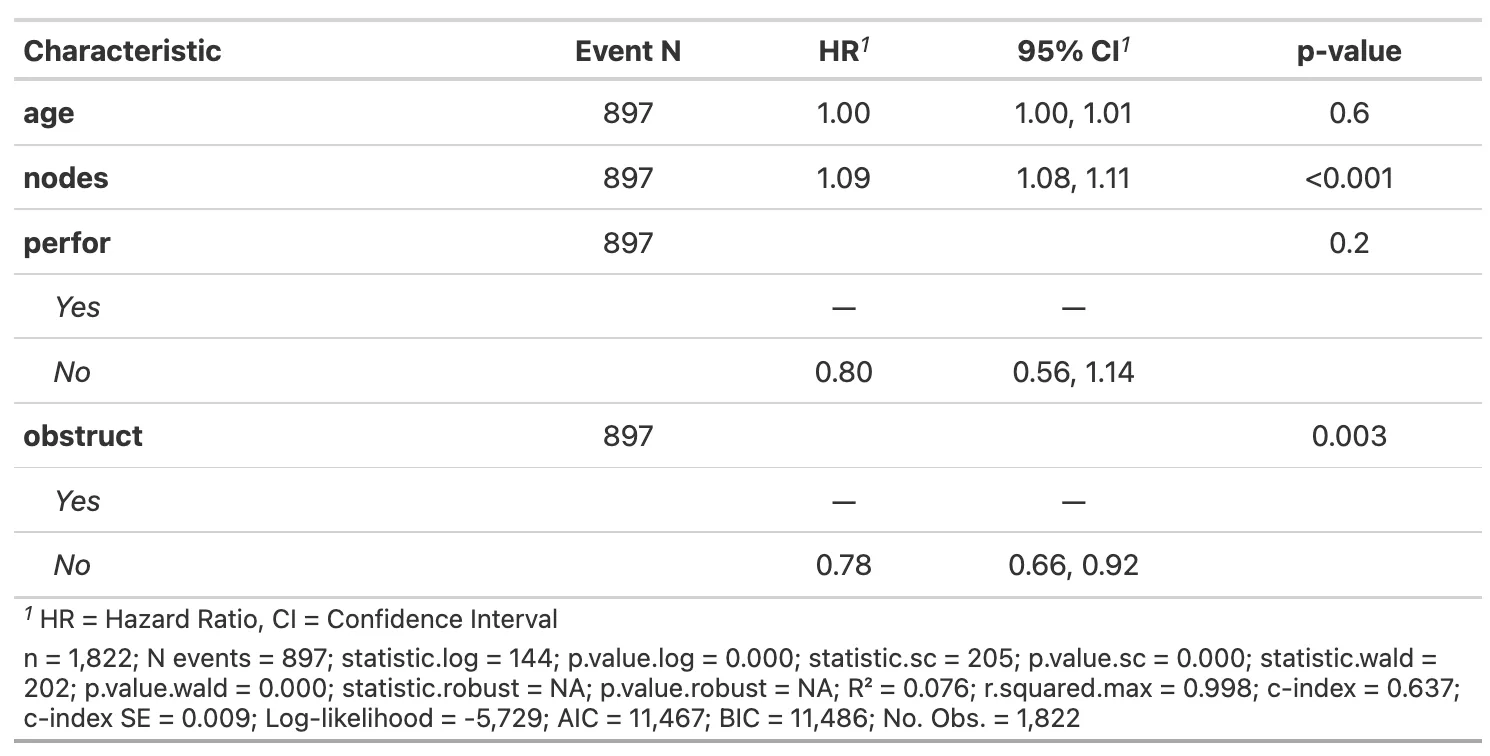
Som det fremgår av ovenstående, har stratifiseringen ikke påvirket hazard ratio-ene for de øvrige prediktorene i modellen.
Referanser
Germán Rodríguez, Survival Models, Princeton university.
Cox DR and Oakes D (1984). Analysis of Survival Data. Chapman and Hall, New York.
Kalbfleisch JD and Prentice RL (2002). The Statistical Analysis of Failure Time Data. Second Edition. Wiley, New York.
Klein and Moeschberger (1997). Survival Analysis: Techniques for Censored and Truncated Data. Springer-Verlag, New York.
Lagakos SW (1979). General right censoring and its impact on the analysis of survival data, Biometrics 35:139-156.
Lawless JF (2003). Statistical Models and Methods for Lifetime Data. Wiley, New York.
Clark, T., Bradburn, M., Love, S., & Altman, D. (2003). Survival analysis part I: Basic concepts and first analyses. 232-238. ISSN 0007-0920.
M J Bradburn, T G Clark, S B Love, & D G Altman. (2003). Survival Analysis Part II: Multivariate data analysis – an introduction to concepts and methods. British Journal of Cancer, 89(3), 431-436.
Bradburn, M., Clark, T., Love, S., & Altman, D. (2003). Survival analysis Part III: Multivariate data analysis – choosing a model and assessing its adequacy and fit. 89(4), 605-11.
Clark, T., Bradburn, M., Love, S., & Altman, D. (2003). Survival analysis part IV: Further concepts and methods in survival analysis. 781-786. ISSN 0007-0920.