
Overlevelsesfunksjon (survival function) og hazard function
Forrige kapittel (Overlevelsesanalyse) er en forutsetning for å forstå dette kapittelet.
Overlevelse (survival time) er en kontinuerlig variabel som kan beskrives med to enkle funksjoner:
- : Overlevelsesfunksjonen (survival function) er sannsynligheten for at en person skal være i live etter tidspunkt t.
- : Hasardfunksjonen (hazard function) beskriver den umiddelbare risikoen for at hendelsen (event) skal inntreffe ved tidspunkt t, forutsatt at personen har overlevd frem til tidspunkt t.
Alle kontinuerlige variabler (inkludert survival time) kan beskrives med en kumulativ fordelingsfunksjon (cumulative distribution function, CDF). Disse funksjonene er sannsynlighetsfordelinger som defineres slik:
Funksjonen beskriver sannsynligheten for at er mindre enn eller lik . Overlevelsestid, , har også en kumulativ fordelingsfunksjon:
Denne funksjonen beskriver sannsynligheten for at eventet inntreffer på eller før tidspunkt , men ikke senere enn . Målet vårt er imidlertid å estimere , som er sannsynligheten for at individet har overlevd tidspunkt (dvs. ikke har fått hendelsen ved tidspunkt ). er altså sannsynligheten for å overleve tidspunkt :
har en trappetrinnsliknende form, noe som fremgår av grafen nedenfor (Kaplan-Meier-kurve). Grafen beskriver hvordan sannsynligheten for overlevelse avtar over tid. Plusstegnene (+) på grafen angir tidspunkter da personer ble sensurert. påvirkes ikke av sensureringer. avtar bare når ett eller flere individer får eventet.
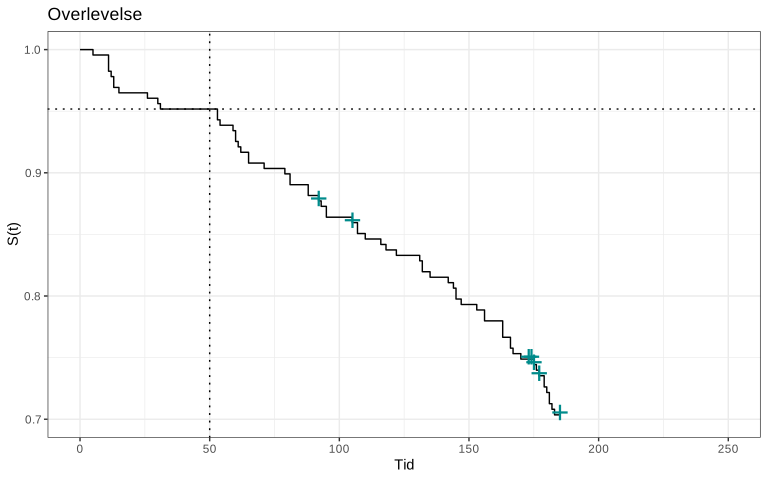
I grafen ovenfor er verdien av 0,952 ved , noe som betyr at sannsynligheten for å overleve minst 50 dager er 95,2 %, og 4,8 % har fått hendelsen ved . Medianoverlevelsen er tidspunktet da 50 % av populasjonen har fått eventet, dvs. .
Kaplan-Meier-estimator (Product Limit Estimator)
Det er alltid viktig å visualisere overlevelsen med en graf, fordi den viser hvordan overlevelsesprosessen utvikler seg over tid. Den vanligste metoden for å presentere er ved hjelp av Kaplan-Meier-estimatoren (Kaplan-Meier-kurve, Product Limit Estimator), som er vist i figuren ovenfor.
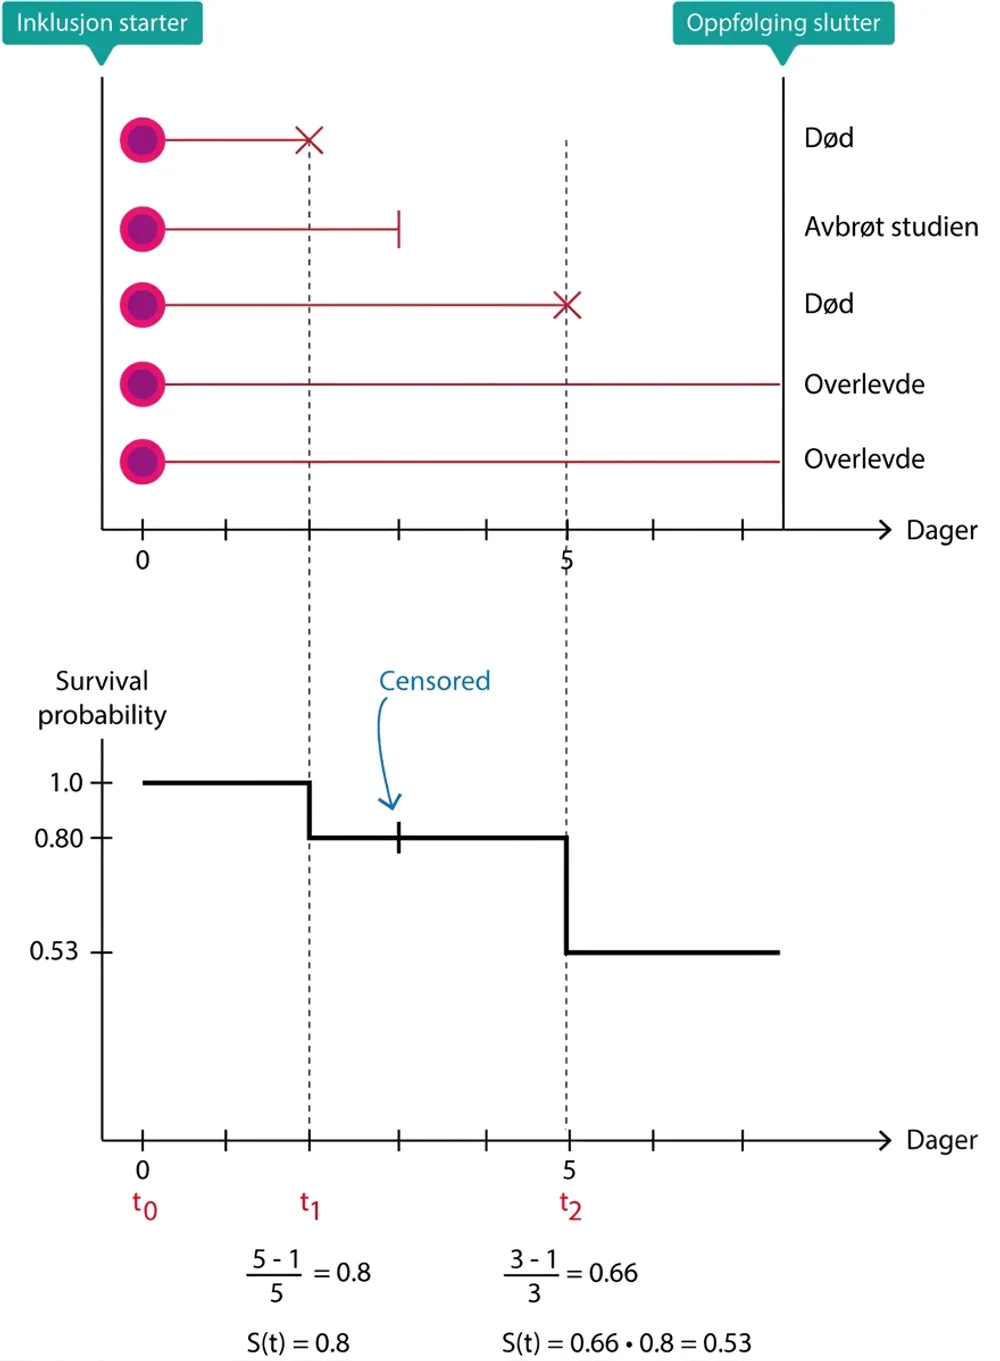
For å lage en Kaplan-Meier-kurve må survival time (oppfølgingstiden) brytes ned i intervaller. Hvert intervall begynner når et event inntreffer. Alle tidspunkter da hendelser inntreffer (event times) rangeres, fra første til siste event. Ved inntreffer den første hendelsen, ved inntreffer den andre hendelsen, ved inntreffer den tredje hendelsen og så videre. Studien begynner ved , og da har ennå ingen hendelse inntruffet. Ved er , noe som betyr at sannsynligheten for overlevelse er 100 %.
For å beregne ved gjøres følgende beregning:
= antall pasienter observert i begynnelsen av
= antall events ved
Dette er andelen pasienter som overlever etter , blant de pasientene som overlevde frem til . For å beregne sannsynligheten for å overleve etter , forutsatt at man klarer seg frem til da, gjøres beregningen i to trinn:
er produktet av sannsynligheten for å overleve frem til , som blir:
Dette er illustrert i figuren nedenfor.
| Tidspunkt (x) | Antall i risiko | Antall events | Antall sensurerte | Overlevelse (y) |
|---|---|---|---|---|
| 0 | 228 | 0 | 0 | 1.00000000 |
| 5 | 228 | 1 | 0 | 0.99561404 |
| 11 | 227 | 3 | 0 | 0.98245614 |
| 12 | 224 | 1 | 0 | 0.97807018 |
| 13 | 223 | 2 | 0 | 0.96929825 |
| 15 | 221 | 1 | 0 | 0.96491228 |
| 26 | 220 | 1 | 0 | 0.96052632 |
| 30 | 219 | 1 | 0 | 0.95614035 |
| 31 | 218 | 1 | 0 | 0.95175439 |
| 53 | 217 | 2 | 0 | 0.94298246 |
| 54 | 215 | 1 | 0 | 0.93859649 |
| 59 | 214 | 1 | 0 | 0.93421053 |
| 60 | 213 | 2 | 0 | 0.92543860 |
| 61 | 211 | 1 | 0 | 0.92105263 |
| 62 | 210 | 1 | 0 | 0.91666667 |
| 65 | 209 | 2 | 0 | 0.90789474 |
| 71 | 207 | 1 | 0 | 0.90350877 |
Survival probability er på Kaplan-Meier-kurven. Dette er altså andelen som fortsatt er i live ved hvert tidspunkt. Kurven går gradvis nedover etter hvert som personer får eventet. Kaplan-Meier-kurven når bare dersom alle deltakerne får eventet. Medianoverlevelsen er rett og slett andelen som lever ved .
Hypotesetest og overlevelsesanalyse: log-rank-test
Teste forskjell mellom overlevelseskurver
I følgende figur sammenlignes overlevelsen mellom menn og kvinner.
21.7.1 R-kode for Kaplan-Meier-kurven ovenfor
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)

## Last inn eksempeldata
data(colon)

## Inspiser de første 10 radene
head(colon, 10)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1Overlevelsesfunksjonen genereres med funksjonene survfit() og Surv(). I Surv() er første argument overlevelsestid (time) og andre argument er event-variabelen. For event-variabelen kan vi spesifisere hvilket nivå som angir at hendelsen har inntruffet. Dette gjør vi nedenfor ved å spesifisere status==1. Med argumentet pval = TRUE ber vi om hypotesetesting med log-rank-test. Denne testen beregner sannsynligheten for at nullhypotesen ( stemmer (nullhypotesen postulerer at det ikke finnes noen forskjell i overlevelse. Hvis p-verdien som genereres med log-rank-test er < 0,05, forkastes . I dette tilfellet sammenlignes menn med kvinner ved å inkludere variabelen sex som stratum:
## Lag survfit-objekt. I dette objektet lages overlevelsesfunksjonen
fit <- survfit(Surv(time, status==1) ~ sex, data = lung)

## Tegn Kaplan-Meier-kurve
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)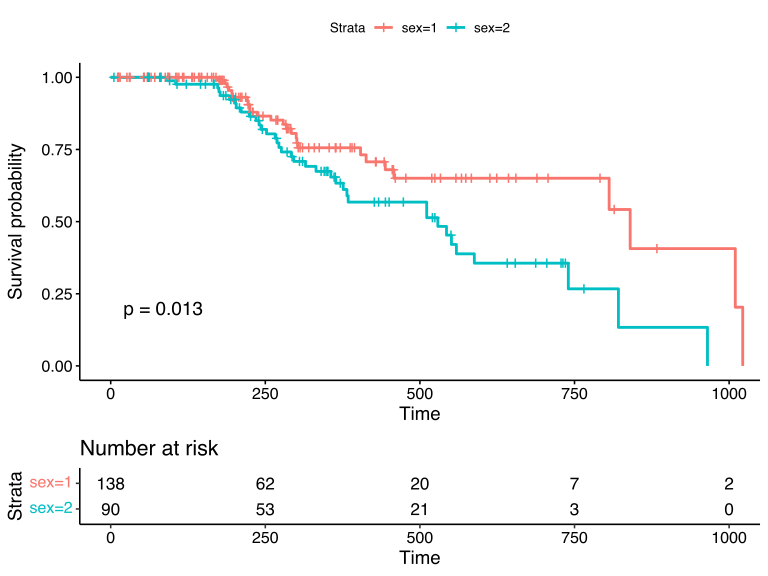
Som det fremgår ovenfor, er kurvene atskilt, noe som betyr at overlevelsen er forskjellig for menn (sex=2) og kvinner (sex=1). Ved hvert tidspunkt er høyere for kvinner. Det betyr at overlevelsen er bedre for kvinner, og dette kan altså vurderes visuelt. P-verdien er 0,013, noe som også indikerer at forskjellen er statistisk signifikant. P-verdien er beregnet med log-rank-test.
Prinsippet for log-rank-test følger prinsippet for hypotesetesting. Man tar utgangspunkt i nullhypotesen (), som postulerer at det ikke finnes noen forskjell mellom gruppene, og deretter beregnes en sannsynlighet (p-verdi) for at nullhypotesen stemmer. Hvis sannsynligheten er <0,05, forkastes nullhypotesen. Log-rank-test kan brukes til å sammenligne to eller flere overlevelseskurver.
Kaplan-Meier-kurven kan dermed brukes til å studere overlevelse. Dette kan gjøres i hele populasjonen eller i undergrupper (f.eks. menn og kvinner). Man kan imidlertid ikke justere for kovariater i en Kaplan-Meier-beregning; dette krever regresjonsanalyse, der den vanligste metoden er Cox-regresjon, som diskuteres i neste kapittel.