
Overlevelsesanalyse (survival analysis): fra Kaplan-Meier til Cox-regresjon
En revidert versjon av dette kapitlet finner du her:
Overlevelsesanalyse er et kraftig verktøy for å studere hendelser (events). Sentralt i overlevelsesanalyse er informasjon om observasjonstid. Man studerer nemlig alltid tiden til en hendelse inntreffer. I engelsk litteratur brukes betegnelsene survival analysis eller time-to-event analysis. Den sistnevnte termen, time-to-event analysis, er egentlig mer korrekt, ettersom disse analysene kan brukes til å studere alle hendelser og ikke bare død. I dette kapitlet bruker vi likevel død som eksempel, fordi det gjør det lettere å forstå.
Sentralt i overlevelsesanalyse er kjennskap til observasjonstiden, det vil si tidsperioden individet observeres. Det trenger selvsagt ikke være en person som observeres; det kan like gjerne være celler, bakterier eller lignende. I sin reneste form starter observasjonstiden når individet inkluderes i studien, og observasjonstiden slutter når hendelsen inntreffer eller når studiens oppfølgingsperiode er over. Tidsperioden individet observeres, kalles survival time.
Formålet med overlevelsesanalyse er følgende:
- Studere overlevelsesprosessen.
- Studere hvordan ulike prediktorer påvirker overlevelsen.
For å studere overlevelsesprosessen kan man bruke deskriptive metoder, der den viktigste er Kaplan-Meier-estimatoren (Kaplan-Meier-kurven). Med Kaplan-Meier-metoden får man en grafisk (og matematisk) beskrivelse av overlevelsen. Med metoden kan man også sammenligne overlevelsen mellom to eller flere grupper. Med Kaplan-Meier-estimatoren kan man derimot ikke gjøre inngående analyser av hvordan ulike prediktorer påvirker overlevelsen.
For å studere hvordan ulike prediktorer påvirker overlevelsen, kreves regresjonsanalyse. I dag domineres overlevelsesanalyse av Cox-regresjon (Cox Proportional Hazards Model), som gjør det mulig å sammenligne overlevelsen mellom to eller flere grupper og å studere hvordan ulike prediktorer påvirker overlevelsen. Cox-regresjon er et svært kraftig verktøy, og hver dag publiseres tusenvis av artikler der Cox-regresjonen utgjør studiens hjørnestein.
Kaplan-Meier-estimatoren og Cox-regresjon er de viktigste verktøyene å beherske, og den videre diskusjonen konsentrerer seg derfor om disse to.
Overlevelsesanalyse vs. logistisk regresjon
Med overlevelsesanalyse studeres altså dikotome (binære) hendelser (events). Man studerer om en hendelse inntreffer eller uteblir. I så henseende har overlevelsesanalyse likheter med logistisk regresjon (se Logistisk regresjon). Faktisk brukes logistisk regresjon også til å studere dikotome hendelser. Hver dag publiseres hundrevis av artikler der logistisk regresjon er brukt for å studere sammenhenger mellom ulike prediktorer og død og andre events. Logistisk regresjon er likevel (i prinsippet) alltid et dårligere valg enn overlevelsesanalyse for å studere survival, og det skyldes at logistisk regresjon ikke kan ta hensyn til observasjonstiden. Selve observasjonstiden er nøkkelen til overlevelsesanalysen (det er faktisk fordelingen av survival time som studeres i overlevelsesanalyse), og den kan ikke inkorporeres i en logistisk regresjon. La oss illustrere dette med et (ekstremt) eksempel:
Du studerer effekten av et legemiddel som ble gitt til 50 av 100 pasienter med lungekreft i 2013. Disse pasientene ble fulgt opp i 2014, og da var samtlige pasienter døde. Like mange døde altså blant dem som fikk og dem som ikke fikk legemidlet. Du gjennomfører en logistisk regresjon der overlevelse vurderes (som et dikotomt utfall) i 2014. Ettersom alle pasientene er døde, vil den logistiske regresjonen indikere at legemidlet er uten effekt, fordi antallet døde i 2014 var like stort i begge grupper. La oss si at medianoverlevelsen i gruppen som ikke fikk legemidlet var 1 måned, og at gruppen som fikk legemidlet hadde en medianoverlevelse på 6 måneder. Alle var riktignok døde etter 12 måneder, men det ser likevel ut til at legemidlet forlenget livet. Med korrekt overlevelsesanalyse ville vi kunne bekrefte at legemidlet er effektivt, og det skyldes at overlevelsesanalysen kan inkorporere selve overlevelsestiden (survival time)!
Med overlevelsesanalyse (og særlig Cox-regresjon) har man altså større sjanse til å finne forskjeller i overlevelse. Man bør alltid foretrekke overlevelsesanalyse (særlig Cox-regresjon) fremfor logistisk regresjon dersom man har opplysninger om survival time. (Det kan likevel nevnes at logistisk regresjon under spesielle omstendigheter kan være ekvivalent med Cox-regresjon, men det diskuteres ikke i dette kapitlet.)
Event (outcome, utfallsmål, hendelsen) i overlevelsesanalyse
Utfallet i en overlevelsesanalyse er en hendelse (engelsk: event). Hendelsen kan være død, hjerneslag, kreftdiagnose eller mykere events som oppstart av legemiddelbehandling eller utskrivning fra sykehus. Man kan altså studere alle typer hendelser med overlevelsesanalyse. Det gjelder også levetiden til en datamaskin. Selve hendelsens natur er altså av underordnet betydning, men det er forskerens ansvar å definere en tydelig og meningsfull hendelse. Alle personer som inngår i populasjonen, skal følges fra tidspunktet de inkluderes i studien til oppfølgingen er over. Det er viktig å kunne datere tidspunktet for hendelsen (med så høy presisjon som mulig), slik at observasjonstiden kan beregnes med høy oppløsning. Det er altså mye bedre å registrere survival time i antall dager enn i antall måneder. Jo grovere mål på survival time, desto dårligere presisjon i analysen.
Prediktorer, kovariater og uavhengige variabler
Når overlevelsesanalyse brukes for å studere hvordan ulike variabler påvirker utfallet, gjøres det vanligvis med Cox-regresjon (Cox proportional hazards model). Variablene som studeres, kalles prediktorer, kovariater eller uavhengige variabler. Alle disse tre betegnelsene kan brukes, og de viser altså til det samme.
Censoring (sensurering)
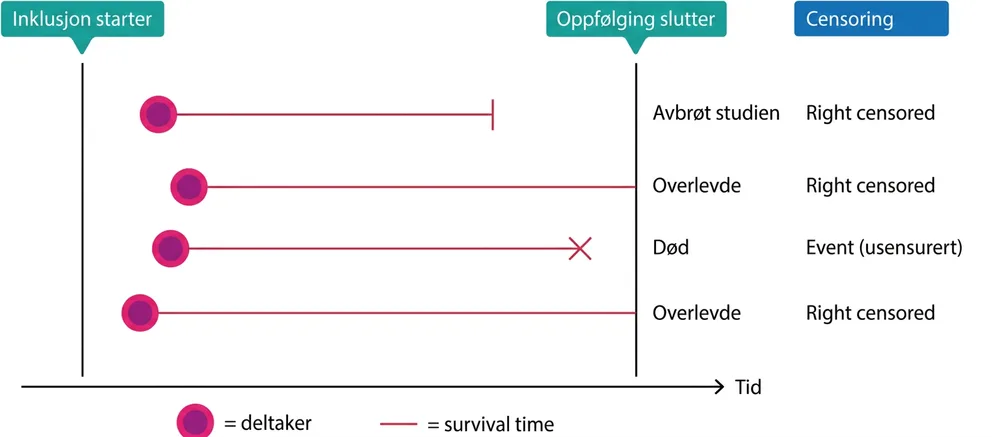
Overlevelsestid (survival time) er en kontinuerlig variabel, og det kan derfor være fristende å bruke lineær regresjon for å studere overlevelse. Det er imidlertid ikke mulig å bruke lineær regresjon, og det skyldes sensurering (eng: censoring). Som regel vil ikke alle personer oppleve hendelsen som studeres; det er for eksempel sjelden at alle personene i studien dør. Personene som overlever hele observasjonstiden, utgjør altså et problem, fordi vi ikke kan si om eller når de kommer til å dø. Disse personene blir sensurert (eng: censored) når studiens oppfølging slutter. Det samme problemet oppstår hvis studiedeltakere trekker seg fra studien (f.eks. på grunn av bivirkninger av legemidler, eller fordi de flytter utenlands osv.). Også disse personene blir sensurert (fordi vi ikke kan si om eller når de kommer til å dø). Censoring innebærer altså at oppfølgingen slutter før hendelsen har inntruffet. Man skiller mellom tre typer censoring:
- Hvis en person fullfører studien uten at hendelsen inntreffer, blir personen right censored. Det innebærer at vi bare kan uttale oss om pasientens skjebne frem til øyeblikket oppfølgingen slutter. Personer som trekker seg fra studien (uansett årsak), blir også right censored.
- Vi er ofte interessert i en bestemt eksponering; en studie kan for eksempel undersøke hvordan diabetes påvirker overlevelsen. Ofte er det imidlertid ukjent når diabetessykdommen oppsto. Sykdommen kan ha vært til stede i mange år før diagnosen ble stilt. Hvis det er ukjent når en eksponering startet, er individet left censored i så henseende. Left censoring innebærer altså at det er uklart når individets risiko startet. Dette pleier imidlertid ikke å være noe stort problem.
- Hvis et individ er både left og right censored, er det interval censored.
Informativ vs. ikke-informativ censoring
Censoring må være uavhengig av (1) individets kovariater (prediktorer) og (2) hvor lenge individet har klart seg i studien. Censoring underveis i studien (før oppfølgingen er avsluttet) skal være tilfeldig, ellers foreligger det bias i studien. Her følger et eksempel. Tenk deg at vi studerer effekten av blodtrykksmedisin på død. Legemidlet som studeres, viser seg å gi alvorlige bivirkninger, i den grad at mange personer som får legemidlet, må trekke seg fra studien. I så fall drives censoring av en kovariat (prediktor), nemlig legemidlet, og da oppstår det bias fordi pasientene trekker seg fra studien før de rekker å dø. Dette fører til underestimering av antall dødsfall og dermed overestimering av overlevelsen. Denne typen censoring kalles informativ censoring, som innebærer at censoring ikke var tilfeldig.
Censoring skal altså være ikke-informativ, som innebærer at det ikke skal finnes noen årsak til censoring. I eksemplet med blodtrykksmedisin vil fordelingen av survival time være lik mellom gruppene dersom censoring er ikke-informativ.
Survival function og hazard function
Overlevelse (survival time) er en kontinuerlig variabel som kan beskrives med to enkle funksjoner:
S(t): survival function (overlevelsesfunksjon). S(t) er sannsynligheten for at en person er i live etter tidspunkt t.
h(t): hazard function (hasardfunksjon). h(t) angir den øyeblikkelige risikoen for at hendelsen inntreffer ved tidspunkt t, forutsatt at personen har overlevd frem til da.
Formelen og sammenhengen mellom S(t) og h(t) er som følger:
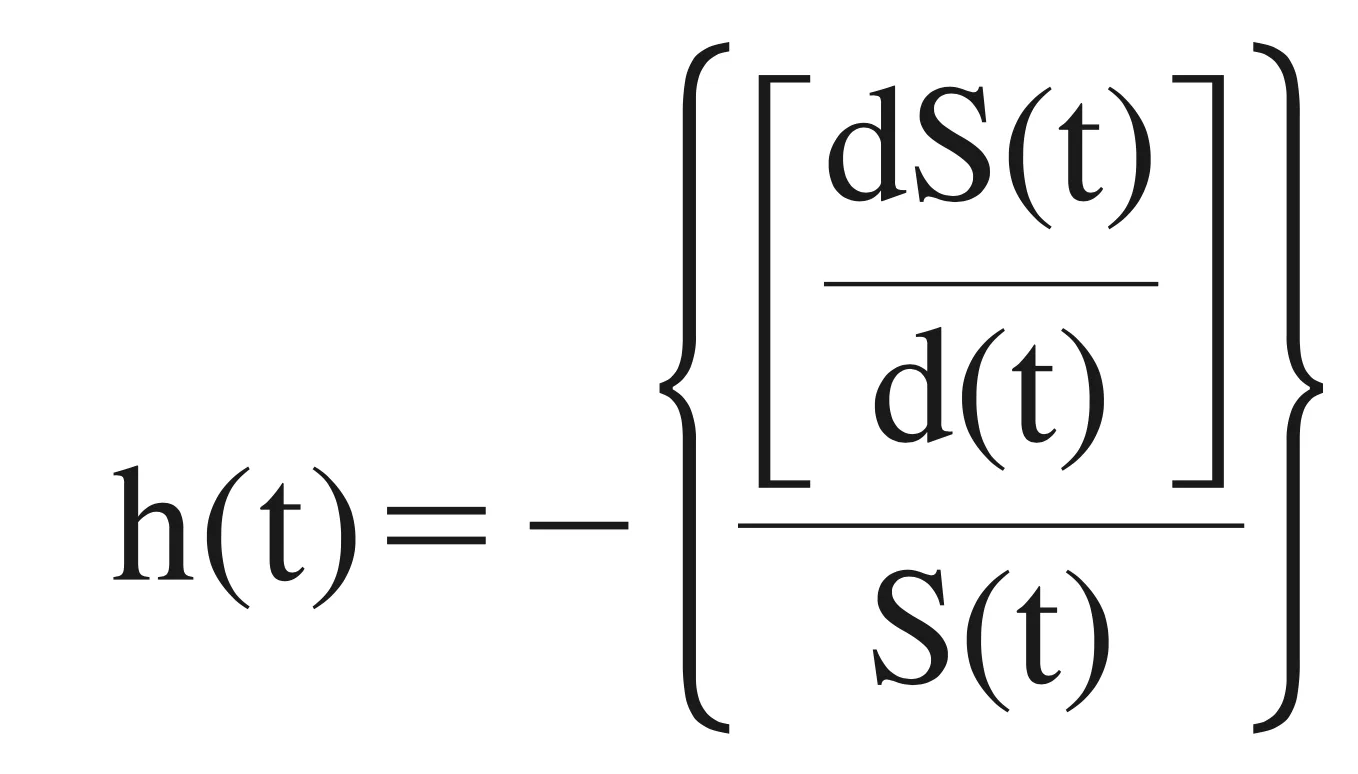
S(t) brukes til å lage deskriptiv statistikk. Ved å beregne S(t) kan man blant annet bestemme overlevelsesgrafer og medianoverlevelse. Medianoverlevelsen er tidspunktet da 50 % av den opprinnelige kohorten er i live, det vil si når S(t) = 0,5. Merk at både overlevelsesgrafer og medianoverlevelse rapporteres i de fleste undersøkelser med overlevelsesanalyse. Hasardfunksjonen, derimot, pleier ikke å presenteres i en vitenskapelig studie. Den har likevel fundamental betydning for overlevelsesanalyse, noe som diskuteres senere.
S(t) og Kaplan-Meier-estimatoren (kurven)
Det er som regel alltid av interesse å visualisere overlevelsen med en graf, fordi den viser hvordan overlevelsesprosessen ser ut over tid. Om deltakerne hovedsakelig dør i begynnelsen, i midten eller mot slutten av en studie, er lett å se med en graf. Den vanligste metoden for å presentere S(t) er ved hjelp av Kaplan-Meier-estimatoren.
For å lage en Kaplan-Meier-kurve må tidsskalaen (oppfølgingstiden) deles opp i intervaller (Figur 2). Hvert intervall begynner når et event inntreffer. Alle tidspunktene da hendelser inntreffer (event times), rangeres, fra første til siste event. Ved t1 inntreffer den første hendelsen, ved t2 inntreffer den andre hendelsen, ved t3 inntreffer den tredje hendelsen og så videre. Studien begynner ved t0, og da har ennå ingen hendelse inntruffet. Ved t0 er S(t) = 1,0, som innebærer at sannsynligheten for overlevelse er 100 %. For å beregne S(t) ved t1 gjøres følgende beregning:
(n1 – m1) / n1
n1 er antall pasienter observert i begynnelsen av t1.
m1 er antall events ved t1.
Dette er altså andelen pasienter som overlever etter t1, blant pasientene som overlevde frem til t1.
For å beregne sannsynligheten for å overleve etter t2, forutsatt at man klarer seg frem til da, gjøres beregningen i to trinn:
(n2 – m2) / n2
n2 er antall pasienter observert i begynnelsen av t2.
m2 er antall events ved t2.
Dette er altså andelen pasienter som overlever etter t2, blant dem som overlevde frem til t2. S(t) er produktet av sannsynlighetene for å overleve frem til t2, som blir:
(n1 –m1)/n1 × (n2 – m2)/n2
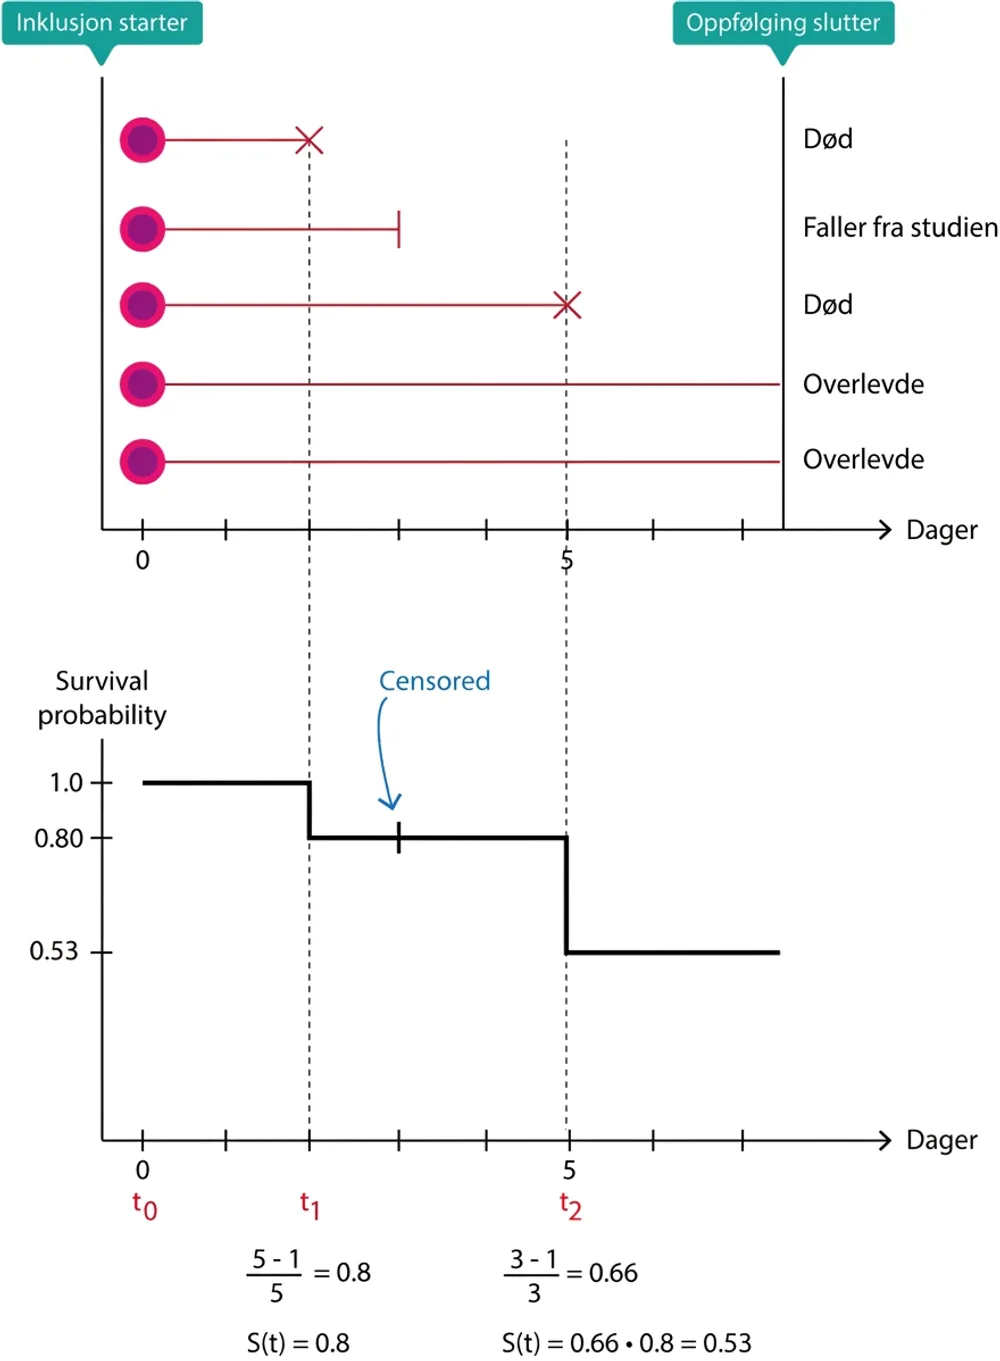
Overlevelseskurven (Kaplan-Meier-kurven) viser survival probability på Y-aksen og tid på X-aksen. Survival probability er S(t), altså andelen som fortsatt er i live ved hvert tidspunkt. Kurven begynner alltid på Y = 1, fordi alle overlever frem til t1 (da det første eventet inntreffer). Deretter går kurven gradvis nedover etter hvert som folk dør. Eventuelle «+» på kurven angir tidspunkter da personer sensureres (dvs. oppfølgingen slutter før et event inntreffer). Som du ser av figuren ovenfor, påvirkes ikke S(t) av sensurering. Kaplan-Meier-kurven når bare S(t) = 0 hvis alle i studien dør. Medianoverlevelsen er rett og slett andelen som lever ved S(t) = 0,5.
Teste forskjell mellom overlevelseskurver: log-rank-test
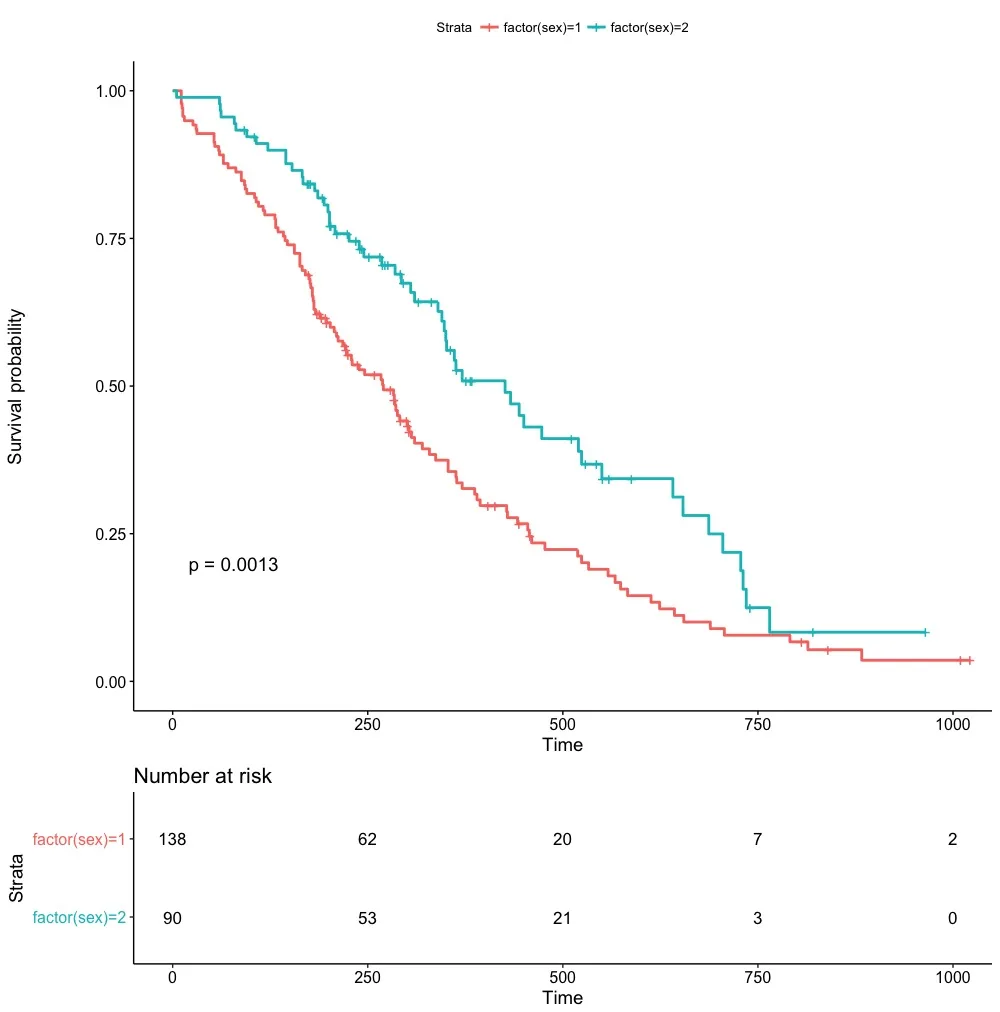
I figuren nedenfor sammenlignes overlevelsen mellom menn og kvinner.
R-kode for Kaplan-Meier-kurven ovenfor
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)
## Last inn eksempeldata og se på datastrukturen
data(lung)
str(lung)
## sikrer at sex er en kategorisk variabel ved å tvinge den til det med funksjonen "as.factor"
lung$sex <- as.factor(lung$sex)
## Lag survfit-objekt. I dette objektet lages overlevelsesfunksjonen
fit <- survfit(Surv(time, status==2) ~ sex, data = lung)
## Tegn Kaplan-Meier-kurve
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)
Som det fremgår ovenfor, er kurvene atskilt, noe som innebærer at overlevelsen er forskjellig mellom menn og kvinner. Ved hvert tidspunkt er S(t) høyere for kvinner (linjen for kvinner ligger over linjen for menn). Det innebærer at overlevelsen er bedre for kvinner, og det kan altså vurderes visuelt. Det er likevel ønskelig å teste om overlevelsen er forskjellig ved hjelp av en statistisk test. Til dette formålet bruker man log-rank-test.
Prinsippet for log-rank-testen følger prinsippet for hypotesetesting. Man tar utgangspunkt i nullhypotesen, som sier at det ikke er noen forskjell mellom gruppene, og deretter beregnes en sannsynlighet (p-verdi) for at nullhypotesen stemmer. Hvis sannsynligheten er <0,05, forkastes nullhypotesen. Gruppene kan baseres på en hvilken som helst kategorisk variabel, med to eller flere kategorier. I eksemplet ovenfor finnes bare to grupper, nemlig menn og kvinner. Log-rank-testen kan altså brukes til å sammenligne to eller flere overlevelseskurver.
Kaplan-Meier-kurven kan dermed brukes til å studere overlevelse. Dette kan gjøres i hele populasjonen eller i undergrupper (f.eks. menn og kvinner). Man kan derimot ikke justere for kovariater i en Kaplan-Meier-beregning; det krever regresjonsanalyse.
Cox-regresjon (Proportional Hazards Model)
I dag er Cox-regresjon nesten synonymt med overlevelsesanalyse. Dette skyldes metodens mange fordeler sammenlignet med andre regresjonsmodeller. Alternativene til Cox-regresjon, for eksempel Weibull-regresjon, gir under visse omstendigheter mer korrekte parameterestimater, men på bekostning av kompleksiteten. Cox-regresjonen er en enkel og kraftig modell for å studere overlevelse. Forskjellen mellom Cox-regresjon og Kaplan-Meier-analyse er at førstnevnte nettopp er en regresjonsmodell, noe som innebærer at vi kan studere hvordan ulike prediktorer påvirker overlevelsen. Cox-regresjoner kan, i likhet med vanlig multippel regresjon, inkludere én eller flere prediktorer. Cox-regresjon er faktisk en variant av den lineære modellen, noe som forklares nedenfor.
I en Cox-regresjon studeres sammenhengen mellom prediktorer (kovariater) og survival time. For å komme frem til ligningen for Cox-regresjon tar vi utgangspunkt i hazard function, h(t), og survival function, S(t).
- Hazard function, h(t), for en hendelse ved tidspunkt t (altså et vilkårlig tidspunkt) er ekvivalent med event rate (hastigheten som hendelser inntreffer med) for pasientene som ennå ikke har opplevd hendelsen.
- Survival function, S(t), er sannsynligheten for ennå (ved tidspunkt t) ikke å ha opplevd hendelsen.
Det finnes en matematisk sammenheng mellom h(t) og S(t), og den er som følger:
Cox-regresjonen tar utgangspunkt i hazard function og definerer følgende modell:
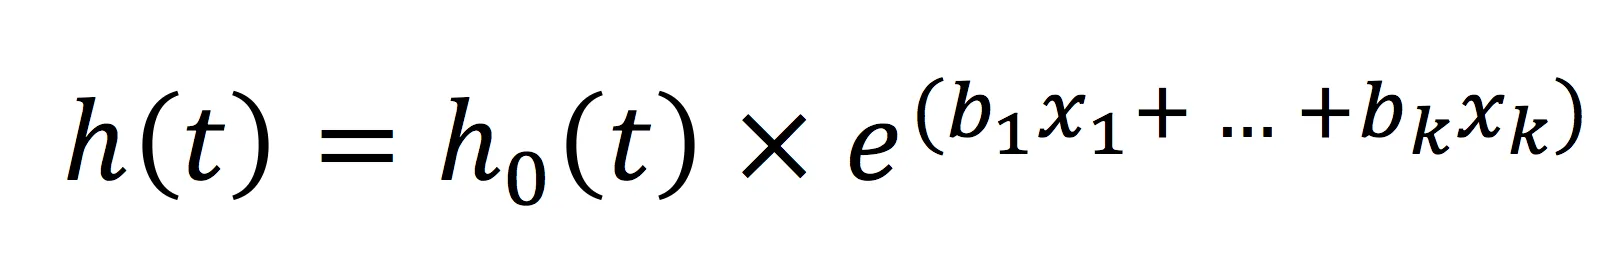
h0(t) er baseline hazard, og denne størrelsen kan være litt vanskelig. Baseline hazard er risikoen individet har når verdien av alle prediktorer er 0. Her følger to eksempler. (1) Tenk deg at vi studerer hvordan alder påvirker dødelighet. I en Cox-regresjon der alder er den eneste prediktoren, ville baseline hazard være risikoen et menneske har ved alder = 0 år. Etter fødselen kommer det til risiko etter hvert som alderen øker. (2) Tenk deg at vi i stedet studerer hvordan blodtrykk påvirker dødelighet. I en slik modell ville baseline hazard være individets risiko ved blodtrykk = 0, noe som ikke er biologisk meningsfullt (ingen levende person har blodtrykk = 0). Dette innebærer at baseline hazard er individets risiko når alle prediktorer settes til 0, noe som er det samme som at modellen mangler prediktorer. Baseline hazard kan altså betraktes som risikoen i «utgangsposisjonen».
x1, x2 ... xk er prediktorene (kovariatene) som brukes til å modellere et individs hazard function. Samlingen av prediktorer ligner dermed en vanlig multippel (lineær) regresjon. Prediktorene kan være kontinuerlige eller kategoriske variabler. Som det fremgår av formelen ovenfor, er hele samlingen av prediktorer eksponensiert (e).
Cox-modellen innebærer altså at hasarden ved tidspunkt t er produktet av h0(t) og eksponenten (e) av prediktorenes samlede effekt. I neste trinn dividerer vi begge sider av likhetstegnet med baseline hazard, og i tillegg logaritmeres begge sider. På høyre side av likhetstegnet forsvinner h0(t), og eksponensieringen forsvinner. På venstre side av likhetstegnet står den naturlige logaritmen av h(t)/h0(t) igjen.
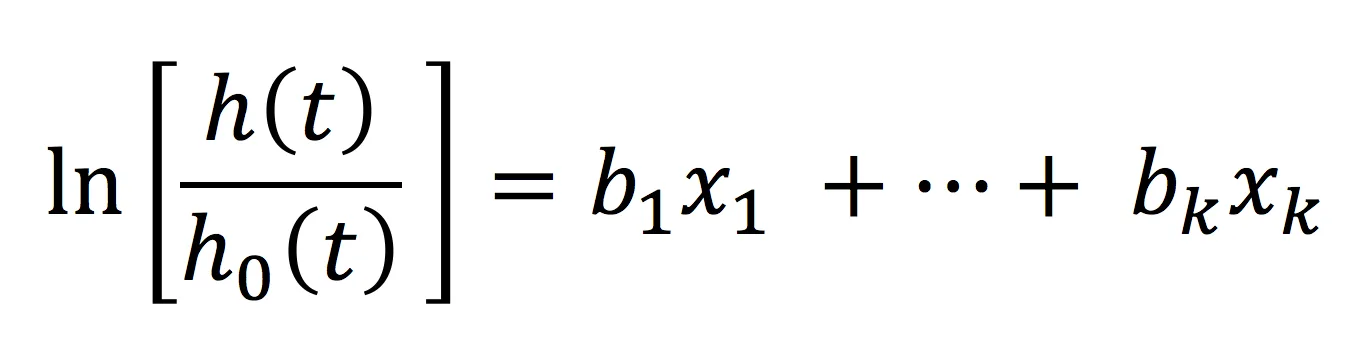
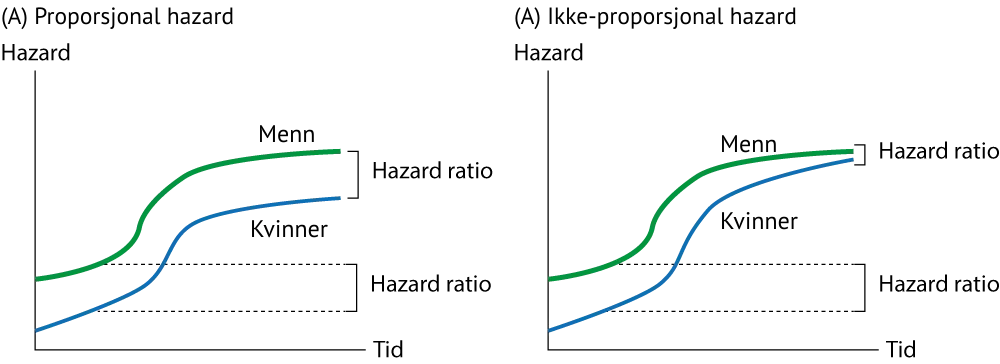
Den venstre siden av ligningen er individets hazard (risiko), og den høyre siden er en vanlig lineær regresjon. Denne fremgangsmåten er ganske genial, fordi vi nå har kommet frem til en ligning som lar oss studere overlevelsen som en lineær funksjon av individets prediktorer. Det var Sir David Cox som la frem de matematiske bevisene for dette, og han fremhevet at ligningen bare stemmer dersom hasarden er proporsjonal. Cox Proportional Hazards Model er synonymt med Cox-regresjon. Proportional hazard innebærer at ratioen (kvotienten) mellom to individers hazard function skal være konstant over tid. Dette gjelder for alle karakteristika som definerer individene i studien. Her følger et eksempel. Hvis vi studerer dødeligheten i Göteborg og inkluderer diabetes som prediktor i modellen, må kvotienten mellom diabetikeres og ikke-diabetikeres hazard function være konstant gjennom hele oppfølgingen. Hvis diabetikere har 3 ganger økt risiko for død i begynnelsen av oppfølgingen, skal diabetikere ha like høy risiko (3 ganger) gjennom hele studiens oppfølging. Forklaringen på dette følger av neste ligning, der hazard function for to individer sammenlignes:
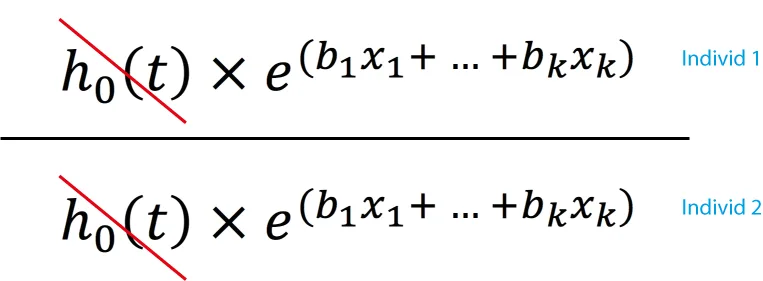
Denne kvotienten mellom to hazard functions er hazard ratio (HR). Det er altså den relative forskjellen i risiko for individ 1 sammenlignet med individ 2. Ettersom h0(t) inngår i både telleren og nevneren, faller den helt bort. I ligningen finnes heller ikke tid. Det er dermed bare verdiene av prediktorene som skiller individ 1 og individ 2; verken baseline hazard eller tid kan påvirke hazard ratio, som derfor er konstant mellom individ 1 og individ 2. Det innebærer også at dersom noen av prediktorene (x1, x2 ... xk) skulle ha en effekt som varierer over tid, vil kravet om proportional hazards ikke være oppfylt, og modellen blir ugyldig. I Figur 4 illustreres proportional hazards og non-proportional hazards.
Hazard ratio (hasardratio)
Hazard ratio beregnes ved å dividere hazard for ett individ med hazard for et annet individ (se formelen ovenfor). Hazard ratio beregnes når en hendelse inntreffer. Hvis en hendelse inntreffer ved tidspunkt t, beregnes hazard ratio ved å dividere hazard for individet som opplevde hendelsen, med hazard for de øvrige som klarte seg frem til tidspunkt t uten å oppleve hendelsen. Baseline hazard faller (som forklart ovenfor) bort fra kvotienten; likeledes er tidspunktet irrelevant, fordi alle individer sammenlignes ved samme tidspunkt. Det som karakteriserer individene, blir dermed prediktorene deres (x1, x2 ... xk). Dermed kan effekten av prediktorene analyseres! I en Cox-regresjon beregner vi altså koeffisientene for prediktorene (x1, x2 ... xk), som er disse prediktorenes innvirkning på overlevelsen. Den hazard ratio man får når to individers hazard divideres, er logaritmert, noe som også gjør den vanskelig å tolke. For å løse dette eksponensieres koeffisienten. Hvis regresjonskoeffisienten er 0,5, blir den eksponensierte koeffisienten e0,5 = 1,65. Når vi bruker termen hazard ratio, viser vi egentlig til den eksponensierte koeffisienten!
Tolkning av hazard ratio
- For en kontinuerlig prediktor er hazard ratio den økningen/reduksjonen i hazard som følger når prediktoren X øker med én enhet.
- For en kategorisk variabel er hazard ratio forskjellen i hazard mellom to (eller flere) grupper, der en av gruppene er referansegruppe.
For å forstå dette bedre trenger vi et eksempel, og vi lager selv dette eksemplet i R.
R-kode
library(survival)
## Vi lager en Cox-regresjon som studerer hvordan age, sex og meal.cal påvirker dødeligheten
modell2 <- coxph(Surv(time, status==2) ~ age + factor(sex) + meal.cal, data = lung)
## Vi installerer og aktiverer en pakke som lager pene tabeller med resultatene
install.packages("forestmodel")
library(forestmodel)
forest_model(modell2)
Resultater fra modellen
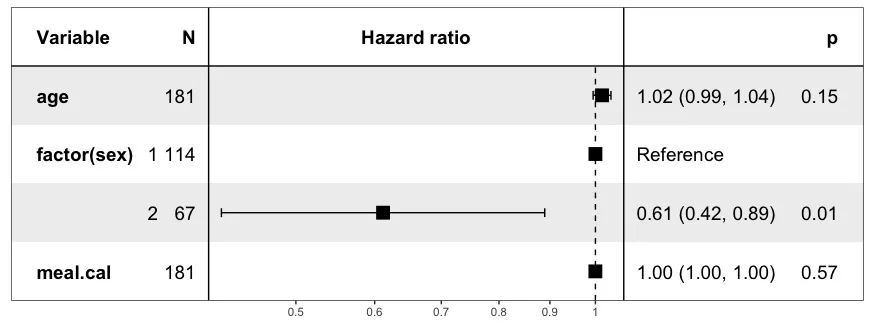
Denne modellen har altså tre prediktorer: age, sex og meal.cal. Sex er en kategorisk prediktor med nivåene 1 (menn) og 2 (kvinner). Age og meal.cal er kontinuerlige prediktorer. Hazard ratio presenteres både med en graf (i midten) og med tall (nest siste kolonne). Merk at hazard ratio presenteres sammen med sitt 95 % konfidensintervall. For eksempel er hazard ratio for sex 1,02 med et 95 % konfidensintervall som strekker seg fra 0,99 til 1,04. Den siste kolonnen er p-verdien, som angir om prediktoren har en statistisk signifikant sammenheng med dødeligheten. Dette er en typisk presentasjon av en Cox-regresjon. Kolonnen «N» angir hvor mange individer som inngår i hver kategori (denne kolonnen kan ignoreres). Deretter følger tolkningen av resultatene.
- Hazard ratio for sex: I tabellen er sex presentert på to rader. Det skyldes at sex er en kategorisk variabel med to nivåer. Vi får ingen koeffisienter (hazard ratio) for menn, fordi menn er referansekategorien. For alle kategoriske variabler finnes det alltid en referansekategori som de øvrige kategoriene skal sammenlignes med. Vi får dermed hazard ratio for kvinner, og resultatet er 0,61 med et konfidensintervall som strekker seg fra 0,42 til 0,89. Dette er hazard ratio for kvinner sammenlignet med menn. Hazard ratio er mindre enn 1, noe som innebærer at kvinner har lavere risiko enn menn. Hvis vi trekker 1 fra 0,61 og multipliserer differansen med 100, får vi risikoforskjellen i prosent; (0.61–1.0)×100 = –39%. Kvinner har, sammenlignet med menn, 39 % lavere risiko for død. Dette er altså «punktestimatet», og det er en viss usikkerhet knyttet til det. Derfor får vi også et 95 % konfidensintervall, som indikerer at kvinner (med 95 % sikkerhet) har mellom 58 % og 11 % lavere risiko enn menn.
- Hvis vi hadde en prediktor med flere enn 2 nivåer, ville tolkningen være den samme; én kategori er referanse, og de øvrige kategoriene sammenlignes med den.
- Konfidensintervallet for kvinner omslutter ikke verdien 1,0. Hvis hazard ratio er 1,0, er jo kvotientens teller og nevner like store, noe som innebærer at det ikke er noen forskjell mellom gruppene. Det innebærer at et konfidensintervall som omslutter 1,0, indikerer at man ikke med 95 % sikkerhet kan si at det finnes en forskjell mellom gruppene. For kvinnenes del inngår ikke 1,0 i konfidensintervallet, så vi kan med 95 % sikkerhet si at det finnes en forskjell mellom menn og kvinner. Dette styrkes av p-verdien (0,01), som angir at kjønn er en statistisk signifikant prediktor.
- Denne modellen inkluderer altså også age og meal.cal, i tillegg til sex. Da er effekten av sex justert for effekten av de øvrige prediktorene i modellen (de øvrige prediktorene «holdes konstante»).
- Age (alder) er en kontinuerlig prediktor. Derfor tolkes hazard ratio som økningen i hazard for hver enhet alderen øker. I denne studien var alder målt i år, så hazard ratio er økningen i hazard for hvert år deltakerne blir eldre. Resultatet ble 1,02 med et konfidensintervall fra 0,99 til 1,04. Ettersom hazard ratio (punktestimatet) er 1,02, betyr det at for hvert år deltakerne blir eldre, øker risikoen for død med 2 %. Man kan lett beregne hvor mye risikoen øker over 15 år med beregningen 1,0215, som gir en hazard ratio på 1,35 (dvs. 35 % økt risiko). I dette tilfellet omslutter imidlertid konfidensintervallet 1,0, ettersom intervallet strekker seg fra 0,99 til 1,04, og dermed kan vi ikke med sikkerhet si at alder har en effekt. Denne påstanden styrkes av p-verdien, som er 0,15 og dermed ikke signifikant.
I Cox-regresjon er altså sammenhengen mellom prediktoren og hasarden lineær. Modellen er likevel ikke helt parametrisk, fordi det finnes en baseline hazard. Cox-regresjon er dermed en semiparametrisk modell.
Konfidensintervall og p-verdier for hazard ratio
I R og all annen statistisk programvare får man automatisk standardfeil (SE), p-verdier og konfidensintervaller når man lager modellen. Konfidensintervallet er et såkalt Wald-intervall, fordi man bruker estimater direkte fra modellen for å beregne intervallet.
Nedre grense: HR – 1.96×SE
Øvre grense: HR + 1.96×SE
Der HR er hazard ratio og SE er standard error.
Detaljer om proportional hazards
Proportional hazard kan også forklares ved hjelp av interaksjoner mellom en prediktor og tid. Hvis en prediktor oppfyller kriteriet for proportional hazard, skal det ikke finnes noen statistisk signifikant interaksjon mellom den prediktoren og oppfølgingstiden (survival time). Man kan dermed lage et interaksjonsledd (prediktor×oppfølgingstid) og vurdere om det er statistisk signifikant. Hvis interaksjonen ikke er signifikant, innebærer det at prediktoren har samme effekt på hazard function ved alle verdier av t (oppfølgingstid), og da er kriteriet for proportional hazard oppfylt. Hvis interaksjonen derimot er signifikant, innebærer det at effekten av prediktoren varierer over tid, og da bryter den variabelen med antakelsen om proportional hazard. Det finnes flere måter å vurdere proportional hazards på, og de er som følger:
- Vurdering av Schoenfeld-residualer
- Visualisere log(-log S(t)) mot t
Egentlig bør man foretrekke de to sistnevnte metodene fremfor interaksjonsledd. I R finnes det enkle funksjoner som presenterer både Schoenfeld-residualer og grafer over log(-log S(t)) mot t.
Stratifisering (den stratifiserte Cox-modellen)
Cox-regresjonen gir mulighet til å justere for variabler som ikke inngår i modellen, og dette gjøres ved å stratifisere. Man må ikke forveksle stratifisering i Cox-regresjon med stratifisering i vanlig lineær (multippel) regresjon.
I vanlig lineær (multippel) regresjon innebærer stratifisering at man lager separate modeller ut fra en kategorisk variabel. Her følger et eksempel. Tenk deg at vi studerer hvordan alder påvirker blodtrykket, og at vi også har informasjon om vekt. Hvis vi vil vite hvordan alder påvirker blodtrykket i ulike vektkategorier, kan vi stratifisere analysen ved å gjøre én regresjon for normalvektige, én regresjon for overvektige og én regresjon for personer med fedme. Dette er altså tre separate modeller som gir separate koeffisienter for alder.
I Cox-regresjon kan stratifiseringen håndteres annerledes. Cox-modellen lar oss stratifisere data (pasientene) ut fra en kategorisk variabel. Baseline hazard tillates å variere mellom disse strataene. Modellen kan deretter estimere en samlet (kumulativ) effekt av alder i alle strata. Da får vi bare én koeffisient for alder, i stedet for separate koeffisienter i hvert stratum. Man kan si at effekten av alder «pooles» (vektes sammen) på tvers av alle strata.
Det finnes flere situasjoner der det er klokt å stratifisere modellen. Her følger et eksempel. Hvis en variabel bryter med antakelsen om proportional hazard, kan man kategorisere variabelen i to eller flere passende nivåer og stratifisere modellen på den variabelen. Da har man justert for variabelen, og man trenger ikke bekymre seg for at den bryter med proportional hazards. Ulempen er at man ikke får noen regresjonskoeffisienter for variabelen (men hvis den uansett ikke er av interesse for analysen, er dette ingen stor ulempe.