
Mål på prediktiv evne
eng. performance metrics, evaluation metrics
I flere av de foregående kapitlene har betegnelsen presisjon blitt brukt jevnlig for å vise til modellers prediksjonsevne. Dette er egentlig ukorrekt, fordi presisjon er et spesifikt mål på prediksjonsevne. Det finnes en lang rekke mål som beskriver ulike nyanser av prediksjonsevne. Disse målene brukes til å evaluere og sammenligne modeller (for eksempel under kryssvalidering). Hvilket mål som er optimalt, varierer med problemstilling og situasjon.
Fra dette perspektivet finnes det tre typer modeller:
- Klassifikasjonsmodeller (klassifikasjon).
- Regresjonsmodeller (regresjon).
- Overlevelsesmodeller (overlevelsesanalyse).
I denne sammenhengen viser regresjon ikke til den klassiske lineære regresjonsmodellen, men til alle modeller som predikerer kontinuerlige utfall (enten det gjøres med klassiske regresjonsmodeller, maskinlæring, dyp læring eller en annen metode). Med regresjon menes her en modell med kontinuerlig utfallsmål.
Klassifikasjon viser til alle modeller, uavhengig av type, som predikerer et kategorisk utfallsmål. I de fleste tilfeller er utfallet binært (ja/nei, syk/frisk, død/levende, etc), men det kan være multinomialt (>2 kategorier).
Den tredje typen modell er overlevelsesanalyse, der utfallet er tid til en hendelse inntreffer. Overlevelsesanalyse har en særstilling fordi utfallet er kontinuerlig (tid), men som regel opplever/rammes ikke alle deltakerne av hendelsen som studeres. De som ikke rammes av/opplever hendelsen i løpet av studiens observasjonstid, blir sensurert. Dette gjør at modellen ikke er en vanlig klassifikasjonsmodell, og derfor kreves det særskilte mål på prediksjonsevne.
Klassifikasjon
Forvirringsmatrise (Confusion matrix)
Forvirringsmatrisen er grunnleggende ved vurdering av klassifikasjonsmodeller. I denne enkle krysstabellen finnes flere viktige mål. Krysstabellen nedenfor viser en forvirringsmatrise. Matrisen leses slik:
- True positive (TP): Både modellen og virkeligheten viser positivt utfall.
- True negative (TN): Både modellen og virkeligheten viser negativt utfall.
- False positive (FP): Modellen predikerer positivt utfall, men i virkeligheten var det negativt utfall.
- etc.
| Predikert positiv (PP) | Predikert negativ (PN) | |
|---|---|---|
| Faktisk positiv (P) | True positive (TP) | False negative (FN) |
| Faktisk negativ (N) | False positive (FP) | True negative (TN) |
Confusion matrix (forvirringsmatrise).
Fra en forvirringsmatrise kan følgende parametere beregnes:
- Accuracy: Andelen av positive som klassifiseres som positive.
- Sensitivitet:
- Formel:
- Betydning: Andel av positive som klassifiseres som positive.
- Synonym: Recall, True Positive Rate, Hit Rate.
- Spesifisitet:
- Formel:
- Betydning: Andel av negative som klassifiseres som negative.
- Synonym: True Negative Rate
- Positive Predictive Value (PPV):
- Formel:
- Betydning: Sannsynlighet for positivt utfall dersom predikert som positivt.
- Synonym: Precision
- Negative Predictive Value (NPV):
- Formel:
- Betydning: Sannsynlighet for negativt utfall dersom predikert som negativt.
- F-score:
- Formel:
ROC og AUC-ROC
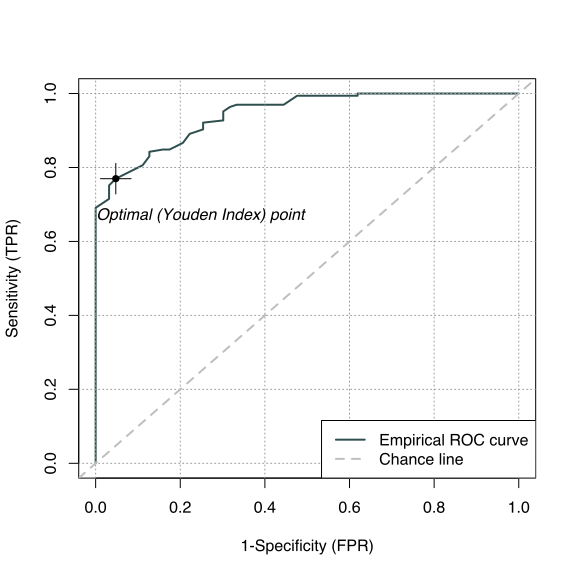
En ROC-kurve er en grafisk fremstilling av prediksjonsevnen til en klassifikasjonsmodell med binært utfall. Den illustrerer hvordan prediksjonsevnen endres når beslutningsterskelen justeres. Beslutningsterskelen er grenseverdien (for sannsynlighet) der et tilfelle klassifiseres som positivt. Hvis modellen predikerer at sannsynligheten for positivt utfall er høyere enn beslutningsterskelen, predikerer den positivt utfall. Hvis beslutningsterskelen settes til 50 % sannsynlighet og et tilfelle predikeres å ha 49 % sannsynlighet for positivt utfall, vil modellen predikere negativt utfall. Hvis tilfellet derimot predikeres å ha 51 % sannsynlighet for positivt utfall, vil modellen predikere positivt utfall. Hvis beslutningsterskelen senkes fra 50 % til 10 %, vil mange flere klassifiseres som positive; sensitiviteten stiger, men spesifisiteten synker. ROC-kurven lages ved å plotte sensitivitet mot FPR (false positive rate, som er det samme som 1-spesifisitet) ved alle verdier av beslutningsterskelen. Et eksempel på en ROC-kurve følger.
Arealet under ROC-kurven (AUC-ROC)
Legg merke til den stiplede diagonale linjen på ROC-kurven ovenfor. Arealet under den stiplede linjen er 0,5 (arealet er uten enhet). En ROC-kurve som faller på den diagonale linjen, mangler prediktiv evne. Modellens prediksjonsevne er da ekvivalent med tilfeldigheten. En modell der ROC-kurven ligger over linjen, er bedre enn tilfeldigheten. Arealet under ROC-kurven kan altså oppsummere hvor god modellen er. ROC-kurver nær 1 ses svært sjelden; eksempler på analyser som har AUC-ROC nær 1,0, er PCR-analyser for virus. Kliniske prediksjonsmodeller har som regel AUC-ROC mellom 0,6 og 0,9. Modeller innen finans, psykologi og andre domener har lignende ROC-resultater.
Concordance index (C-indeks)
C-indeks er en generalisering av ROC-kurven. C-indeks tar hensyn til sensurering, noe som er et krav for å kunne brukes i overlevelsesanalyse. C-indeks er modellens globale evne til å predikere overlevelsestid.
Formelen for C-indeks:
\begin{equation} \text{C-index} = \frac{ \sum_{i, j} \mathbb{1}_{T_j < T_i} \cdot \mathbb{1}_{\eta_j > \eta_i} \cdot \delta_j }{\sum_{i, j} \mathbb{1}_{T_j < T_i}\cdot \delta_j } \end{equation}
Cox-regresjon og andre modeller som bruker Cox-tapsfunksjon (Cox loss), evalueres med C-indeks.
C-indeks tolkes analogt med ROC. Det betyr at C-indeks 1,0 innebærer at modellen er perfekt. C-indeks 0,5 innebærer at modellen ikke er bedre enn tilfeldigheten.
Fordypning: Uno et al.
Brier score
Brier score brukes til å evaluere en overlevelsesmodells prediksjonsevne ved tid . Det betyr at Brier score forteller hva modellens evne er ved et gitt tidspunkt. Brier score varierer mellom 0 og 1. Brier score er den gjennomsnittlige kvadrerte avstanden mellom observert overlevelse og faktisk overlevelse; 0 innebærer at modellen er optimal, fordi det ikke finnes noen forskjell mellom prediksjonen og det observerte.
Integrert Brier score
Integrert Brier score gir et samlet mål på Brier score over alle verdier av overlevelsestid (survival time).
Regresjon
Følgende mål brukes til å evaluere modeller med kontinuerlige utfallsmål. Error, som brukes i flere av disse målene, er forskjellen mellom den faktiske verdien og den predikerte verdien av .
R2
R2 er variansen som forklares av modellen. Dette målet er svært populært for å vurdere modeller med kontinuerlige utfallsmål. R2 antar en verdi mellom 0 og 1, der 0 innebærer at modellen ikke forklarer noen varians (dvs. modellen mangler forklaringskapasitet) og 1 innebærer at modellen forklarer all varians.
\begin{equation} {R}^{2} = 1 - \frac { \sum_{i=1}^{n} (\ y_i -\hat{y_i} )^{2} } { \sum_{i=1}^{n} (\ y_i -\bar{y_i} )^{2} } \end{equation}
MAE (Mean Absolute Error)
MAE er gjennomsnittet av den absolutte målefeilen. Errors kvadreres ikke, noe som gjør målet mindre følsomt for enkeltstående uteliggere (store verdier).
\begin{equation} MAE = \frac{1}{n} \sum_{i=1}^{n} |{y_i}-\hat{y_i}| \end{equation}
MAPE (Mean Absolute Percent Error)
MAPE er MAE uttrykt i prosent, som er et mål mennesker har lett for å forstå. Ulempen med MAPE er at hvis error = 0, kan MAPE ikke beregnes, fordi en divisjon (for å beregne prosent) med 0 gir et uendelig tall. Dessuten har MAPE en tendens til å foretrekke modeller som predikerer lavere verdier av Y enn de faktiske verdiene.
\begin{equation} MAPE = \frac{1}{n} \sum_{i=1}^{n} {\left|\frac{{y_i}-\hat{y_i}}{y_i}\right|} \end{equation}
RMSE (Root Mean Squared Error)
RMSE er kvadratroten av gjennomsnittet av de kvadrerte errors. RMSE forteller hvor langt prediksjonene er fra den faktiske verdien, i samme enhet som Y. Fordi error kvadreres, har enkeltstående uteliggere (store verdier) større innvirkning på RMSE enn på MAE og MAPE.
\begin{equation} RMSE = \sqrt{\frac{1}{n} \sum_{i=1}^{n} ({y_i}-\hat{y_i}){^2}}\end{equation}