
Variabelseleksjon: Å inkludere de riktige variablene
Formålet med en prediksjonsmodell kan være enten (1) å estimere effekten (assosiasjonen) mellom én eller flere prediktorer () og utfallet , eller (2) å lage en modell med maksimal prediksjonsevne. I det første scenarioet, altså når formålet er å estimere prediktorenes effekter, blir sluttresultatet selvsagt en prediksjonsmodell, men den har sannsynligvis ikke maksimal prediksjonsevne. For å estimere effekter trenger en modell ikke å ha maksimal prediksjonsevne; fokuset bør i stedet være å generere lett tolkbare og pålitelige resultater. I dette scenarioet kan variabelseleksjonen gjøres ut fra kunnskap om fagområdet. Med fagkunnskap kan man lage en modell som inkluderer nødvendige kovariater, og spesifisere modellen på en fornuftig måte. Det betyr at variabelseleksjonen kan baseres på fagkunnskap dersom formålet med modellen er effektestimering. I det andre scenarioet, altså når formålet er maksimal prediksjonsevne, er variabelseleksjon noe mer komplisert, og dette kapittelet handler først og fremst om slike modeller.
Prediksjonsmodeller bør ha høy prediksjonsevne samtidig som de er sparsommelige med hensyn til antall variabler som trengs i modellen. Den engelske betegnelsen på den sparsommelige modellen (med hensyn til antall prediktorer) er the parsimonious model. Jo flere prediktorer en modell inneholder, desto vanskeligere er det for andre å bruke modellen, særlig hvis modellen inkluderer prediktorer som er vanskelige å skaffe. Dessuten kan overfitting oppstå hvis antallet prediktorer er for stort.
Variabelseleksjon (eng. variable selection, feature selection) innebærer at man på en metodisk måte eliminerer unødvendige variabler. Det betyr at man starter med et større antall variabler, såkalte kandidatvariabler (eng. candidate predictors), som gradvis elimineres til de viktigste står igjen. Det finnes flere metoder for å gjøre variabelseleksjon. Disse metodene diskuteres nedenfor.
Stepwise variable selection: backward & forward stepwise selection
Stepwise (trinnvis) variabelseleksjon er en automatisert prosess der programvaren bestemmer hvilke variabler som skal inngå i en regresjonsmodell. Dette kan gjøres enten med forward stepwise selection eller backward stepwise selection.
- Forward stepwise selection innebærer at modellen starter med 0 (null) variabler, og deretter legges én variabel til om gangen. Den tillagte variabelen får bli værende i modellen hvis den gir en bedre modell.
- Backward stepwise selection innebærer at alle kandidatvariablene er med i modellen fra starten. Deretter elimineres én variabel om gangen. Den variabelen hvis eliminering påvirker modellen minst, blir ekskludert (fordi eliminering av den variabelen har minst innvirkning på modellen). Dette gjentas til ingen variabler kan elimineres uten at modellen blir signifikant dårligere.
- Bidirectional stepwise elimination er en kombinasjon av begge de ovennevnte.
For å vurdere om modellen blir bedre eller dårligere må et kriterium brukes. I de fleste tilfeller brukes Akaike information criterion (AIC). AIC er et mål på balansen mellom modellens kompleksitet (antall prediktorer) og goodness-of-fit (prediksjonsevne). Jo lavere AIC, desto bedre modell.
Disse metodene skal i prinsippet aldri brukes. De strider nemlig mot flere prinsipper for statistisk inferens. Konsekvensene av å bruke stepwise selection er som følger (Harrell):
- R2-verdier er biased (for høye)
- Selve seleksjonen av variabler baseres på P-verdier (signifikanstester), noe som egentlig krever en forhåndsspesifisert hypotese.
- Standard error (SE) er biased (for små).
- Konfidensintervaller er biased (for smale).
- P-verdier blir falskt for små, og det oppstår problemer med multippel testing.
- Regresjonskoeffisientene er biased (koeffisientene, og dermed effekten, er falskt for store).
Til tross for dette skal vi demonstrere hvordan stepwise variable selection utføres i R. Begynn med å installere pakken olsrr og aktivere den. I eksemplet nedenfor lager vi en lineær modell med mpg-data. Vi predikerer hwy ved å spesifisere hwy ~., der . betyr "alle variabler" i mpg. Du kan deretter bruke funksjonen tidy() fra broom for å se resultatet. Deretter brukes ols_step_forward_aic() for å gjøre forward stepwise selection. Resultatet visualiseres så. Vi skriver også ut resultatene slik at informasjon om kan hentes ut. Tilsvarende funksjon for backward stepwise selection er ols_step_backward_aic().
library(olsrr)
library(broom)
library(tidyverse)

## Lager modellen
model <- lm(hwy ~., data = mpg)

## Se modellens resultat før forward stepwise selection
tidy(model)

## Forward stepwise selection
forward<-ols_step_forward_aic(model)

plot(forward) + theme_bw()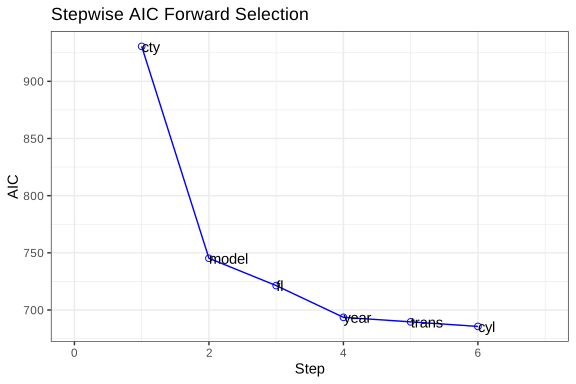
print(forward) Selection Summary
-------------------------------------------------------------------
Variable AIC Sum Sq RSS R-Sq Adj. R-Sq
-------------------------------------------------------------------
cty 930.567 7549.302 712.360 0.91378 0.91340
model 745.249 8026.474 235.189 0.97153 0.96598
fl 721.367 8056.430 205.232 0.97516 0.96970
year 693.609 8080.938 180.724 0.97812 0.97317
trans 689.636 8097.136 164.526 0.98009 0.97436
cyl 685.650 8101.292 160.370 0.98059 0.97487
-------------------------------------------------------------------Univariat screening
Mange forskere bruker univariat screening for å bestemme hvilke variabler som skal inngå i modellen. Det innebærer at én variabel testes om gangen, og hvis den er statistisk signifikant, inkluderes den i den endelige modellen. Også dette er feil, fordi variabelseleksjonen ikke skal baseres på P-verdier. Dessuten kan det føre til at variabler som bare er signifikante i nærvær av andre variabler, blir ekskludert. Dermed kan man miste viktige prediktorer med denne metoden.
LASSO (least absolute shrinkage and selection operator)
LASSO er en regresjonsmodell som kan brukes til å selektere variabler. LASSO fungerer ved å beregne parameteren , som mer komplekse modeller straffes med, og dermed kan variabler ekskluderes.
I R brukes pakken glmnet() for å utføre LASSO. Pakken aksepterer ikke en data frame, men krever at utfallet og prediktorene spesifiseres i to separate matriser (se nedenfor). Alle variabler av typen character må konverteres til factor. Deretter må det gjøres one-hot encoding for faktorer, noe som innebærer at en factor med 4 nivåer konverteres til 4 ulike binære variabler (én for hvert nivå av den opprinnelige variabelen). Følg kommentarene i koden nedenfor for å forstå hvilke trinn som utføres.
## Aktiver mltools for å få tilgang til funksjonen one_hot()
library(mltools)
## Aktiver data.table for å få tilgang til funksjonen as.data.table()
library(data.table)
## Aktiver glmnet som har lasso()
library(glmnet)

## Konverterer alle character til factor
mpg <- mpg %>% mutate_if(is.character, as.factor)

## One-hot encoding
mpg <- one_hot(as.data.table(mpg))

## Alle prediktorer havner i én matrise
x <- as.matrix(select(mpg, -hwy))

## Utfallsmålet havner i en annen matrise
y <- as.matrix(select(mpg, hwy))

my_lasso <- glmnet(x,y)
print(my_lasso)
Resultatet blir som følger nedenfor (forkortet). DF (degrees of freedom) er antall frihetsgrader, som er antall prediktorer. %Dev ligner målet R2 (altså et mål på prediksjonsevne).
Call:  glmnet(x = x, y = y)

   Df  %Dev Lambda
1   0  0.00 5.6800
2   1 15.51 5.1750
3   1 28.39 4.7160
4   1 39.09 4.2970
5   1 47.97 3.9150
6   1 55.34 3.5670
7   1 61.46 3.2500
..................
80 63 98.07 0.0037
81 63 98.07 0.0033
82 63 98.07 0.0030
83 63 98.07 0.0028
84 63 98.07 0.0025
85 64 98.07 0.0023
For en bestemt kan vi se hvilke variabler som er med i modellen med følgende kommando:
coef(my_lasso, 1)83 x 1 sparse Matrix of class "dgCMatrix"
s1
(Intercept) 6.1476740
drv_4 -0.8684261
cty 1.0483884Vi kan visualisere prediktorene i den beste modellen med funksjonen plot_glmnet() fra pakken plotmo. Hvis du ikke har plotmo, må du installere den først (install.packages("plotmo")). Nedenfor visualiserer vi de 5 beste prediktorene.
library(plotmo)
plot_glmnet(my_lasso, label=5)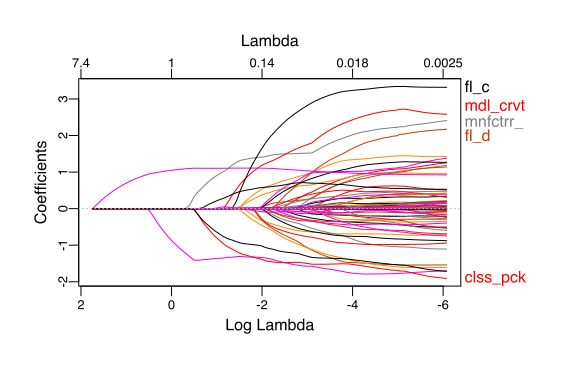
LASSO bør egentlig gjøres med kryssvalidering (cross validation). For å gjenta prosessen med kryssvalidering med 5 folder brukes følgende kommando:
cv_lasso_fit <- cv.glmnet(x = x, y = y,
                          alpha = 1,
                          nfolds = 5)
Vi kan visualisere resultatet av LASSO som følger:
plot(cv_lasso_fit)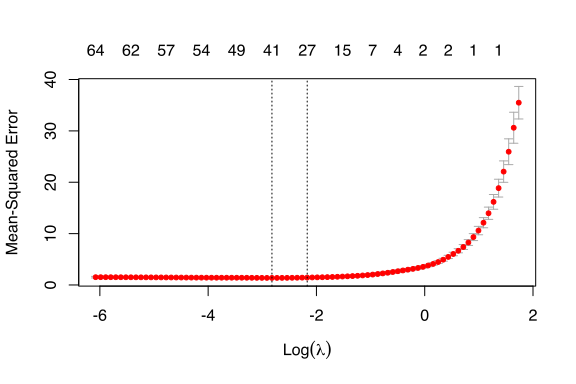
Grafen ovenfor viser MSE (gjennomsnittet av kvadrert error) på Y-aksen, og X-aksen viser log() med et konfidensintervall for hver modell. Det finnes to vertikale (stiplede) linjer. Linjen til venstre viser hvor laveste MSE er. Linjen til høyre ligger 1 standard error høyere (i MSE) og indikerer lambda for en mer regularisert modell. En regularisert modell har mindre overfitting og predikerer bedre på testdata.
Vi kan hente ut for modellen med laveste MSE med følgende kommando:
cv_lasso_fit$lambda.min[1] 0.0213847Vi kan hente ut lambda for modellen som har 1 standard error høyere MSE:
cvdata$lambda.1se[1] 0.071673For å få ut hvilke variabler dette er, skriver man:
coef(cv_lasso_fit, cv_lasso_fit$lambda.1se)83 x 1 sparse Matrix of class "dgCMatrix"
s1
(Intercept) -64.0455866216
manufacturer_audi 1.5005369115
manufacturer_jeep -0.1174150053
manufacturer_land rover 0.1612552376
manufacturer_nissan -0.1059190236
manufacturer_pontiac 0.8169337991
model_4runner 4wd -0.5598256719
model_a4 quattro 0.5838794421
model_c1500 suburban 2wd -0.2756224964
model_caravan 2wd -0.3546136186
model_corvette 1.5663555709
model_f150 pickup 4wd -0.2270155529
model_forester awd 0.6830388254
model_grand prix 0.0193951129
model_maxima -0.6714694460
model_new beetle 0.2395820131
model_passat 0.2035794420
model_range rover 0.0072253567
model_toyota tacoma 4wd -0.1979795939
year 0.0353436525
cyl -0.0568519000
trans_auto(av) -0.4658374498
trans_auto(l3) -0.8101522067
trans_auto(l4) -0.0860617303
trans_auto(l5) 0.1494574949
trans_auto(s5) 0.5779641947
drv_4 -1.5127151569
drv_f 0.0009265857
cty 1.0643633366
fl_c 2.5131385470
fl_d 0.5011373754
fl_e -0.8901996792
class_2seater 0.0315777873
class_compact 0.0529440191
class_midsize 0.6824124438
class_pickup -1.4729080052
class_suv -1.2054913050Machine learning for variabelseleksjon
Machine learning, særlig random forest, kan også brukes til å identifisere viktige variabler. Machine learning (random forest) har en naturlig måte å kvantifisere hver prediktors styrke på, og dermed kan man rangere alle prediktorene etter deres prediksjonsevne. Dette blir stadig vanligere i kliniske studier, og fordelen er at disse metodene kan håndtere et svært stort antall kandidatvariabler (tusenvis av variabler går utmerket). Andre metoder, som principal component analysis (PCA), kan også brukes, men random forest har flere fordeler sammenlignet med disse. Disse metodene diskuteres i de respektive kapitlene.