I dette kapittelet brukes tidymodels til å lage og sammenligne ulike modeller i en arbeidsflyt (workflow). Som i forrige kapittel skal vi optimere modellene med kryssvalidering. Følgende skal gjøres:
- Alle modeller evalueres ved resampling (kryssvalidering).
- To ulike oppskrifter evalueres.
- Tre ulike modeller evalueres.
- To av modellene gjennomgår optimering av hyperparametere. For den ene modellen gjøres dette ved manuell definering av et grid (kombinasjon av hyperparametere). For den andre modellen gjøres det ved å la R lage et grid.
Vi begynner med å aktivere nødvendige pakker og aktivere data fra en studie av pasienter med tykktarmskreft (koloncancer).
library(tidyverse) # for håndtering av data
library(tidymodels) # grunnpakken for prediksjonsmodellering
library(dials) # for å optimere hyperparametere
library(finetune) # ytterligere funksjoner for å optimere hyperparametere
Data til denne øvelsen kommer fra pakken survival, der data om individer med koloncancer er tilgjengelig. Vi aktiverer survival og laster inn alle datasett med kreftstudier. Deretter inspiserer vi colon, som er dataene vi skal arbeide med.
library(survival)
data(cancer) # aktiver alle datasett med kreftstudier
head(colon, 10) # inspiser de første 10 radene i studien om koloncancer
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1I colon finnes kolonnen status, som er studiens utfallsmål. Verdien 1 angir at pasienten er død, og verdien 0 angir at pasienten har overlevd. I likhet med forrige kapittel skal vi modifisere colon-dataene med følgende trinn:
- Vi koder om
status1tilYesog0tilNoog gjør variabelen til en faktor med funksjonenrecode_factor(). - Vi koder om
sexslik at det står Kvinna og Man i stedet for henholdsvis 0 og 1. - Vi fjerner kolonnene
time,idogstudyfordi vi ikke skal bruke dem i modellen vår. - Variabler med
0/1kodes om tilNo/Yespå en smart måte medmutate(across()). Merk at vi medacross()kan velge flere kolonner som vi vil bruke funksjonenrecode_factor()på, og deretter representeres kolonnen av.xi funksjonen. Se linje 5 nedenfor.
colon2 <- colon |>
  mutate(status = recode_factor(status, "1"="Yes", "0"="No"),
         sex = recode_factor(sex, "0"="Kvinna", "1"="Man")) |>
  select(-time, -id, -study) |>
  mutate(across(c(obstruct, adhere, perfor, surg, node4), ~recode_factor(.x, "0"="No", "1"="Yes")))

## Inspiser data
head(colon2, 10)
rx sex age obstruct perfor adhere nodes status differ extent surg node4 etype
1 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 2
2 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 1
3 Lev+5FU Man 63 No No No 1 No 2 3 No No 2
4 Lev+5FU Man 63 No No No 1 No 2 3 No No 1
5 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 2
6 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 1
7 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 2
8 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 1
9 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 2
10 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 1Kartlegg og imputer manglende data
Vi fortsetter med å undersøke forekomsten av manglende data (missing data) i colon2. Dette gjør vi med funksjonen vis_miss() fra pakken visdat, slik:
library(visdat)
vis_miss(colon2)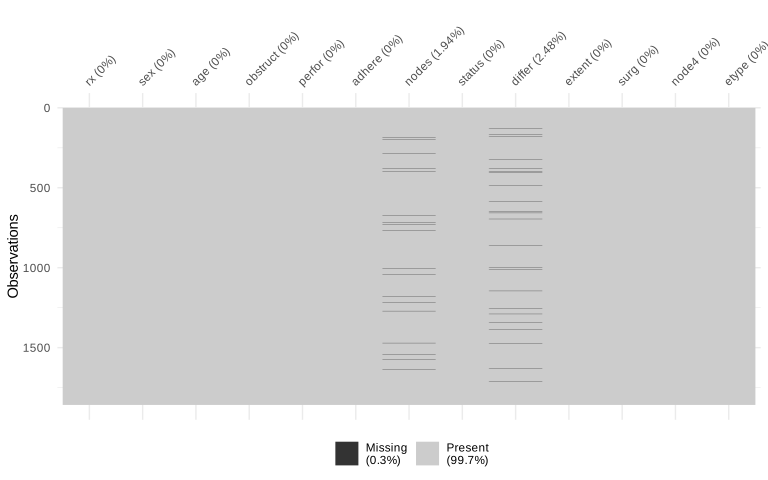
Som det fremgår av resultatet ovenfor, får vi en figur der kolonnene og radene i colon2 visualiseres i et rektangel. Det fremgår at det totalt mangler 0,3 % av alle verdiene i colon2. Selv om dette er et uvanlig lavt tall, velger vi likevel å imputere disse verdiene med funksjonen missRanger(), som finnes i pakken med samme navn. Resultatet sender vi til colon3, som nå er en dataframe uten manglende data (alle manglende verdier er imputert).
library(missRanger)
colon3 <- missRanger(data=colon2, maxiter=10, pmm.k = 5)

vis_miss(colon3)
Lag treningsdata, testdata og resampling (kryssvalidering)
Vi deler nå colon3 i treningsdata (70 % av dataene) og testdata (30 %). Fordi studien har som mål å undersøke hendelsen død, velger vi å stratifisere delingen på utfallet (strata=status), slik at andelen som dør er like stor i treningsdata og testdata.
## Lager treningsdata og testdata med set.seed() først
set.seed(1)

colon_split <- initial_split(colon3, strata=status, prop=0.7)
colon_train <- training(colon_split)
colon_test  <- testing(colon_split)

## Lager kryssvalidering av treningsdata
my_cross_validation <- vfold_cv(colon_train,
                                v = 5,
                                repeats=10,
                                strata = status)
Merk at vi har angitt set.seed(1), noe som eliminerer effekten av tilfeldighet når vi genererer test- og treningsdata. Det betyr at vi kan generere nøyaktig de samme observasjonene i treningsdata og testdata hver gang vi bruker initial_split(). Dette kan være ønskelig for å få resultater som kan reproduseres nøyaktig.
Lag oppskrifter
Vi lager to oppskrifter (recipes). Den første oppskriften kaller vi base_recept. Se kommentarene i koden nedenfor for å se hvilke pre-processing-trinn som utføres. Den andre oppskriften heter extended_recipe og bygger på base_recept, men har tillegget step_pca(). Hvis du ikke er kjent med metoden PCA, kan du foreløpig bare merke deg at PCA er en metode som reduserer antallet numeriske prediktorer, noe som av og til gir bedre modeller.
## Grunnleggende oppskrift
base_recipe <- recipe(status ~ ., data=colon_train) |>
  # Normalisering av numeriske prediktorer
  step_normalize(all_numeric()) |>
  # Lager dummyvariabler av kategoriske variabler
  step_dummy(all_nominal_predictors()) |>
  # Gir toleranse for nye variabelnivåer i testdata
  step_novel(all_nominal_predictors())

## Utvidet oppskrift basert på base_recipe
extended_recipe <-
  base_recipe |>
  step_pca(all_numeric_predictors())
Lag modeller
Vi lager tre modeller med følgende innstillinger:
Logistisk regresjon.
- Hyperparametere: ingen.
- Metode: GLM (vanlig logistisk regresjon)
Random forest.
Hyperparametere: 2 stk. Vi lager gridet vårt manuelt med funksjonen
crossing().Metode: Ranger-pakken.
Xtreme gradient boosting.
- Hyperparametere: 8 stk. Vi lager gridet vårt med funksjonen
grid_latin_hypercube()., som ut fra antallet tillatte kombinasjoner (size=n) maksimerer hvilke kombinasjoner som undersøkes. - Metode: Ranger-pakken.
- Hyperparametere: 8 stk. Vi lager gridet vårt med funksjonen
## 1. LOGISTISK REGRESJON =====================================
glm_spec <-
  logistic_reg() %>%
  set_engine('glm') %>%
  set_mode('classification')

## 2. RANDOM FOREST ============================================
rf_spec <- rand_forest(mtry = tune(),
                       trees = tune()) |>
  set_engine("ranger") |>
  set_mode("classification")

## Med funksjonen crossing() lages et grid manuelt.
## Angi manuelt hvilke verdier som skal testes for hver parameter
rf_grid <- crossing(mtry = c(3, 6, 9),
                    trees=c(100, 200))

## 3. XTREME GRADIENT BOOSTING ================================
## Definer modellen
xgb_spec <-
  boost_tree(tree_depth = tune(),
             mtry = tune(),
             trees = tune(),
             learn_rate = tune(),
             min_n = tune(),
             loss_reduction = tune(),
             sample_size = tune(),
             stop_iter = tune()) %>%
  set_engine('xgboost') %>%
  set_mode('classification')

## Lag et grid med grid_latin_hypercube()
xgb_grid <- grid_latin_hypercube(
  trees(),
  min_n(),
  learn_rate(),
  loss_reduction(),
  tree_depth(),
  sample_prop(),
  stop_iter(),
  finalize(mtry(), colon_train),
  size = 10)
Lager workflow
Vi lager nå et sett med workflows med funksjonen workflow_set(). Her lages to lister. Den første listen er preproc, og der angis oppskriftene. Neste argument er models, og der angis modellene. Argumentet cross settes til TRUE fordi alle modeller skal testes med alle oppskrifter.
Vi må legge gridene våre til workflowet med funksjonen option_add(). Her angis hvilket grid som skal legges til et bestemt workflow. Som det fremgår nedenfor, er navnet på hvert workflow dets pre-processor og modell atskilt med en understrek (for eksempel base_xgb).
my_wf <-
   workflow_set(
      preproc = list(base = base_recipe,
                     extended = extended_recipe),
      models = list(glm = glm_spec,
                    rf = rf_spec,
                    xgb = xgb_spec),
      cross = TRUE
   ) %>%
   # Legger til spesifikt grid search til spesifikk arbeidsflyt
   option_add(id = "base_xgb",     grid = xgb_grid) %>%
   option_add(id = "extended_xgb", grid = xgb_grid) %>%
   option_add(id = "base_rf",      grid = rf_grid) %>%
   option_add(id = "extended_rf",  grid = rf_grid)
Kjør modellene
For å kjøre modellene bruker vi parallellisering, noe som betyr at vi utnytter flere av datamaskinens kjerner hvis det er mulig. Parallelliseringen krever pakkene doParallel og parallel. Pakken tictoc brukes til å måle hvor lang tid det tar å kjøre alle modellene.
Husk å ikke bruke alle kjernene i datamaskinen din. La alltid 2 kjerner være ledige for andre prosesser på maskinen. I eksempelet nedenfor har datamaskinen 8 kjerner, og derfor brukes 6 kjerner til beregningene nedenfor. Antall kjerner angis med funksjonen makePSOCKcluster().
library(doParallel)
library(parallel)
library(tictoc)

## Start parallellisering
mitt_kluster <- makePSOCKcluster(6)
registerDoParallel(mitt_kluster)
tic()

## Kjør modellene
my_wf_results <-
   workflow_map(object=my_wf,
                "tune_grid",
                seed = 1,
                resamples = my_cross_validation,
                metrics = yardstick::metric_set(roc_auc),
                verbose = TRUE,
                control   = control_grid(save_pred = TRUE,
                           parallel_over = "everything",
                           save_workflow = TRUE)
                )

## Stopp parallellisering
stopCluster(mitt_kluster)
toc()
i No tuning parameters. `fit_resamples()` will be attempted
i 1 of 6 resampling: base_glm
✔ 1 of 6 resampling: base_glm (24.4s)
i 2 of 6 tuning: base_rf
✔ 2 of 6 tuning: base_rf (2m 52.9s)
i 3 of 6 tuning: base_xgb
✔ 3 of 6 tuning: base_xgb (6m 40.6s)
i No tuning parameters. `fit_resamples()` will be attempted
i 4 of 6 resampling: extended_glm
✔ 4 of 6 resampling: extended_glm (11.6s)
i 5 of 6 tuning: extended_rf
✔ 5 of 6 tuning: extended_rf (3m 51.6s)
i 6 of 6 tuning: extended_xgb
✔ 6 of 6 tuning: extended_xgb (17m 25.1s)
1893.746 sec elapsedKjøringen tok 1893 sekunder.
Sammenlign modellene
Med funksjonen autoplot() får vi en rask oversikt over modellenes evne til å predikere utfallet, basert på det presisjonsmålet vi har valgt (AUC ROC).
autoplot(my_wf_results)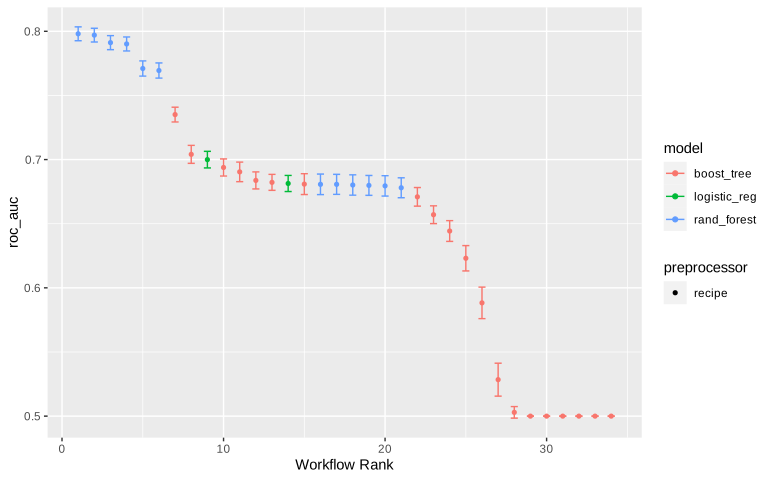
Vi kan hente ut de beste modellene med følgende kode
rank_results(my_wf_results,
             rank_metric = "roc_auc",
             select_best = TRUE) %>%
   select(rank, mean, model, wflow_id, .config)
rank mean model wflow_id .config
<int> <dbl> <chr> <chr> <chr>
1 1 0.798 rand_forest base_rf Preprocessor1_Model6
2 2 0.735 boost_tree base_xgb Preprocessor1_Model01
3 3 0.700 logistic_reg base_glm Preprocessor1_Model1
4 4 0.694 boost_tree extended_xgb Preprocessor1_Model02
5 5 0.681 logistic_reg extended_glm Preprocessor1_Model1
6 6 0.681 rand_forest extended_rf Preprocessor1_Model1Den beste modellen er random forest med grunnoppskriften (base_rf). Den beste konfigurasjonen heter Preprocessor1_Model6.
For å se hvilken konfigurasjon dette er, skriver vi:
best_model <- my_wf_results %>%
  extract_workflow_set_result("base_rf") %>%
  select_best(metric = "roc_auc")

best_model
mtry trees .config
9 200 Preprocessor1_Model6modellen har mtry = 9 og trees = 200.
Husk at treningen ble gjort med kryssvalidering, noe som betyr at modellen aldri har blitt trent på alle treningsdataene (én fold har blitt brukt til å teste modellen, se Kryssvalidering). Den beste modellen trenes derfor en siste gang på alle treningsdataene:
my_finalized_wf <-
  my_wf_results |>
  extract_workflow("base_rf") |>
  finalize_workflow(best_model) |>
  last_fit(split = colon_split,
           metrics = yardstick::metric_set(roc_auc))
Objektet my_finalized_wf inneholder den endelige modellen. Med funksjonen collect_metrics() kan vi hente ut informasjon om hvor god modellen er på testdata. Merk at vi ikke trenger å spesifisere testdata, fordi tidymodels bruker testdataene automatisk (objektet my_finalized_wf har tilgang til testdataene fordi vi spesifiserte split=colon_split ovenfor).
collect_metrics(my_finalized_wf) .metric .estimator .estimate .config
roc_auc binary 0.792 Preprocessor1_Model1ROC-kurven har et areal på 0,793.
Vi kan nå studere selve prediksjonene ved å bruke funksjonen collect_predictions():
pred_data <- collect_predictions(my_finalized_wf## A tibble: 558 × 6
id .pred_Yes .pred_No .row status .config
<chr> <dbl> <dbl> <int> <fct> <chr>
1 train/test split 0.873 0.127 2 Yes Preprocessor1_Model1
2 train/test split 0.0959 0.904 4 No Preprocessor1_Model1
3 train/test split 0.559 0.441 8 Yes Preprocessor1_Model1
4 train/test split 0.578 0.422 13 Yes Preprocessor1_Model1
5 train/test split 0.560 0.440 14 Yes Preprocessor1_Model1
6 train/test split 0.327 0.673 20 No Preprocessor1_Model1
7 train/test split 0.292 0.708 21 No Preprocessor1_Model1
8 train/test split 0.333 0.667 22 No Preprocessor1_Model1
9 train/test split 0.454 0.546 30 No Preprocessor1_Model1
10 train/test split 0.605 0.395 32 Yes Preprocessor1_Model1ROC-kurven lages med følgende kode:
pred_data %>%
  roc_curve(status, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal() +
  theme_bw()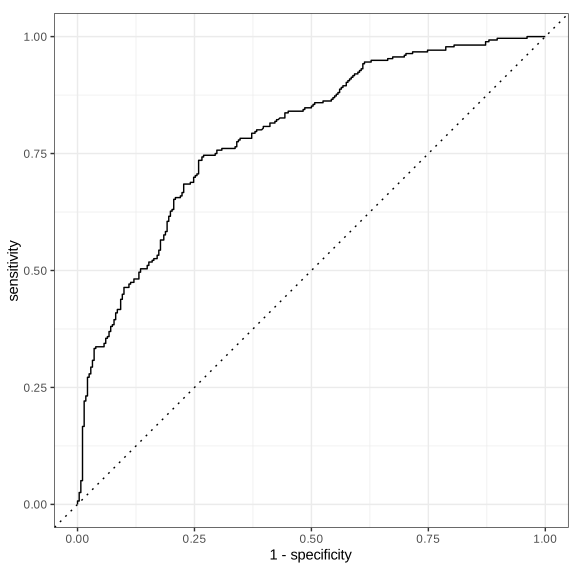
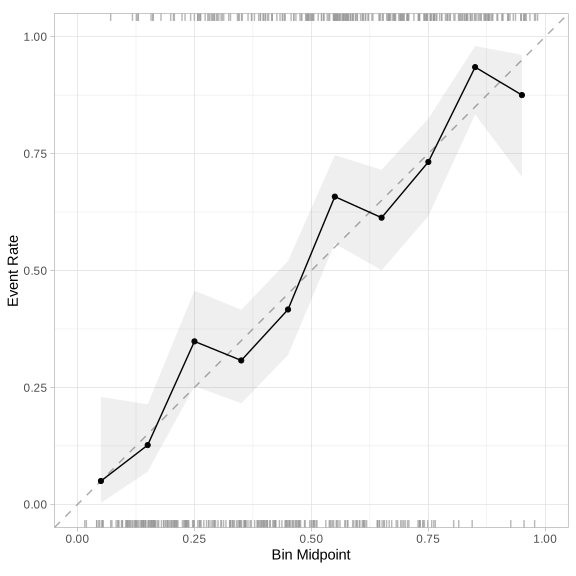
For å avklare om modellen er godt kalibrert, bruker vi funksjonen cal_plot_breaks() fra pakken probably. Merk at denne funksjonen krever at testversjonen av probably er installert. Den installeres med følgende kommando:
install.packages("remotes")
remotes::install_github("tidymodels/probably")
library(probably)

pred_data %>%
  cal_plot_breaks(status, .pred_Yes)