
Funksjoner for å inspisere rådata
I base R (grunninstallasjonen av R) finnes det funksjoner som kan brukes til å inspisere rådata. Med funksjonen View() vises dataene i en tabell som kan søkes i og sorteres. Dette er nyttig for å gjøre manuelle kontroller i rådata.
I dette kapitlet arbeider vi med rhc-data, som ble forklart i forrige kapittel. Hvis du ikke har lastet ned dataene, kan du gjøre det etter instruksjonene i forrige kapittel.
View(rhc)Dette vinduet åpnes når du bruker View():
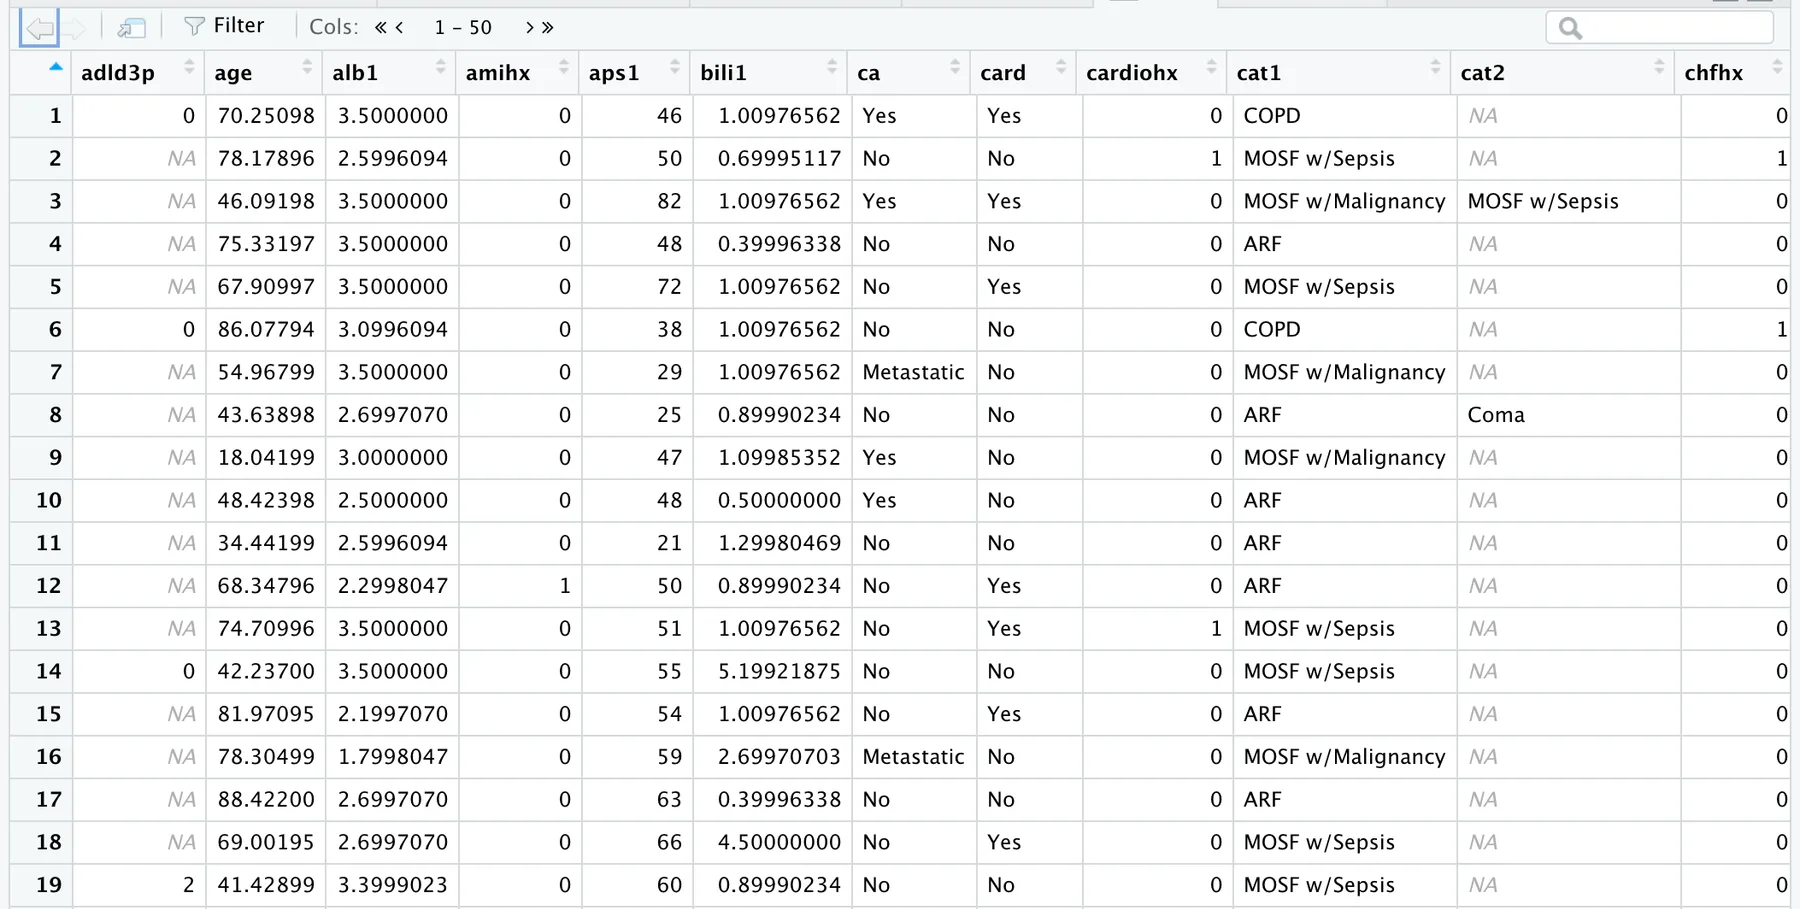
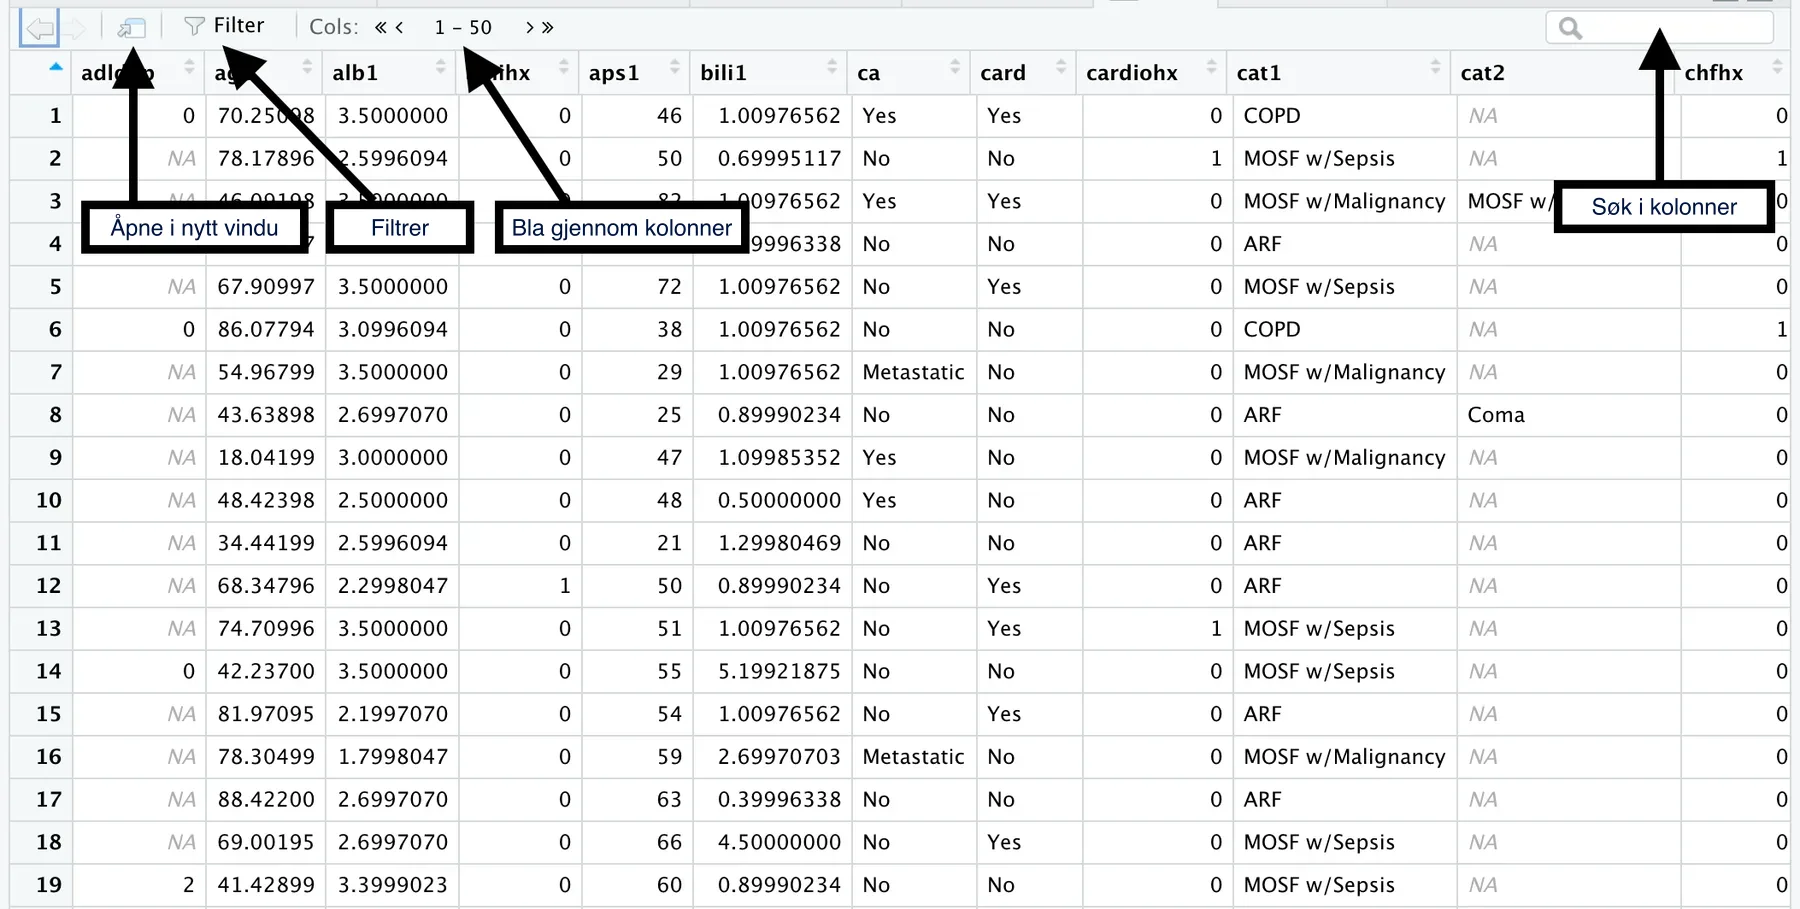
Øverst i vinduet finnes det funksjoner som du kan bruke til å filtrere i datasettet, bla gjennom kolonnene og søke i hele datasettet. Disse funksjonene fremgår av bildet nedenfor.
Vi fortsetter med head() og tail(), som viser henholdsvis de første 5 og de siste 5 radene i vår data frame. Du kan justere dette ved å angi hvor mange rader du vil se, som andre argument i disse funksjonene.
## Første 3 rader
head(rhc, 3)

## Siste 2 rader
tail(rhc, 3)
Resultatet av head():
| adld3p <int> | age <dbl> | alb1 <dbl> | amihx <int> | aps1 <int> | bili1 <dbl> | ca <chr> | card <chr> | cardiohx <int> |
|---|---|---|---|---|---|---|---|---|
| 0 | 70.25098 | 3.500000 | 0 | 46 | 1.0097656 | Yes | Yes | 0 |
| NA | 78.17896 | 2.599609 | 0 | 50 | 0.6999512 | No | No | 1 |
| NA | 46.09198 | 3.500000 | 0 | 82 | 1.0097656 | Yes | Yes | 0 |
Resultatet av tail():
| adld3p <int> | age <dbl> | alb1 <dbl> | amihx <int> | aps1 <int> | bili1 <dbl> | ca <chr> | card <chr> | cardiohx <int> |
|---|---|---|---|---|---|---|---|---|
| 1 | 80.48499 | 4.099609 | 0 | 43 | 1.000000 | No | No | 1 |
| NA | 67.37897 | 3.500000 | 0 | 51 | 1.009766 | No | No | 0 |
| NA | 54.66397 | 3.000000 | 0 | 101 | 21.796875 | No | No | 0 |
Pakken dplyr har funksjonen glimpse(), som gir en oversikt over dataene. Vi bruker glimpse() på rhc nå:
glimpse(rhc)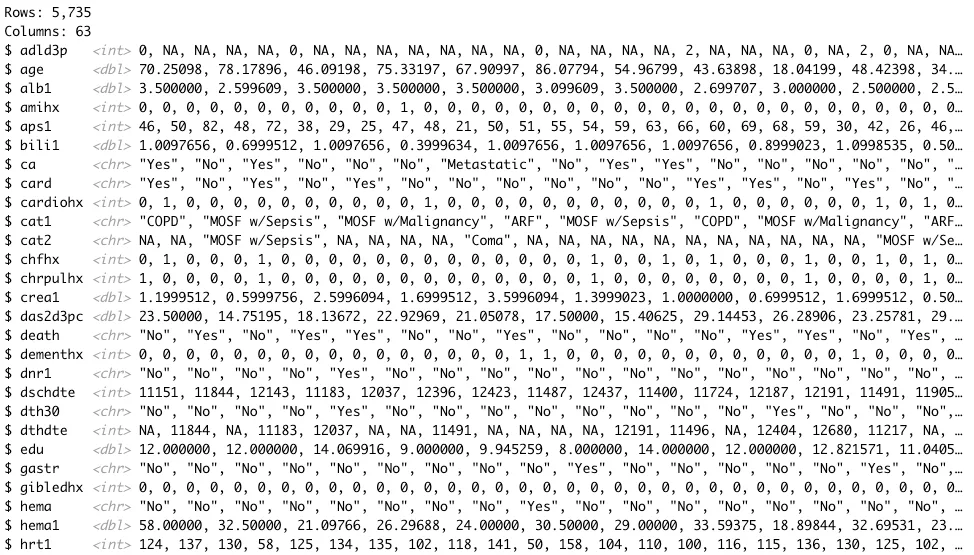
Funksjonen glimpse() gir dermed en rask oversikt over hvilke variabler som finnes i data framen, variabeltypene deres og verdiene til de første variablene.
Med funksjonen summary() kan vi på samme måte generere en beskrivelse av alle variablene. Sammenlignet med glimpse() gir summary() sentralmål og spredningsmål for hver variabel, noe som vises i følgende eksempel:
summary(rhc)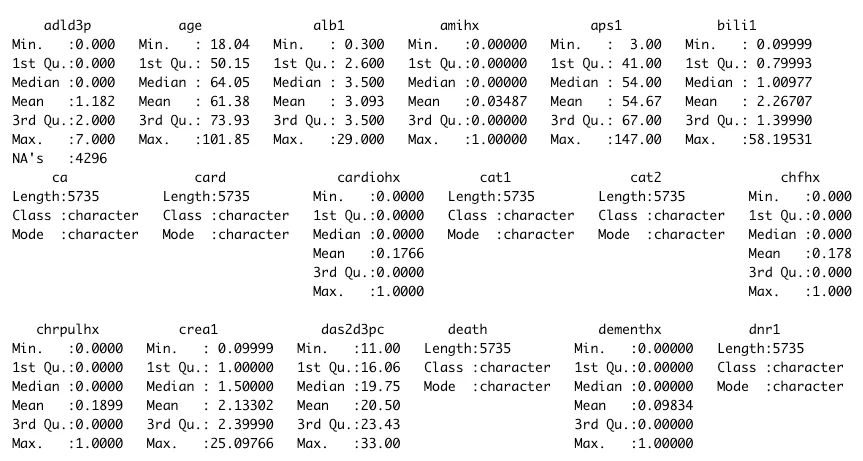
Funksjonen summary() kan brukes på en enkelt kolonne ved å referere til den med $ etter navnet på vår data frame:
summary(rhc$age)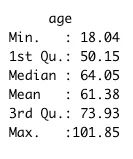
For å se variablene i én enkelt kolonne brukes samme metode som ovenfor. Kolonnenavnet får $ foran seg, slik:
rhc$age [1] 70.25098 78.17896 46.09198 75.33197 67.90997 86.07794 54.96799 43.63898 18.04199 48.42398 34.44199 68.34796 74.70996 42.23700 81.97095 78.30499
[17] 88.42200 69.00195 41.42899 67.50397 50.59000 62.68900 42.05298 23.11299 62.10797 39.82999 47.75598 36.70099 71.20099 95.53699 67.27997 73.49194
[33] 71.49597 54.79300 36.13397 61.43997 55.97299 51.39999 54.31097 67.74298 59.90399 21.09200 94.07495 41.33899 80.38300 58.04199 32.07397 80.58295
[49] 70.61200 80.18896 56.76898 85.29498 63.91498 78.08600 83.37000 61.86697 85.31995 42.92398 47.97498 58.03400 49.82898 69.19098 25.40999 68.40198
[65] 63.54797 38.91599 77.32495 58.80099 66.32196 60.65399 66.89398 63.48297 25.51399 83.35895 42.28598 57.46997 76.43500 80.03796 49.52798 40.78000
[81] 69.15295 68.70099 45.57397 59.29099 81.24597 72.81897 53.52197 39.73199 93.02399 54.08600 43.99500 64.11200 70.51599 87.13995 79.79199 46.58698
[97] 87.70996 83.56195 86.17096 49.99899 30.56499 65.08099 63.88498 47.82498 41.83698 49.68698 57.09198 55.13797 44.31998 56.30899 75.12897 76.84900
[113] 57.98999 69.40198 65.39600 79.93195 71.90997 77.19397 66.08398 20.58899 60.27100 54.08398 81.93597 36.18100 86.26996 74.68298 28.19399 86.14899
[129] 80.60498 42.01498 34.11600 82.24799 78.70795 53.31400 71.98395 67.73700 80.45697 82.41998 88.17200 76.21399Utvalg av kolonner som skal inspiseres
Funksjonene i dplyr er uvurderlige for å velge og mutere kolonner. Her følger flere eksempler med forklaringer i kommentarer i koden:
## Inspiserer de første 3 kolonnene, hema, renalhx og
## alle kolonner mellom transhx:trauma og trauma
rhc %>%
select(1:3, hema, renalhx, transhx:trauma)| adld3p <int> | age <dbl> | alb1 <dbl> | hema <chr> | renalhx <int> | transhx <int> | trauma <chr> |
|---|---|---|---|---|---|---|
| 0 | 70.25098 | 3.5000000 | No | 0 | 0 | No |
| NA | 78.17896 | 2.5996094 | No | 0 | 1 | No |
| NA | 46.09198 | 3.5000000 | No | 0 | 0 | No |
| NA | 75.33197 | 3.5000000 | No | 0 | 0 | No |
| NA | 67.90997 | 3.5000000 | No | 0 | 0 | No |
| 0 | 86.07794 | 3.0996094 | No | 0 | 0 | No |
| NA | 54.96799 | 3.5000000 | No | 0 | 0 | No |
| NA | 43.63898 | 2.6997070 | No | 0 | 1 | No |
| NA | 18.04199 | 3.0000000 | Yes | 0 | 0 | No |
| NA | 48.42398 | 2.5000000 | No | 0 | 0 | No |
Du kan legge til en View() aller sist for å inspisere alle rådataene, slik:
rhc %>%
  select(1:3, hema, renalhx, transhx:trauma) %>%
  View()
Når koden ovenfor kjøres, vises et vindu med rådata.
Du kan begrense hvilke pasienter du inspiserer, ved å bruke flere funksjoner i dplyr:
rhc %>%
  # Beholder bare pasienter som er eldre enn 50 år og har card==Yes
  filter(age>50, card=="Yes") |>
  # Velger variabler
  select(1:3, hema, renalhx, transhx:trauma) |>
  # Beholder de første 100 radene
  slice(1:100) |>
  # Åpner vinduet
  View()
Når koden ovenfor kjøres, vises et vindu med rådata.