
Flere geometriske objekter (eng. geoms) har innebygde funksjoner for statistiske transformasjoner og beregninger. I flere tidligere kapitler har vi demonstrert geom_smooth(), som beregner og visualiserer sammenhengen mellom x og y. Funksjonen geom_smooth() har argumentet method, som kan settes til "loess" for å generere en fleksibel regresjonslinje eller "lm", som genererer en lineær regresjonslinje. Det samme prinsippet gjelder for flere andre geoms, noe som innebærer at de utfører beregninger for å visualisere data.
I dette kapitlet skal vi bruke data fra gapminder for å demonstrere hvordan transformasjoner fungerer. Vi begynner med å aktivere pakken gapminder og inspisere de første 10 radene. Inspeksjon av data kan blant annet gjøres med funksjonen head().
library(gapminder)
head(gapminder, 10)| country <fctr> | continent <fctr> | year <int> | lifeExp <dbl> | pop <int> | gdpPercap <dbl> |
|---|---|---|---|---|---|
| Afghanistan | Asia | 1952 | 28.801 | 8425333 | 779.4453 |
| Afghanistan | Asia | 1957 | 30.332 | 9240934 | 820.8530 |
| Afghanistan | Asia | 1962 | 31.997 | 10267083 | 853.1007 |
| Afghanistan | Asia | 1967 | 34.020 | 11537966 | 836.1971 |
| Afghanistan | Asia | 1972 | 36.088 | 13079460 | 739.9811 |
| Afghanistan | Asia | 1977 | 38.438 | 14880372 | 786.1134 |
| Afghanistan | Asia | 1982 | 39.854 | 12881816 | 978.0114 |
| Afghanistan | Asia | 1987 | 40.822 | 13867957 | 852.3959 |
| Afghanistan | Asia | 1992 | 41.674 | 16317921 | 649.3414 |
| Afghanistan | Asia | 1997 | 41.763 | 22227415 | 635.3414 |
Deretter lager vi et stolpediagram som viser hvor mange observasjoner (rader) det finnes for hvert kontinent. Dette gjøres med geom_bar(), som lager et stolpediagram. Den eneste estetiske mappingen vi deklarerer, er x=continent. Funksjonen beregner y-aksen automatisk (antall rader for hvert kontinent).
ggplot(data=gapminder) +
  geom_bar(aes(x=continent))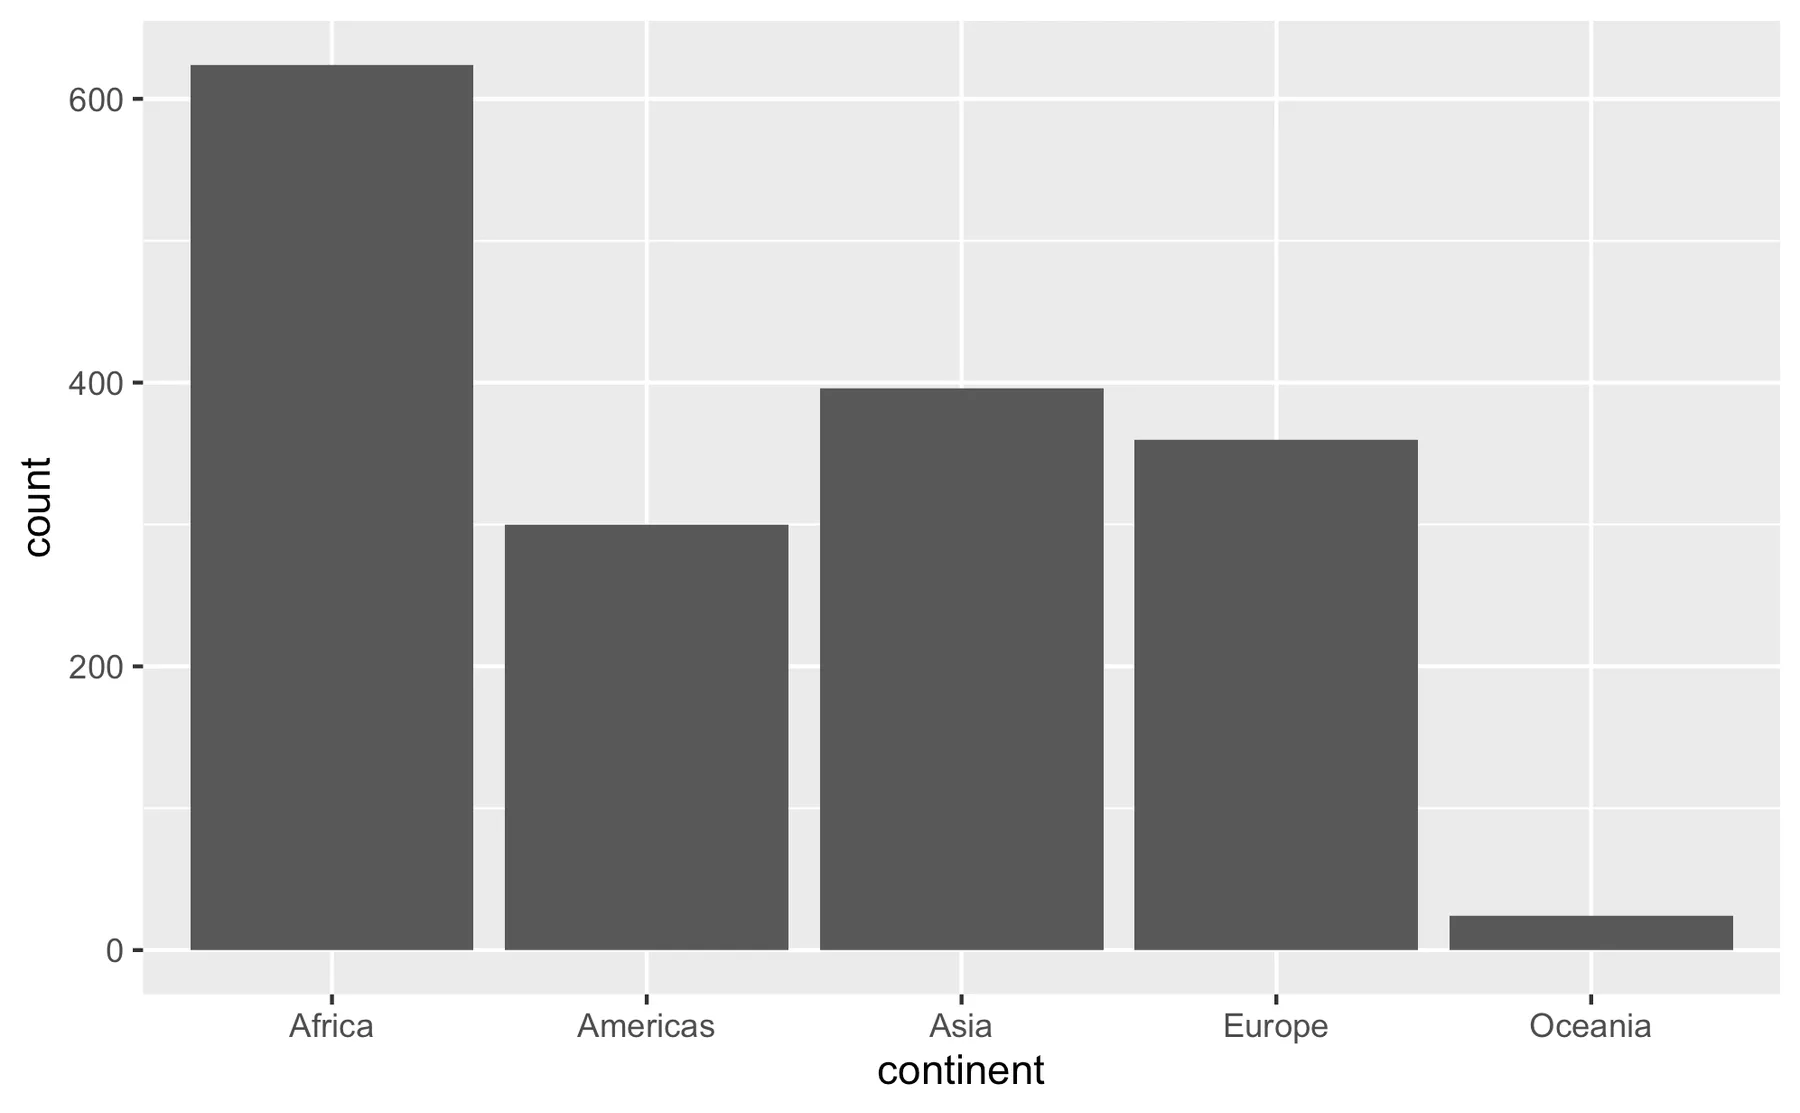
Et alternativ til det ovenstående er å beregne antall observasjoner på hvert kontinent selv. Det kan enkelt gjøres med funksjonen count() i pakken dplyr. Du har sannsynligvis allerede lastet inn dplyr, siden den inngår i pakken tidyverse. Ellers laster vi den inn nå:
library(tidyverse)Funksjonen count() teller antall rader for én eller flere kategoriske variabler, slik:
gapminder |>
count(continent)| continent <fctr> | n <int> |
|---|---|
| Africa | 624 |
| Americas | 300 |
| Asia | 396 |
| Europe | 360 |
| Oceania | 24 |
Som det fremgår ovenfor, beregnes antall rader (n) for hvert kontinent (continent).
Som det fremgår ovenfor, beregnes antall rader (n) for hvert kontinent (continent). Vi tar nå disse dataene og lager et stolpediagram som er identisk med det forrige. Siden geom_bar() ikke lenger skal beregne y-aksen selv, forteller vi at y=n, og vi bruker argumentet stat="identity" for å fortelle at verdiene allerede er beregnet. Legg også merke til at vi kobler sammen count() med ggplot() og dermed bruker resultatet av count() direkte i ggplot(). Dette er mulig fordi pipe (|>) sender resultatet av en operasjon videre til neste funksjon, der resultatet brukes som første argument (første argument i funksjonen ggplot() er data).
gapminder |>
  count(continent) |>
  ggplot(aes(x=continent, y=n)) +
  geom_bar(stat="identity")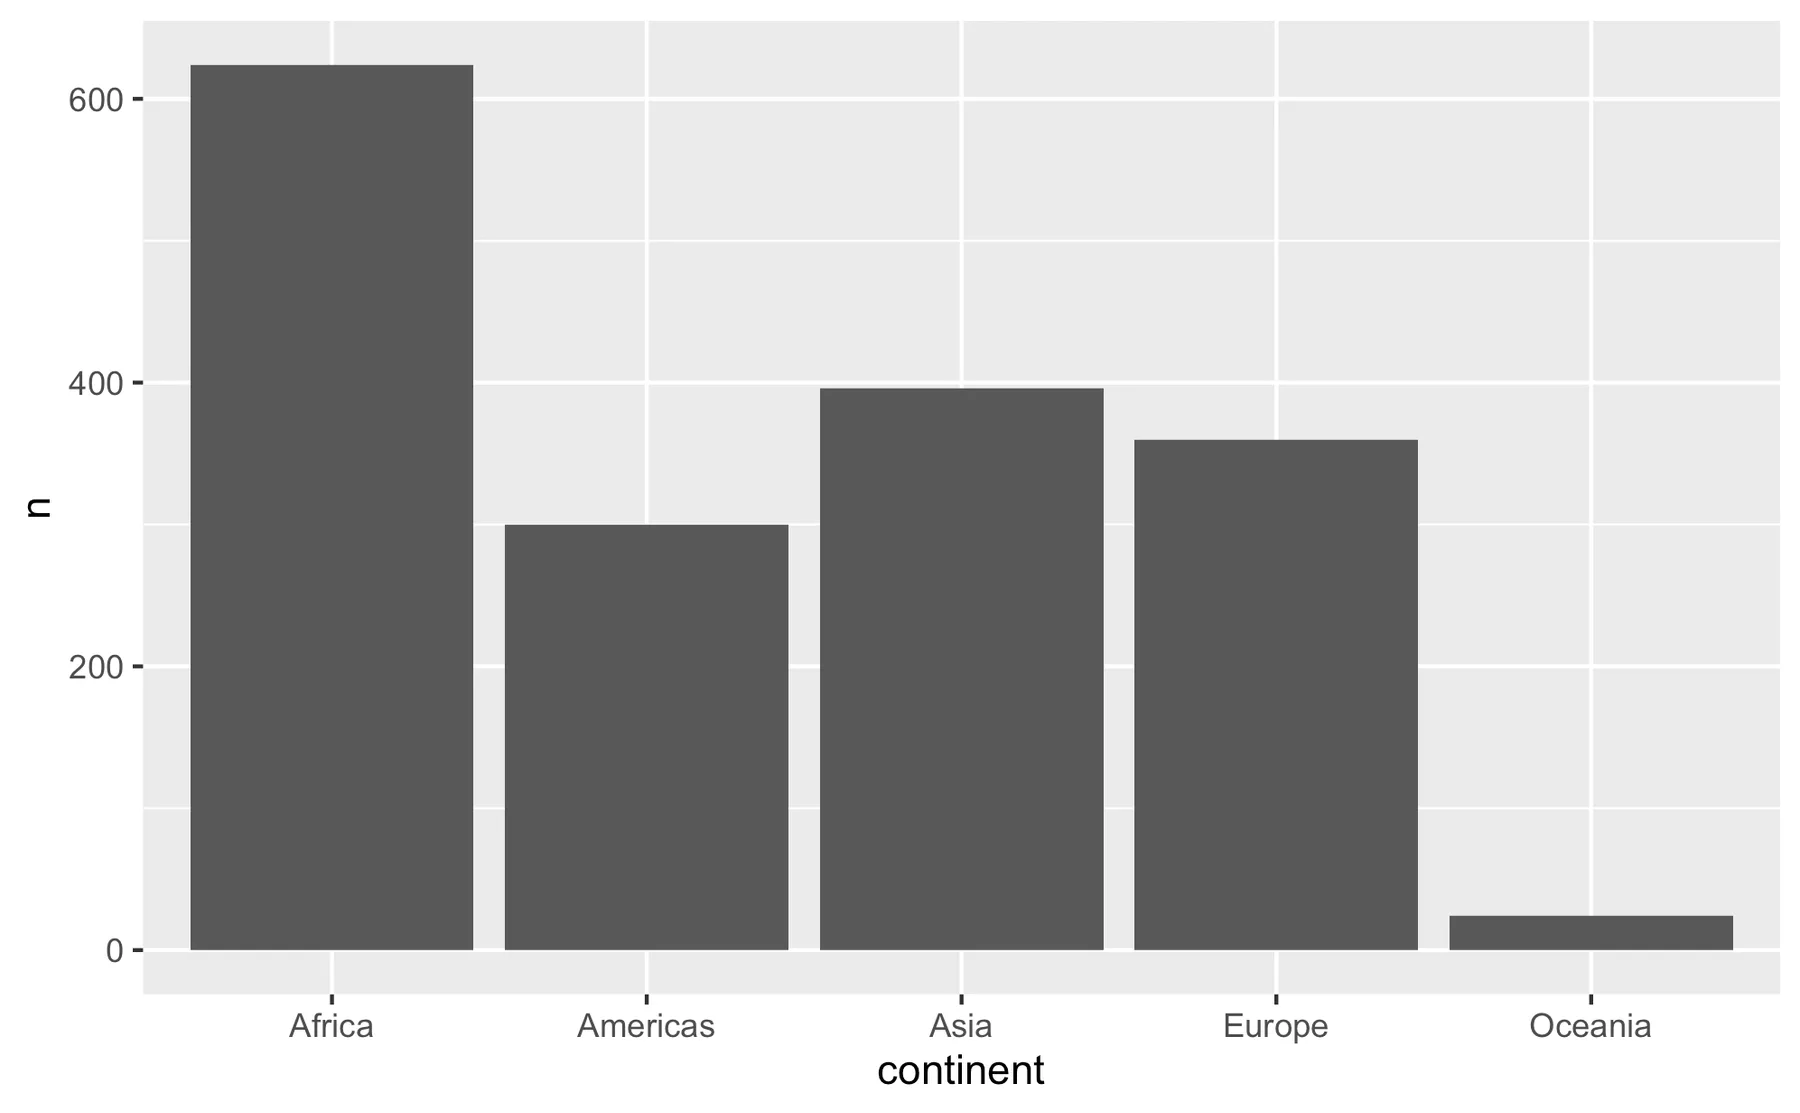
Det finnes andre transformasjoner (beregninger) innebygd i geometriske objekter. Du har allerede støtt på geom_smooth() i forrige kapittel. Her følger andre eksempler på geoms som utfører beregninger når de brukes:
geom_bar(),geom_histogram(),geom_freqpoly()beregner summer og proporsjoner.geom_boxplot(),geom_violin()beregner fordelinger.geom_smooth()lager en regresjonsmodell som visualiseres.
I neste eksempel bruker vi gapminder til å gjøre følgende:
- Linje 2: Vi beholder bare land i Afrika ved å filtrere med argumentet
continent=="Africa". - Linje 2: Vi beholder bare data fra år 1997 ved å filtrere med argumentet
year==1997. - Linje 2: Vi kobler
ggplot()direkte sammen med de foregående operasjonene med|> - Linje 4: Vi lager et stolpediagram der land er y-aksen og forventet levealder er x-aksen. Siden disse verdiene allerede er beregnet, brukes argumentet
stat="identity":
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=country,
               x=pop),
           stat="identity")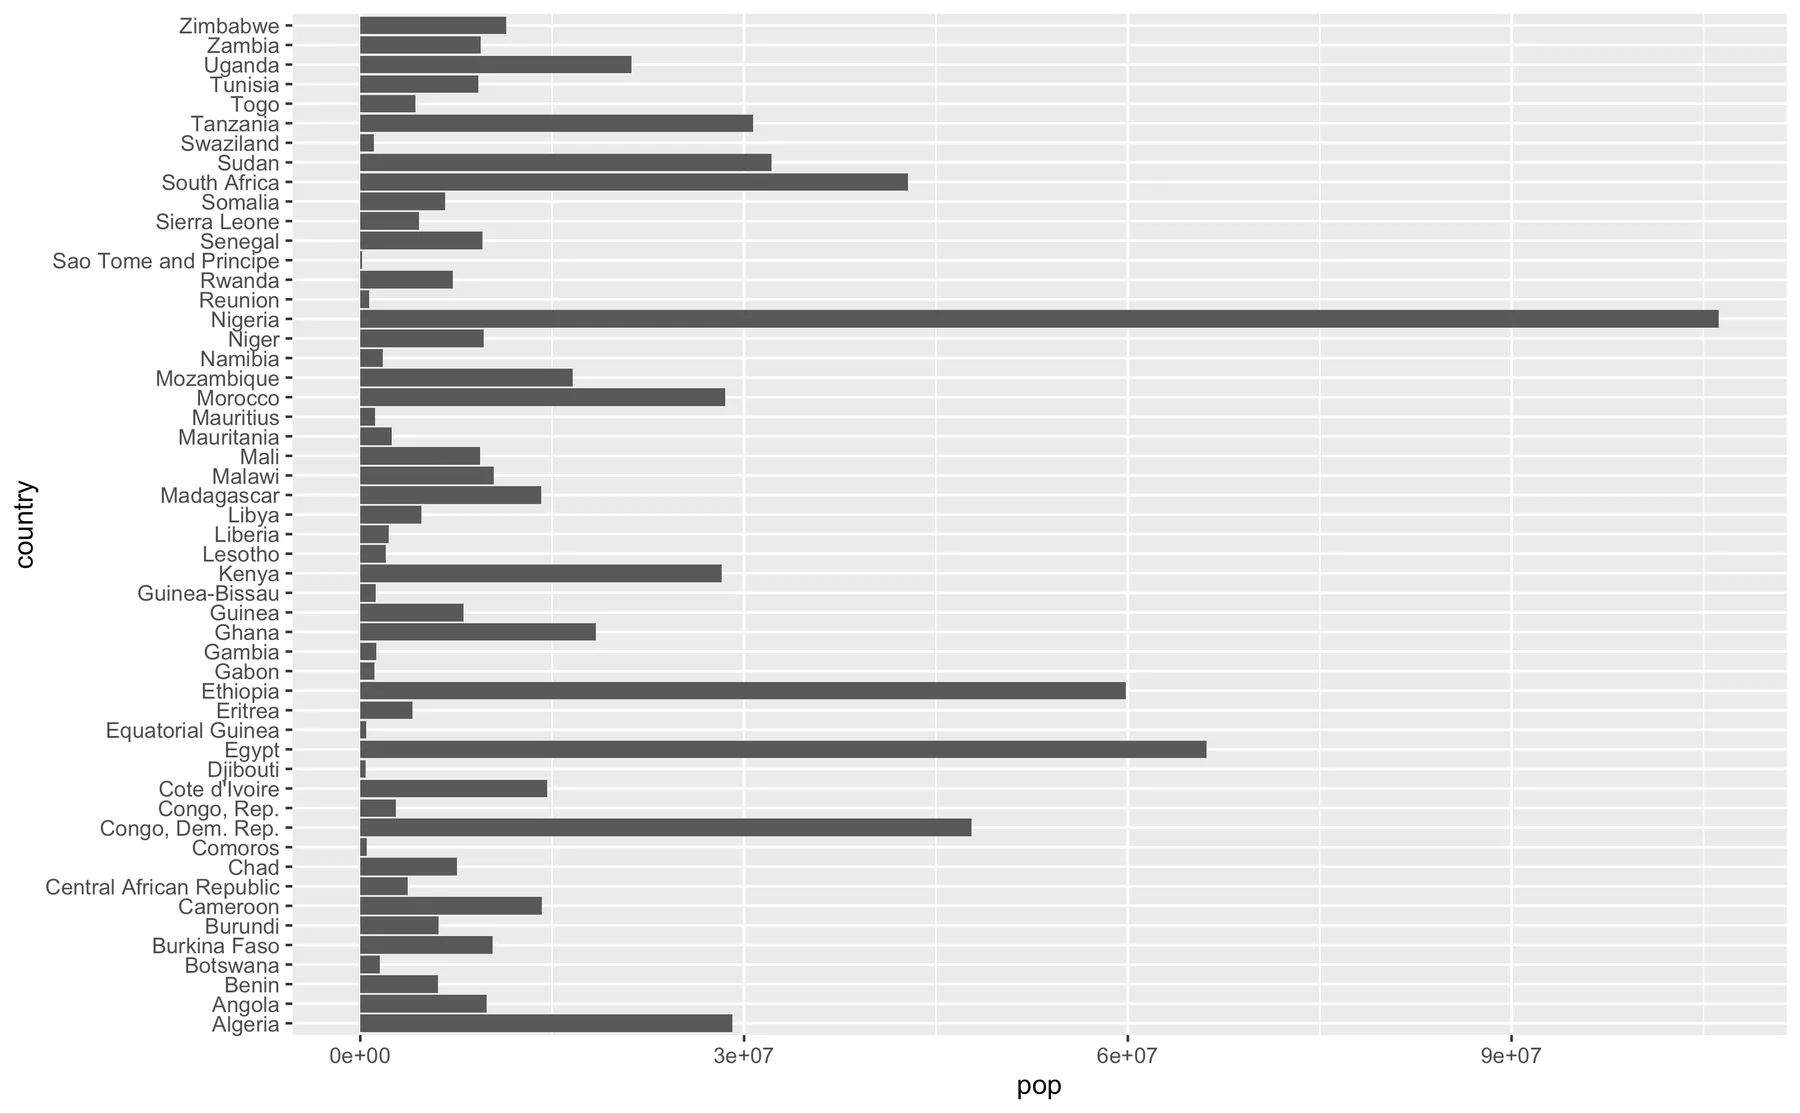
Vi fortsetter med å sortere y-aksen etter forventet levealder (lifeExp). Dette kan gjøres direkte i aes() med funksjonen reorder(). I reorder spesifiseres hva som skal sorteres (country), og kolonnen det skal sorteres etter (pop, som er folketall). Se linje 4 nedenfor.
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, pop),
               x=pop),
           stat="identity")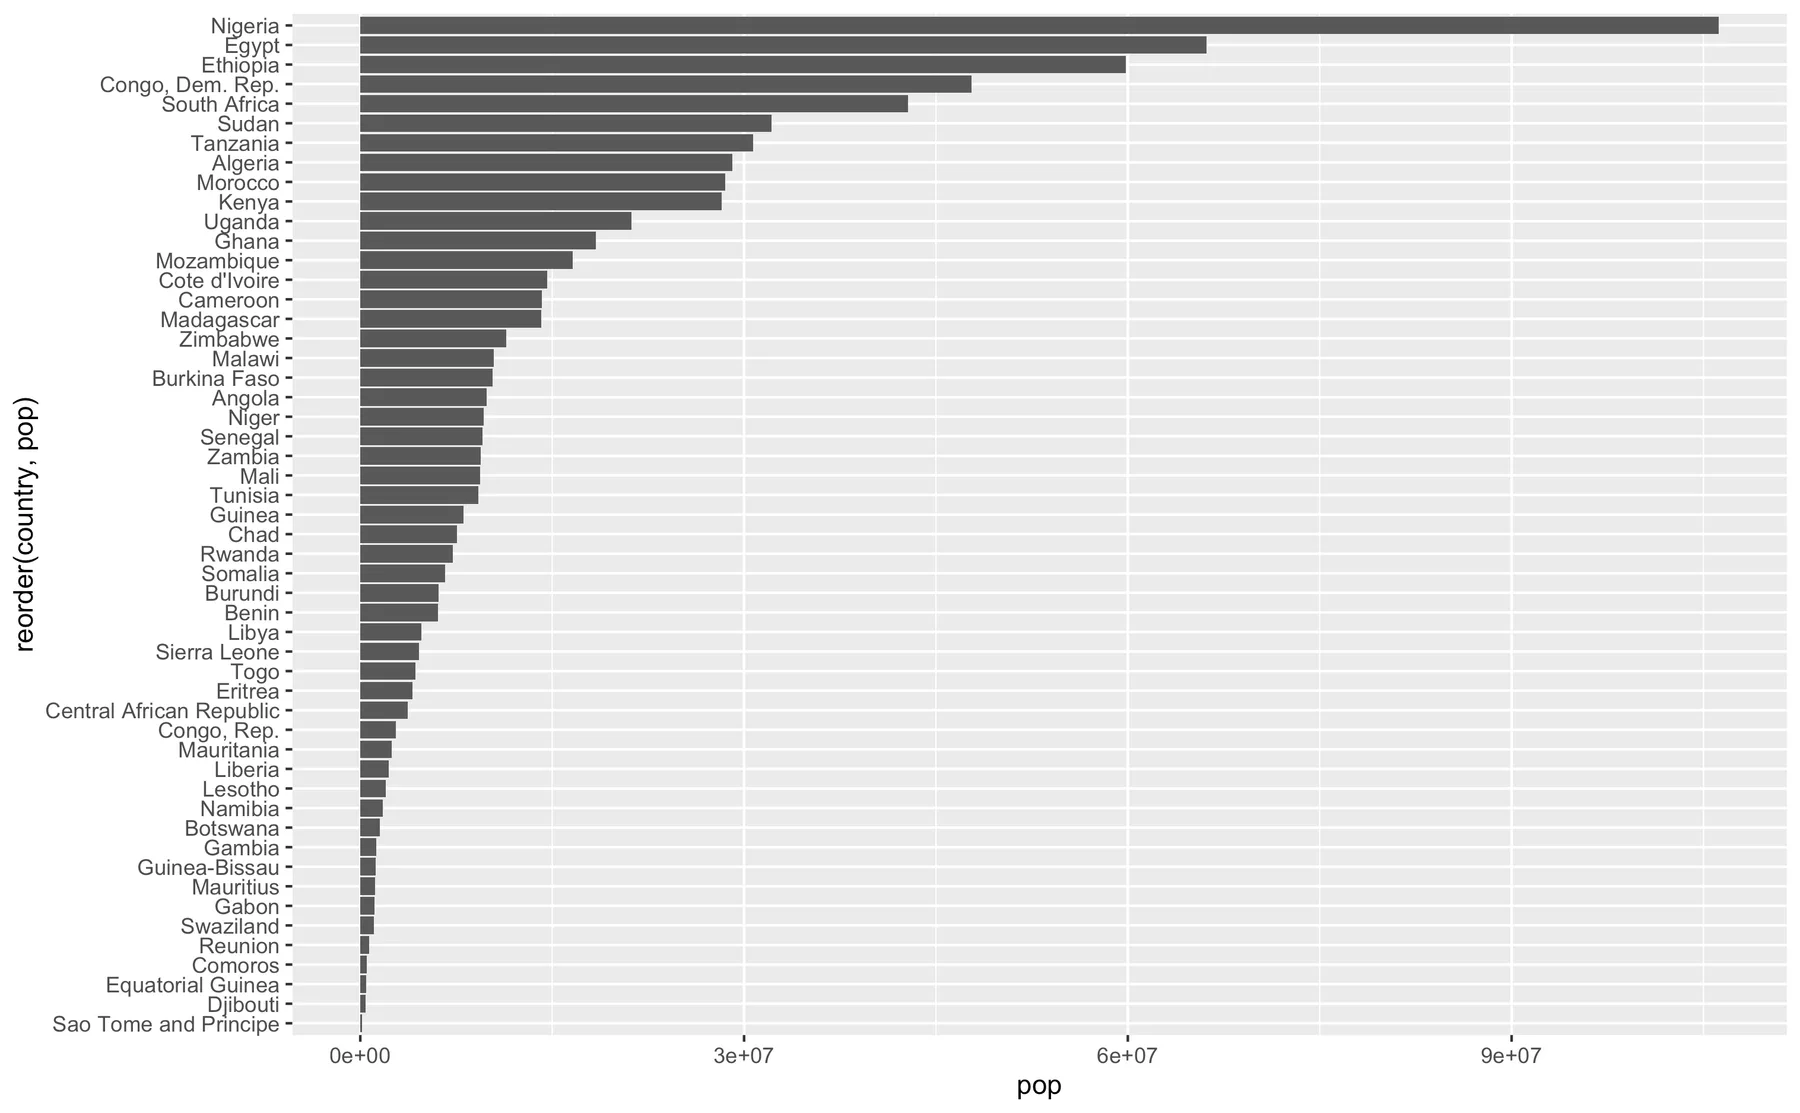
Et minustegn (-) foran pop i reorder() gir omvendt sortering, slik (se linje 4):
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, -pop),
               x=pop),
           stat="identity")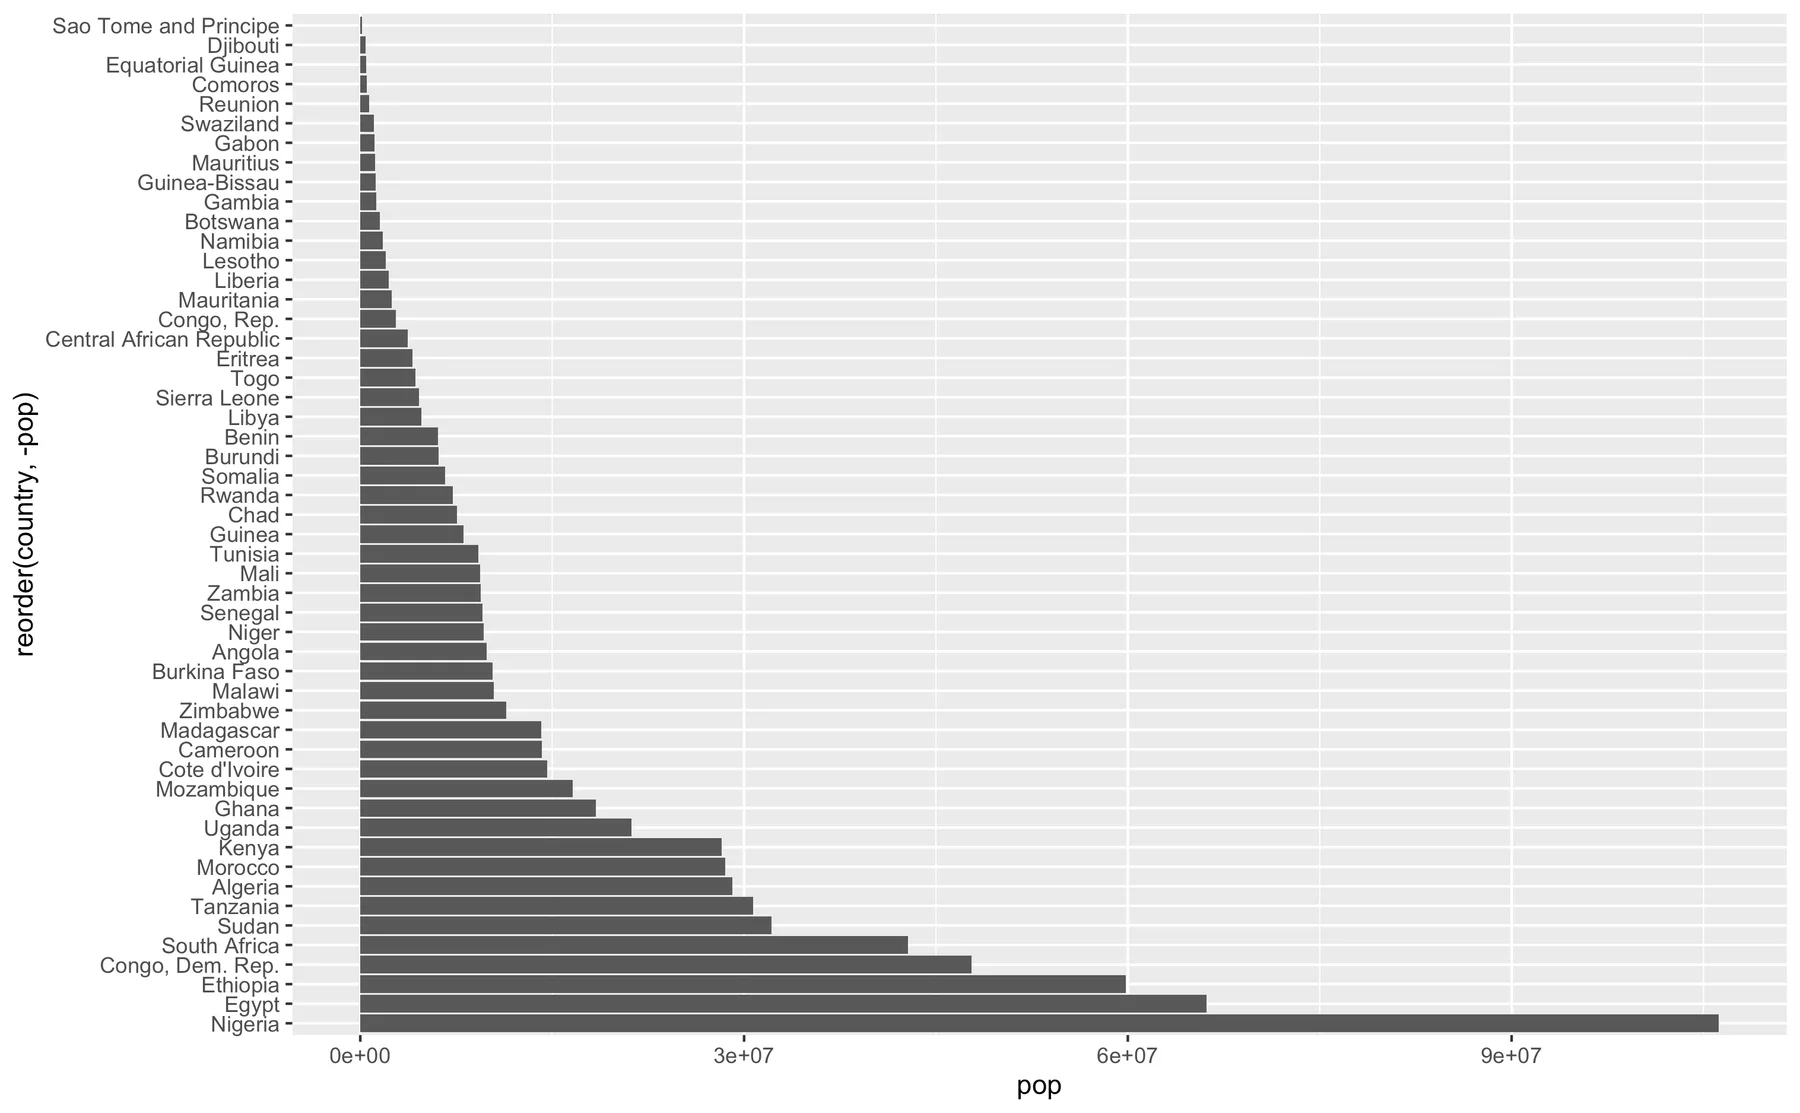
Vi trenger også å visualisere forventet levealder (lifeExp) for hvert land og kan gjøre det med argumentet fill(), slik (linje 6):
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, pop),
               x=pop,
               fill=lifeExp),
           stat="identity")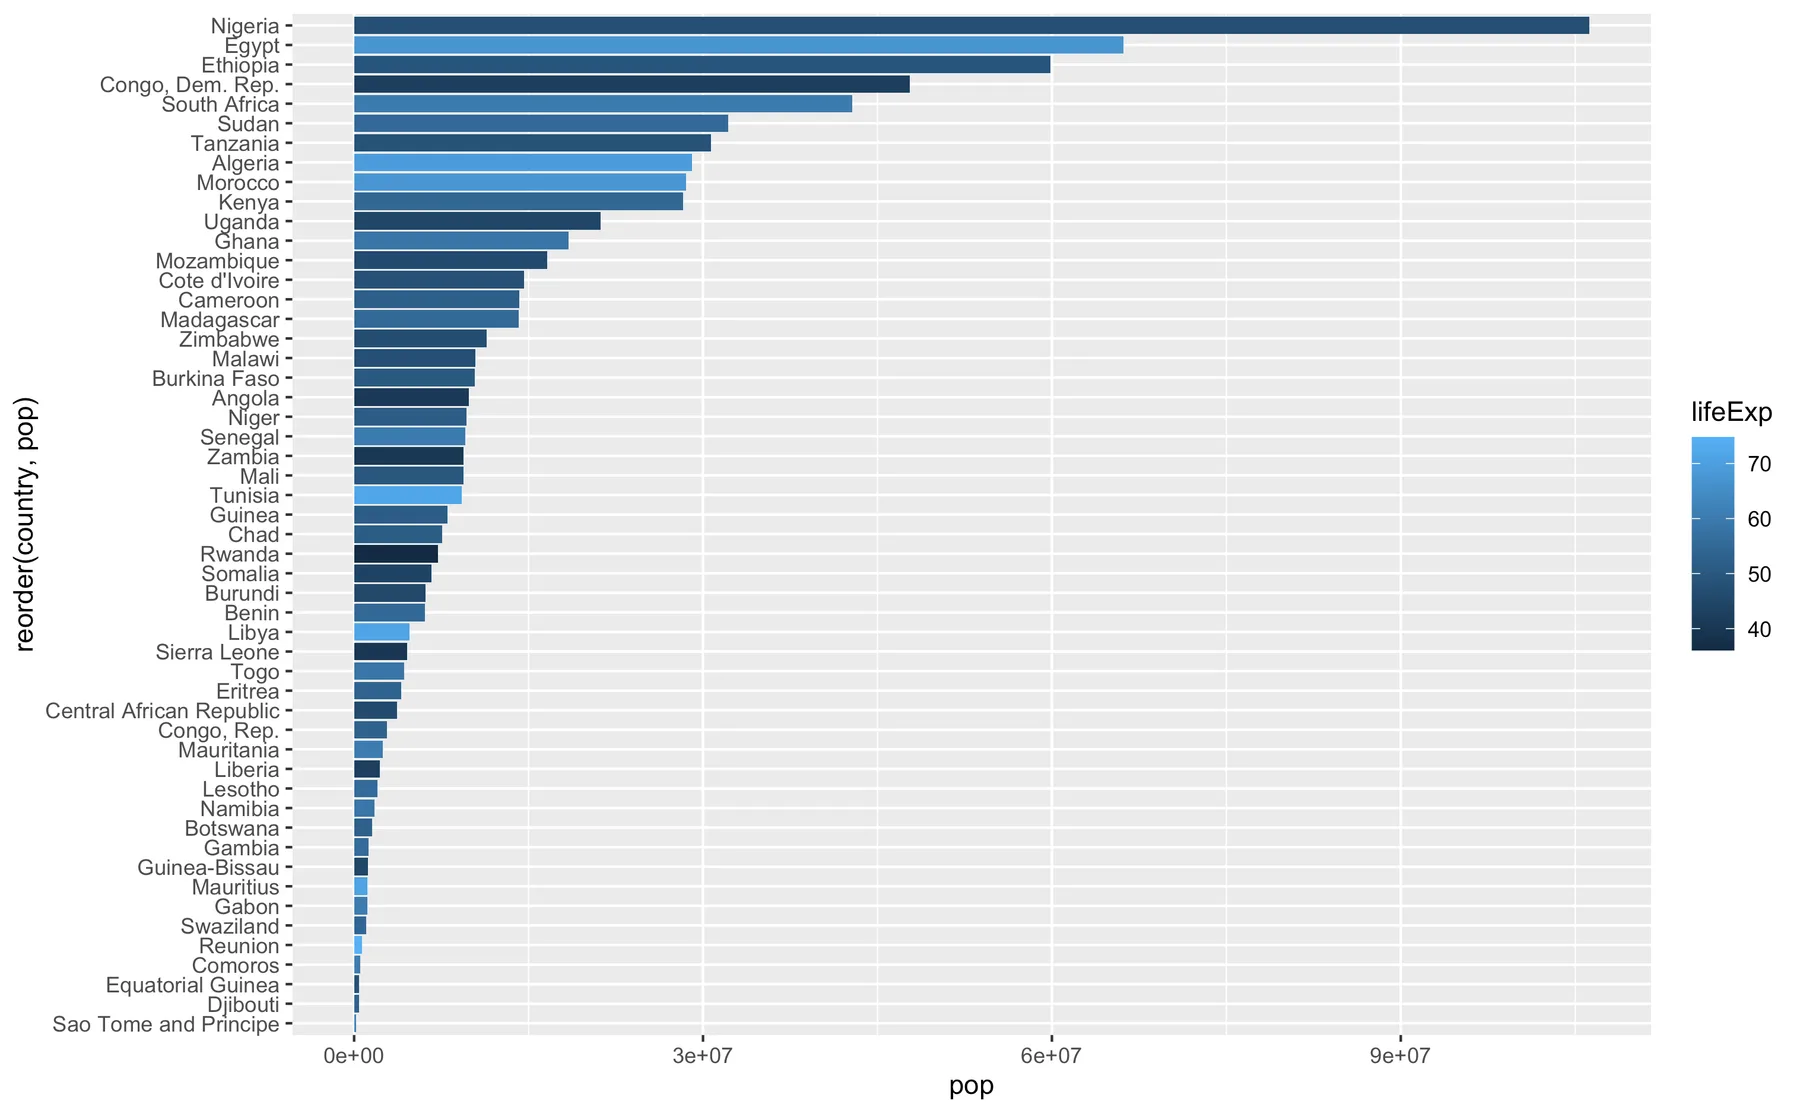
Proporsjoner
Med geom_bar() kan proporsjoner (prop) beregnes i stedet for antall (count). Dette gjøres med en "etterberegning" (after_stat) på y og ved å spesifisere group=1, som innebærer at den totale andelen i alle kontinenter skal være 1:
ggplot(data = gapminder) +
  geom_bar(mapping = aes(x = continent,
                         y = after_stat(prop),
                         group = 1))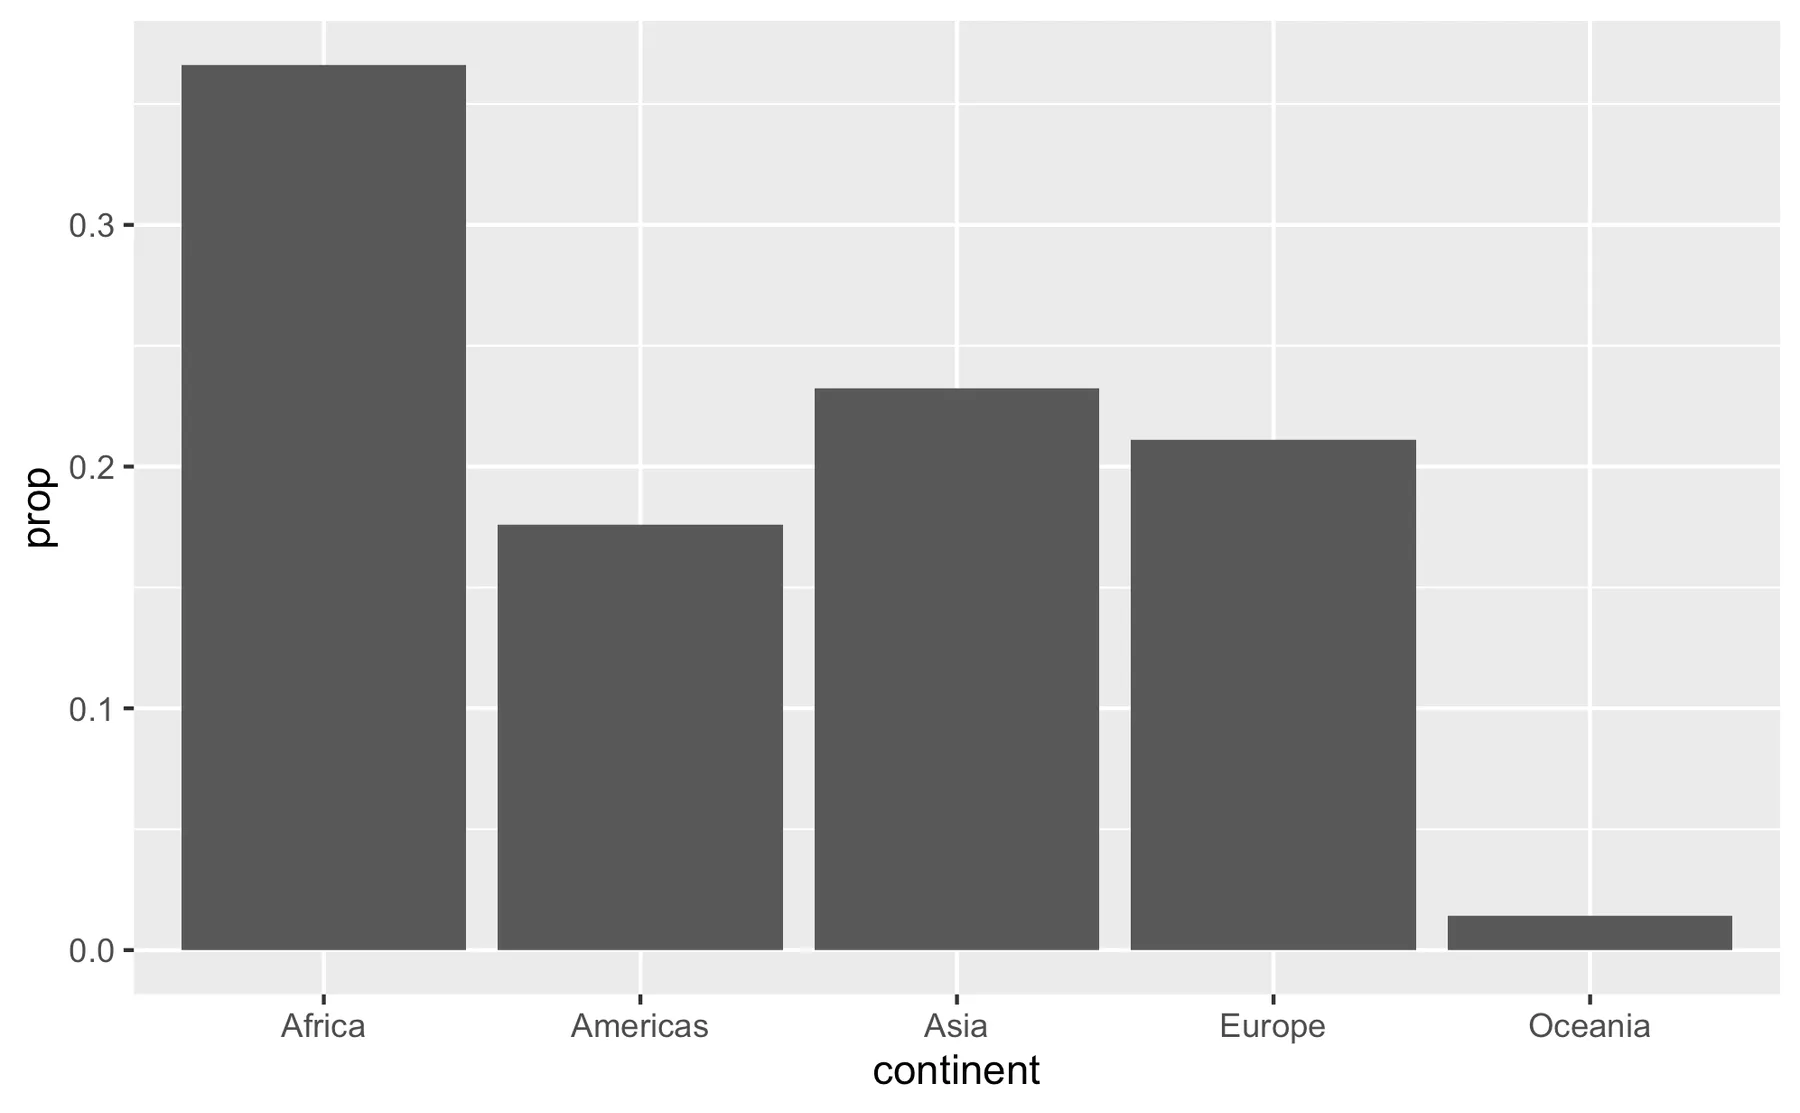
Stat summary: stat_summary()
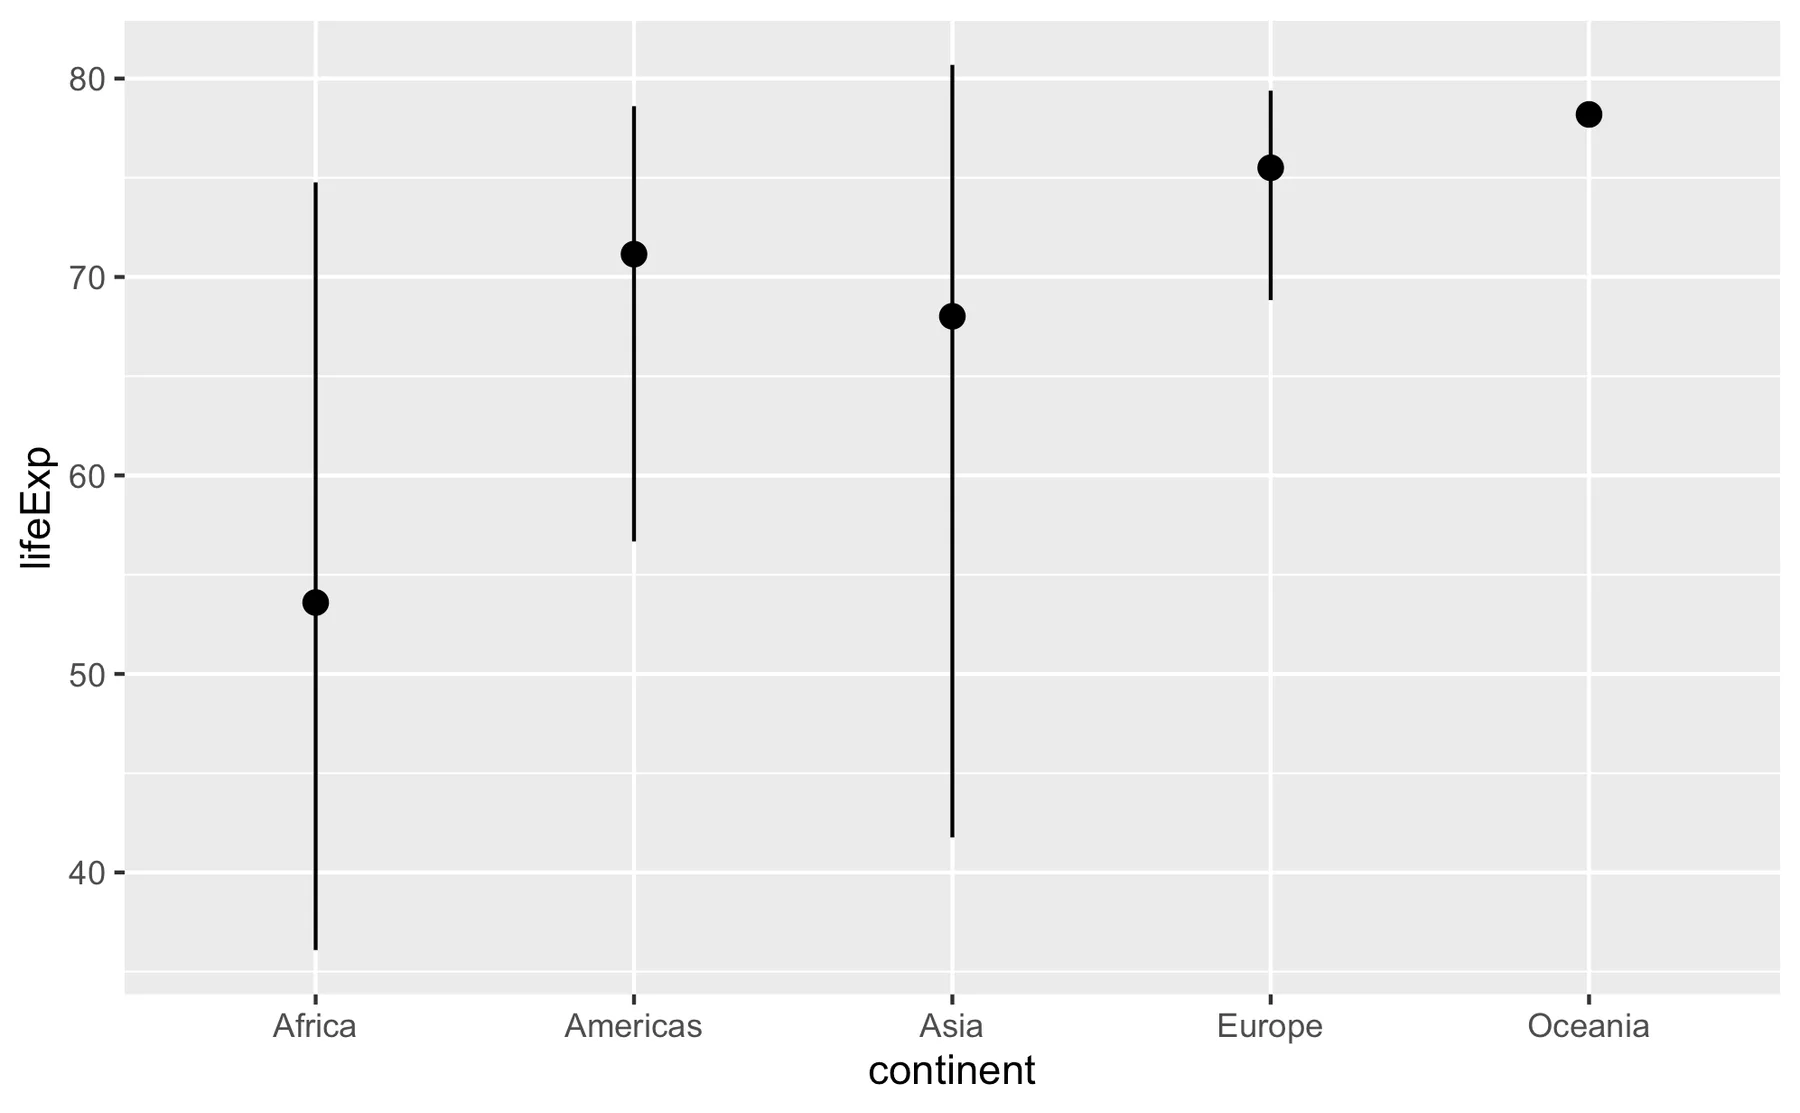
Vi kan også bruke stat_summary() for å velge hvilke parametere som skal beregnes og visualiseres. Med stat_summary() har vi større fleksibilitet når det gjelder beregningene. Vi spesifiserer selv hvilke funksjoner som skal brukes, og vi velger dessuten hvilken type geom som skal illustrere resultatet. Nedenfor bruker vi stat_summary() for å beregne gjennomsnitt, minste verdi og største verdi for forventet levealder på hvert kontinent, og dette visualiseres med geomet "pointrange" (geom_pointrange()):
## Vi bruker bare data fra 1997
ggplot(data = filter(gapminder, year==1997)) +
  stat_summary(
    aes(x = continent,
        y = lifeExp),
    fun = mean,
    fun.min = min,
    fun.max = max,
    geom = "pointrange"
  )
Segmenterte stolpediagrammer
Vi går tilbake til mpg-dataene for å illustrere flere funksjoner i geom_bar(). I neste eksempel bruker vi fill for å markere andeler av en stolpe. Vi vil markere andeler av kolonnen drv (bilens drivlinje) i hver stolpe. I koden nedenfor har vi også justert grafens tema med funksjonen theme() for å vinkle teksten på x-aksen 45° (temaer diskuteres i et senere kapittel).
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar() +
  # Gir teksten på x-aksen 45° helning
  theme(axis.text.x = element_text(angle=45))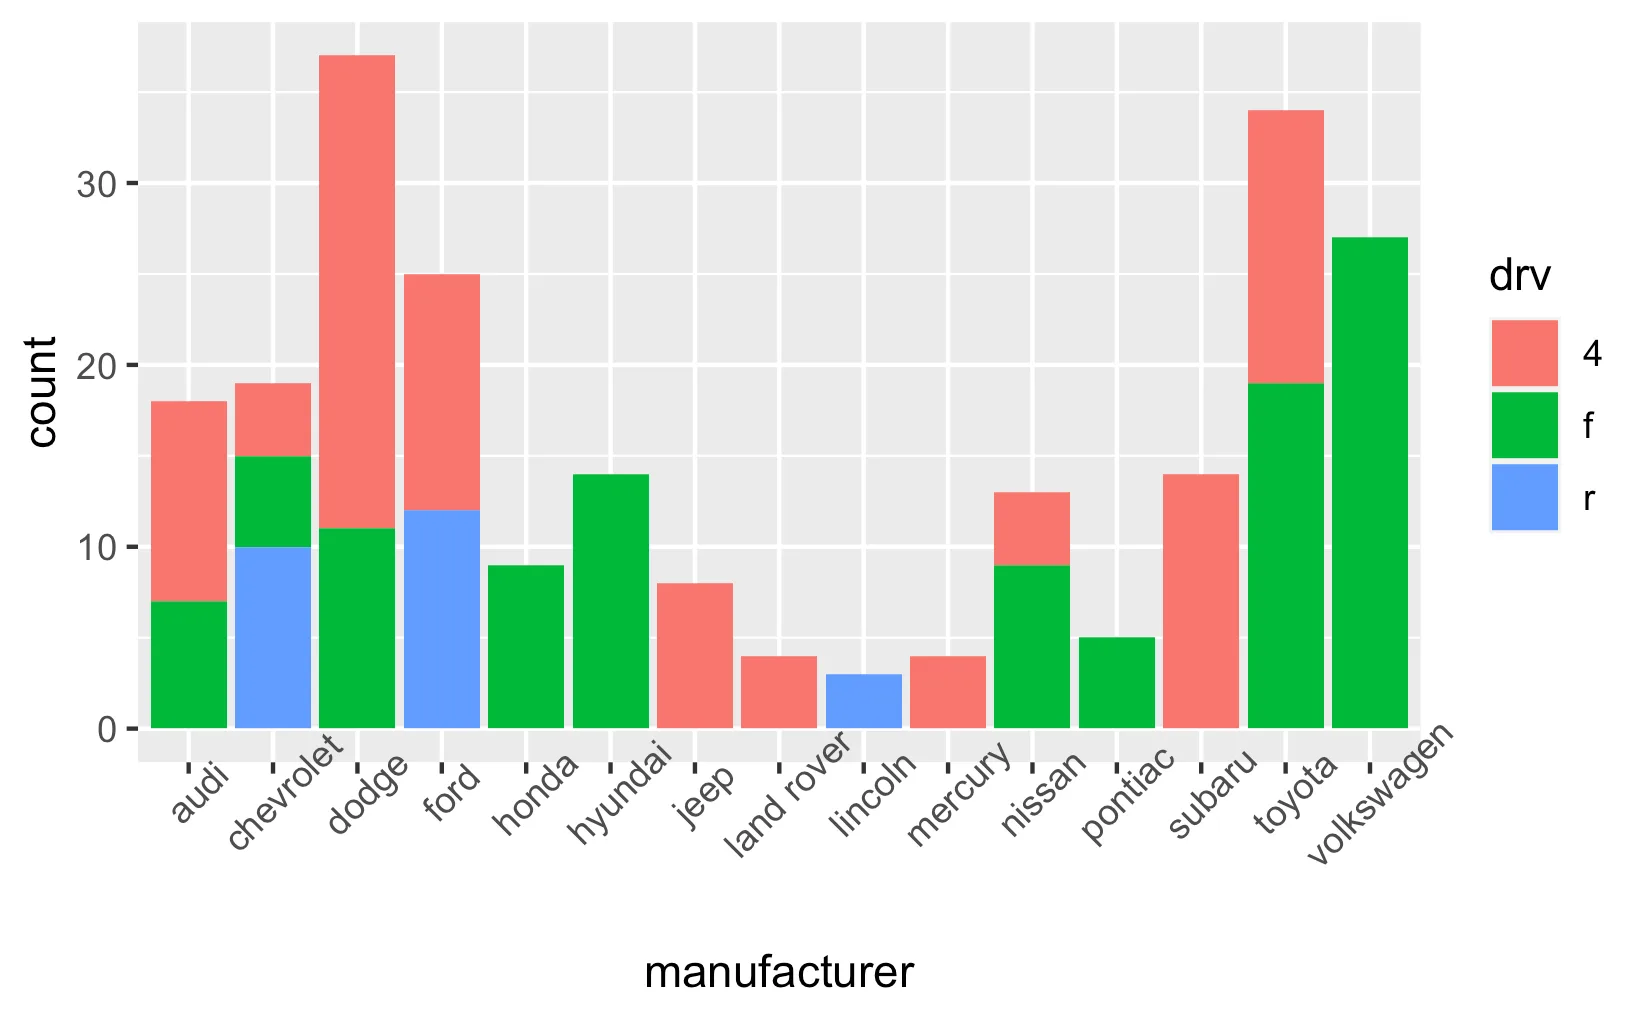
Det ser ut til at produsenten Volkswagen bare produserer biler med forhjulsdrift (f), mens Subaru bare produserer biler med firehjulsdrift. Land Rover produserer bare bakhjulsdrevne biler.
I eksemplet ovenfor skrev vi geom_gar() uten noen argumenter. Det innebærer at position fikk sin standardverdi, som er "identity". Det finnes også alternativene "dodge" og "fill", som gir følgende grafer:
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar(position="dodge") +
  theme(axis.text.x = element_text(angle=45))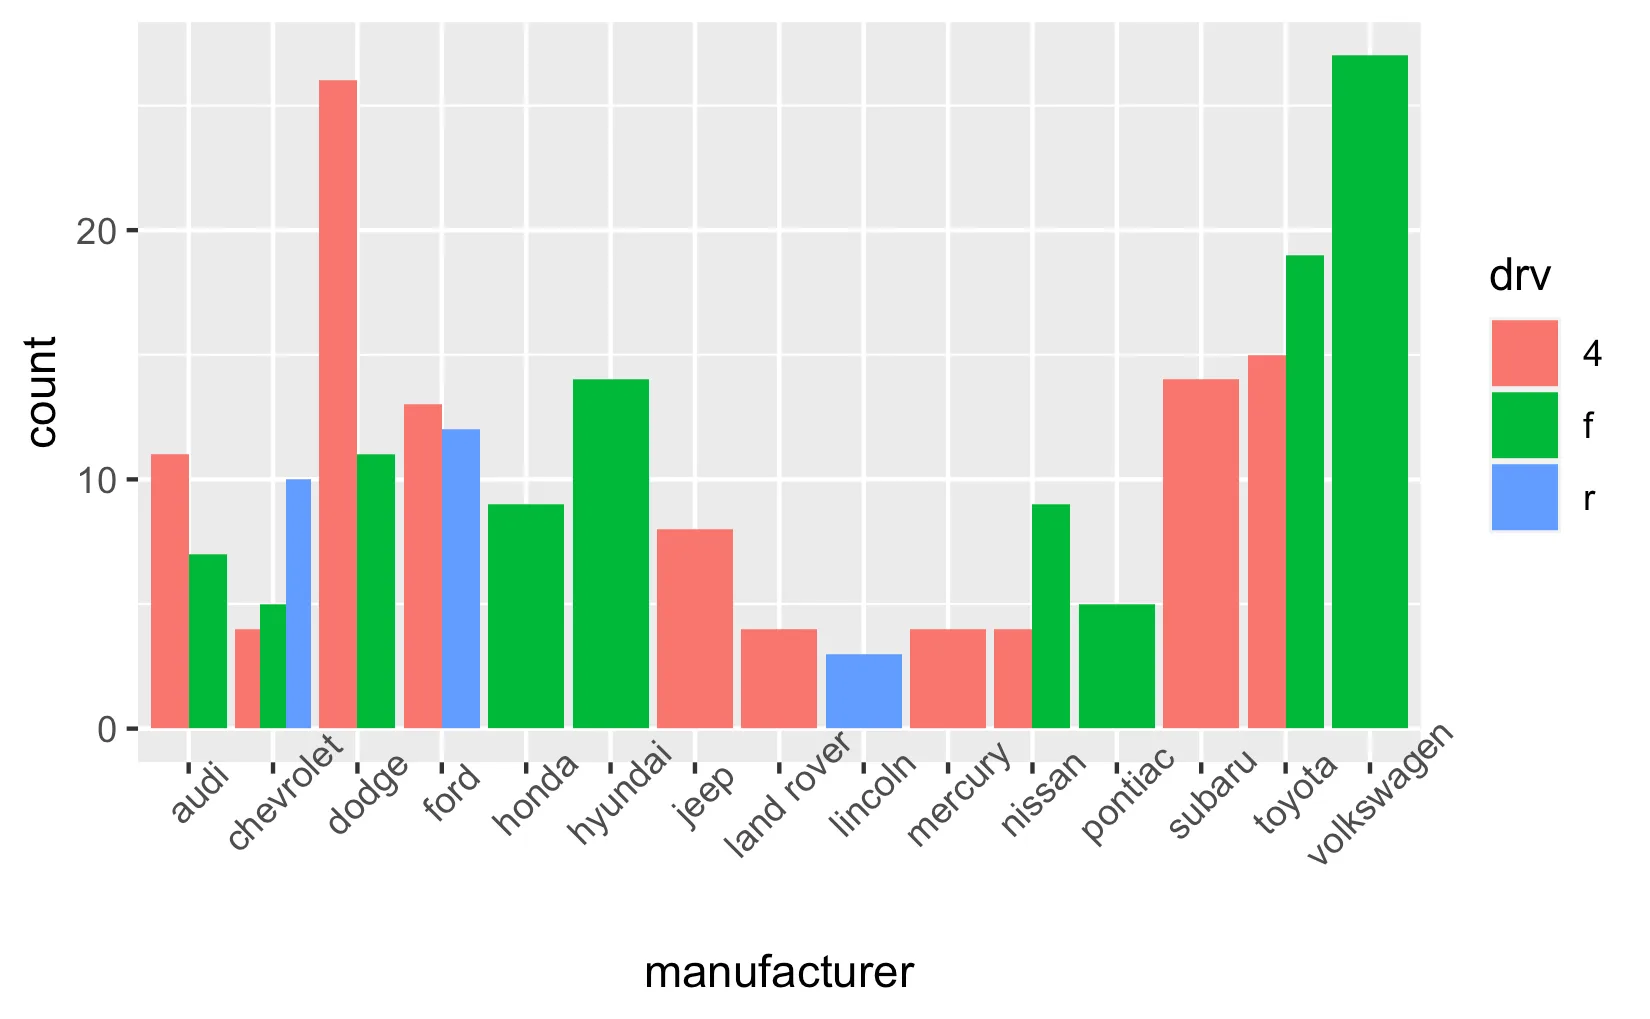
Som det fremgår ovenfor, fører position="dodge" til at segmentene plasseres ved siden av hverandre i stedet for å stables oppå hverandre. Vi fortsetter med position="fill":
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar(position="fill") +
  theme(axis.text.x = element_text(angle=45))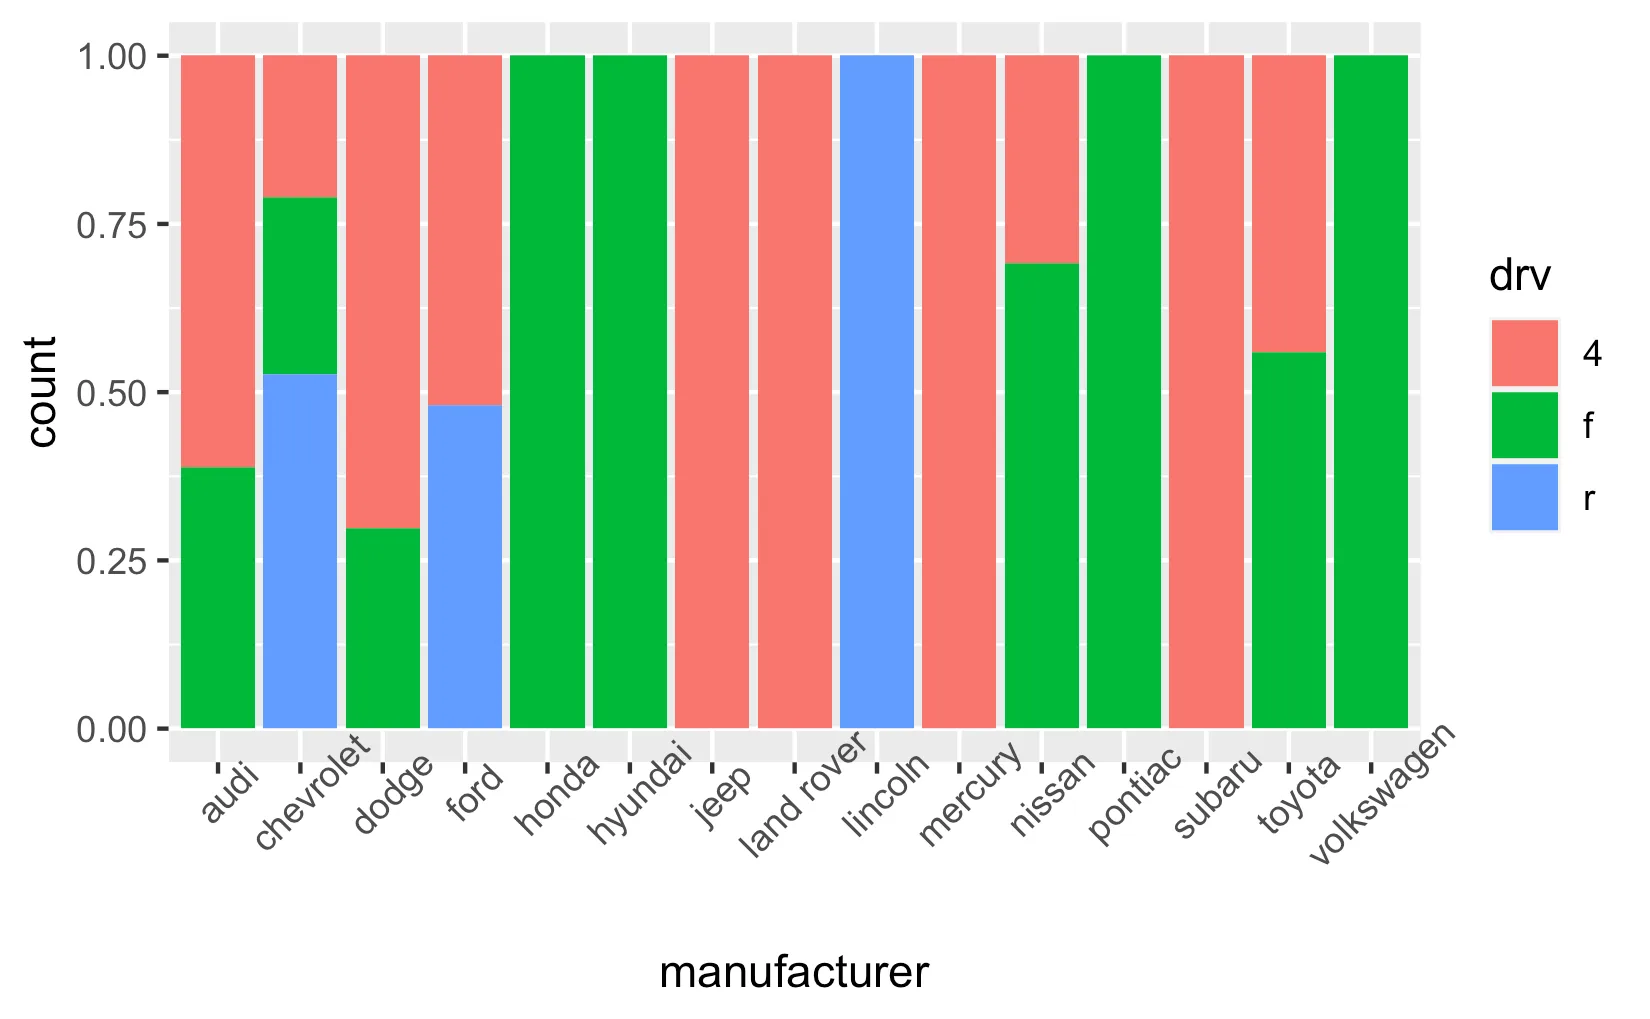
Som det fremgår ovenfor, fører position="fill" til at segmentene i hver stolpe presenteres som andeler (proporsjoner) i stedet for antall.