Learning i machine learning (maskinlæring)
Mennesket har en fantastisk evne til å skape enkle representasjoner av komplisert informasjon. Vi lærer gjennom sansene våre (syn, hørsel, smak osv.), som har en evne til å skape nyttige representasjoner av alle sanseinntrykkene. Hvis vi ser på et fotografi av en skog, kan vi umiddelbart avgjøre at det er en skog; vi trenger ikke analysere nøyaktig hvilken farge trærne har eller hvordan bladene ser ut. Hjernen vår henter ut fra bildet den informasjonen som trengs for å avgjøre om det er en skog eller ikke. På samme måte kan vi avgjøre om det finnes en sykkel på bildet. Hjernen vil lete etter to runde ting (hjulene) som sitter på en trekantformet struktur (sykkelrammen). Du vil lete etter de strukturene som er typiske for en sykkel: hjul, ramme, sete, styre. Disse komponentene er representasjoner av den større helheten: sykkelen.
Prinsippet for machine learning, og særlig deep learning, er nøyaktig det samme, nemlig å forsøke å finne representasjoner i data. I de aller fleste tilfeller bruker man treningsdata (se tidligere) der det finnes en ønsket klassifisering. Et eksempel følger:
Du vil lage programvare som kan skille hunder fra katter på bilder. Til denne oppgaven har du samlet inn 5000 bilder, hvorav omtrent halvparten er bilder av hunder. Alle bildene er vurdert/klassifisert (av et menneske) som «hund» eller «katt». Datamaskinen skal analysere alle bildene for å forsøke å finne representasjoner som er unike for henholdsvis hund og katt.
Fundamentet for kunstig intelligens, og dermed deep learning, er å finne gode representasjoner av data. For at en datamaskin skal kunne skape representasjoner, må den transformere (omforme) data. Formålet med transformasjonen er å destillere informasjonen, noe som innebærer at støy fjernes og verdifull informasjon fokuseres og forsterkes. Med deep learning transformeres data vanligvis i flere trinn, og for hver transformasjon forsøker datamaskinen å skape informative representasjoner av innholdet. Når tilstrekkelig mange transformasjoner er gjort, har datamaskinen lært hvilke representasjoner som er typiske for henholdsvis katt og hund.
En god representasjon kjennetegnes av to ting: (1) den inneholder verdifull informasjon, og (2) den kan gjenskapes. På bildet med sykkelen er de runde strukturene (hjulene) svært informative, og det er viktig å finne disse. Videre er det viktig å finne hjulene hver gang de finnes på bildet, uavhengig av sykkelens omgivelser, farger og hvor på bildet sykkelen er plassert.
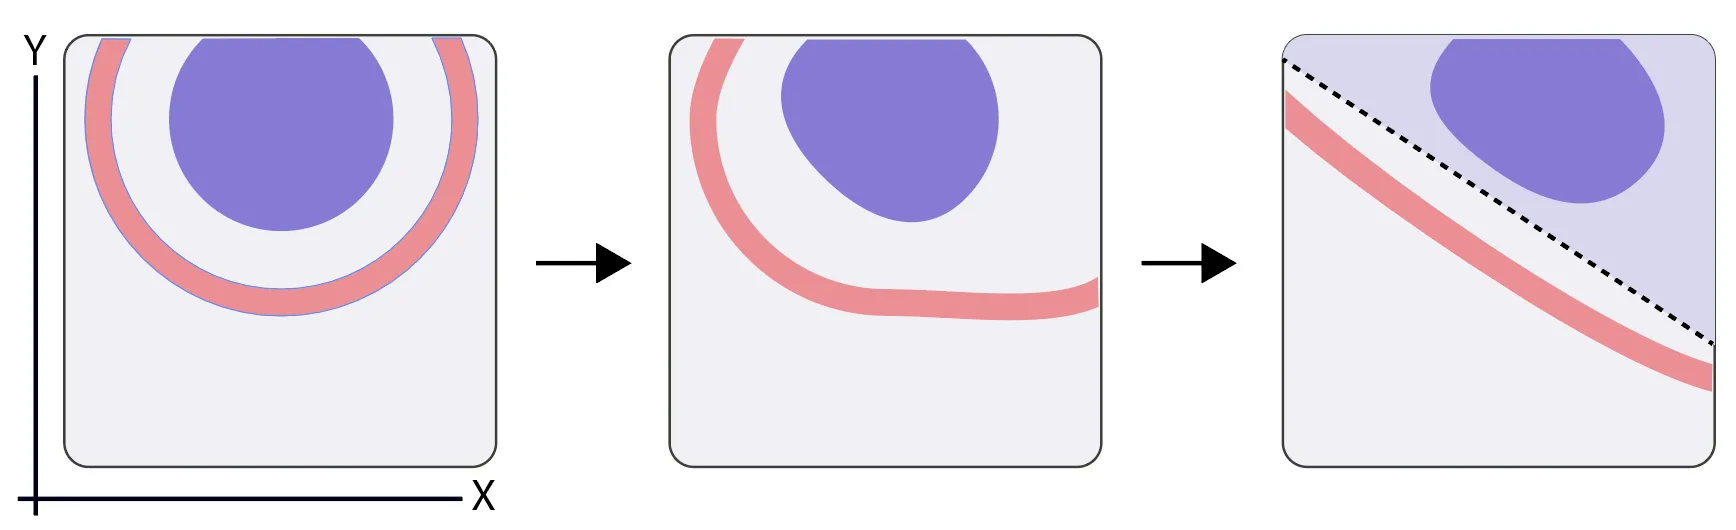
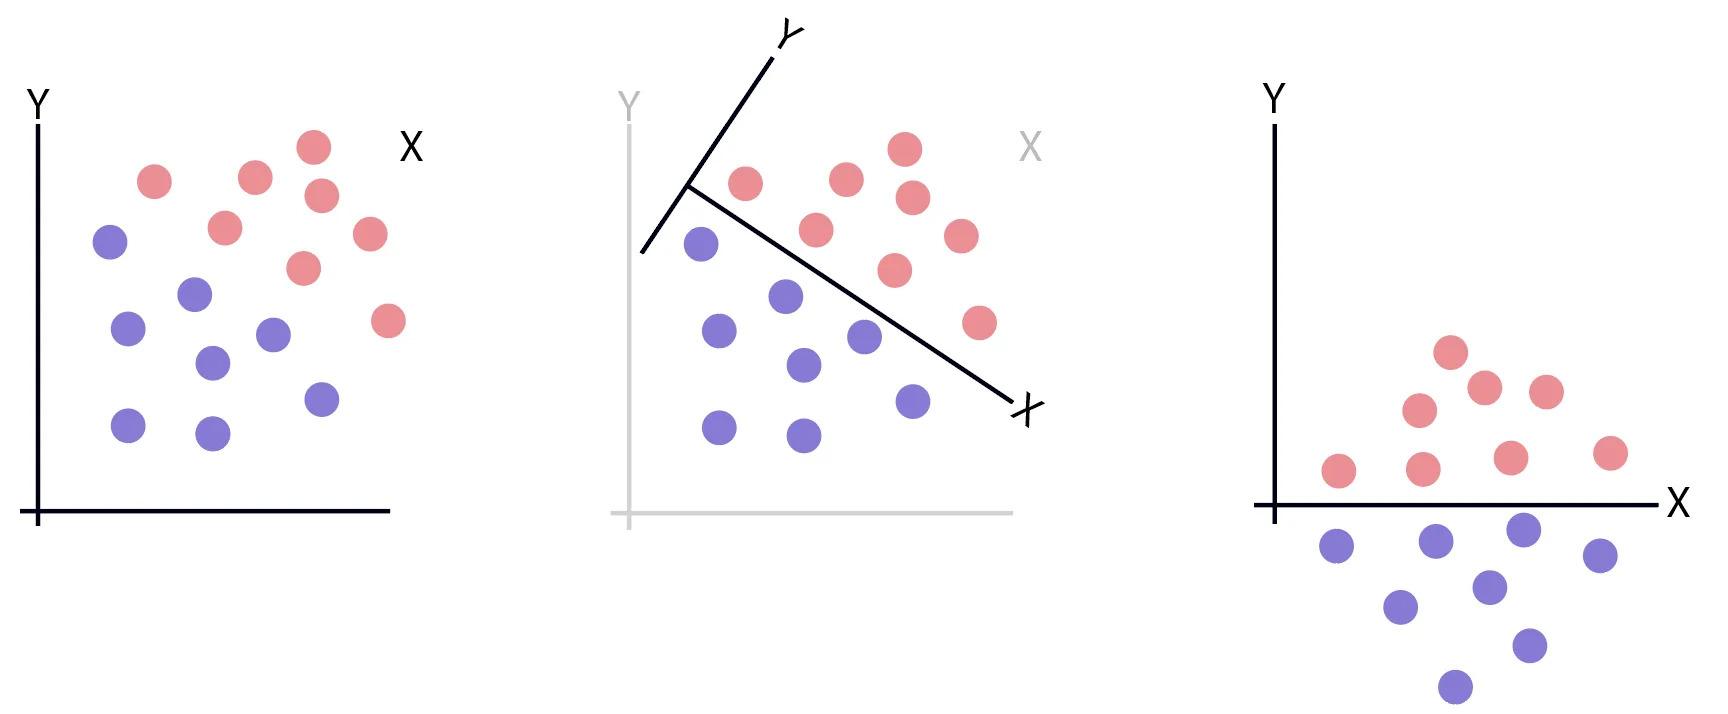
Med machine learning kan man finne representasjoner automatisk. Ved hjelp av ulike algoritmer leter man etter nyttige transformasjoner. Representasjonene finnes ved hjelp av temmelig primitive matematiske operasjoner. Disse operasjonene kan for eksempel innebære at maskinen filtrerer bort alle verdier som er større enn X, eller endrer alle koordinater på en bestemt måte (eksempel følger i figur 1 og 2). Selv om transformasjonene er enkle, viser det seg at de kan bli ekstremt effektive dersom maskinen får riktig tilbakekobling (feedback). Faktisk kan transformasjonene, dersom maskinen får riktig tilbakekobling på dem, brukes til å løse svært komplekse oppgaver, som å oversette tekst, kjøre biler, tolke bilder osv.
Tilbakekobling (feedback)
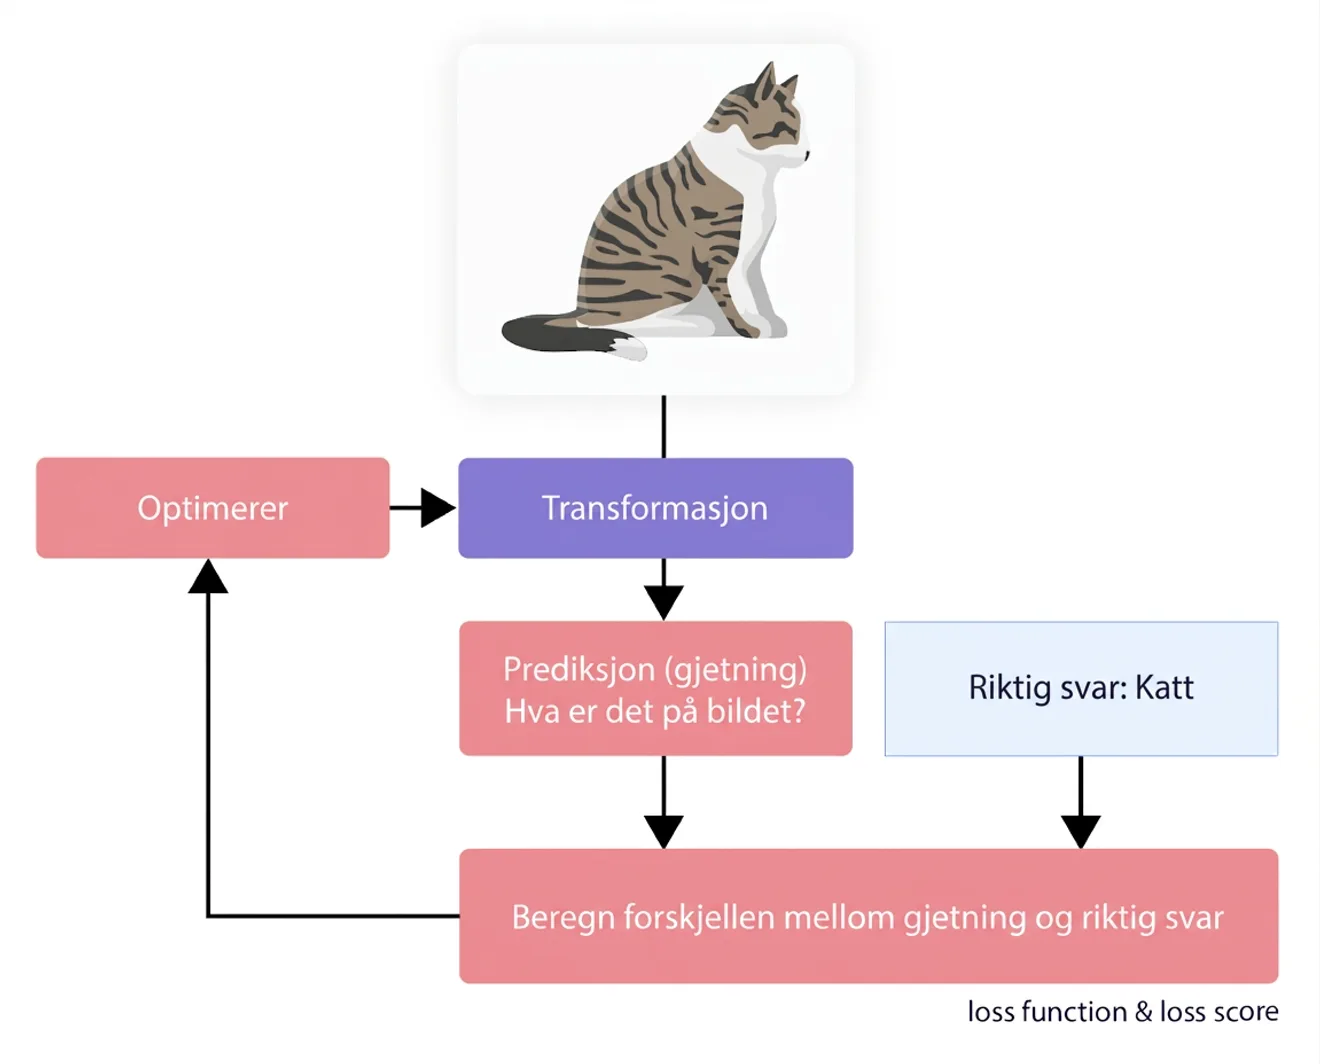
La oss si at vi har 5000 bilder av hunder og katter. Målet vårt er å lage et program som kan avgjøre om det er en hund eller en katt på bildet. Til hjelp har vi en machine learning-algoritme som kan finne nye representasjoner i data. Maskinen transformerer data og forsøker å finne representasjoner som er typiske for henholdsvis katter og hunder. Maskinen tester disse representasjonene ved å forsøke å gjette hvilket dyr bildet viser. Siden maskinen har fasit (riktig svar), kan den vurdere om gjetningen var god eller dårlig. Dette er et avgjørende trinn i all machine learning. Maskinen lærer nemlig ved å evaluere hvor gode gjetningene dens er, og forskjellen mellom maskinens gjetning og riktig svar beregnes med en såkalt tapsfunksjon (eng. loss function). Forskjellen mellom gjetningen og riktig svar beregnes som loss score. Maskinen kobler loss score tilbake til en såkalt optimerer, som kan justere transformasjonen, og formålet med justeringen er å oppnå en transformasjon som reduserer loss score. Jo mindre loss score er, desto nærmere er gjetningen det riktige svaret. På den måten kan machine learning styres mot å finne representasjoner som kan fastslå hva som finnes på bildet.