
Introduksjon til Machine Learning (Maskinlæring)
For flere tiår siden begynte man å utvikle matematiske funksjoner som fungerer som generelle læringsprosedyrer. I denne sammenhengen betyr læringsprosedyre ganske enkelt en prosedyre som gjør det mulig for datamaskinen å lære mønstre i data. Generell betyr at prosedyren kan brukes i mange ulike sammenhenger, for eksempel til å analysere besøkende på en nettside, studere kreftpasienter, vurdere aksjer på børsen eller været den kommende uken. Disse metodene går under betegnelsen maskinlæring (eng. machine learning), noe som indikerer at det er en datamaskin (maskinen) som lærer.
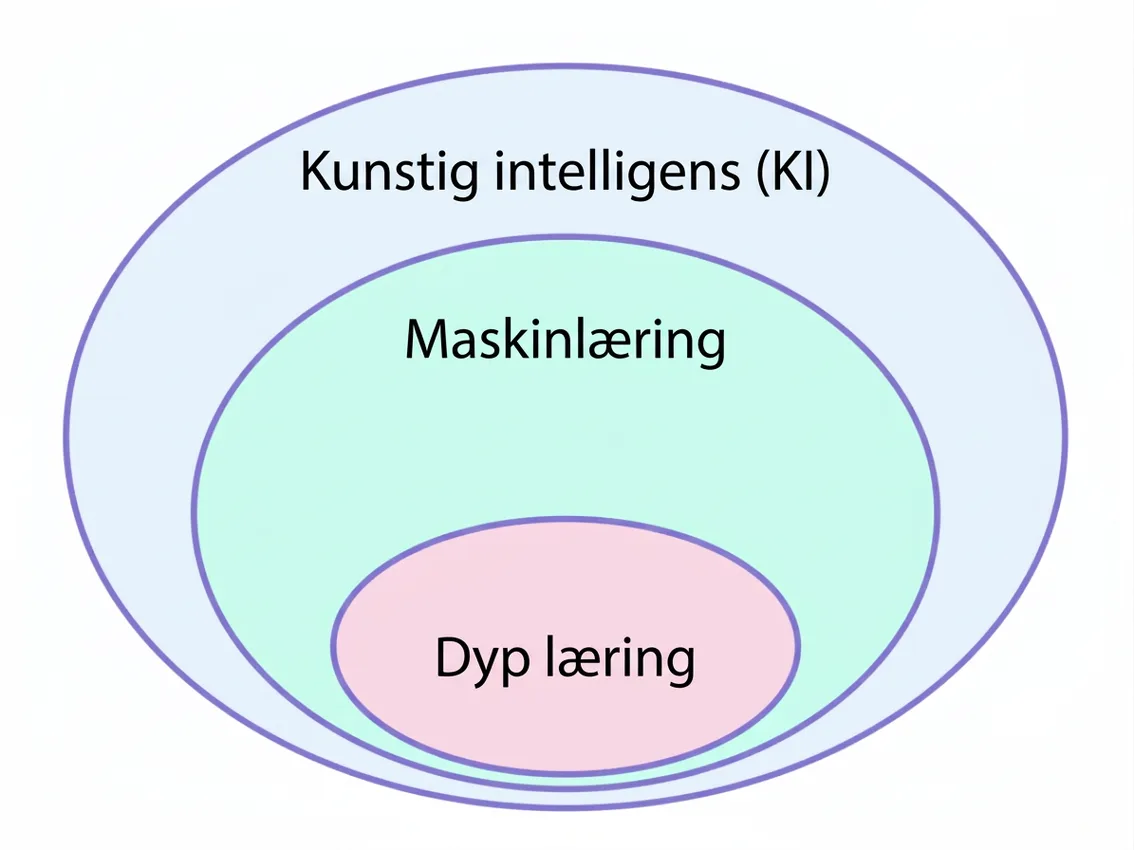
Prinsippet for machine learning (maskinlæring)
Prinsippet for machine learning er enkelt. Datamaskinen lærer ved å finne mønstre i data, og ut fra dette lages det regler. Disse reglene kan deretter brukes til å vurdere nye data som algoritmen ennå ikke har sett. For å illustrere dette tar vi et eksempel med elever i videregående skole. Tenk deg at vi har data om 1000 elever. Dataene omfatter elevens kjønn, foreldrenes inntekt, elevens oppmøte på skolen, prøveresultater første år og sluttkarakter siste år (Tabell 1). Vi kan bruke machine learning til å studere hvordan kjønn, foreldres inntekt, oppmøte og prøveresultater første år påvirker sluttkarakteren siste år. Maskinen vil studere elevene for å finne mønstre som avslører hvilke faktorer som påvirker sluttkarakteren, og hvordan de påvirker den. Sannsynligvis vil datamaskinen oppdage at elever med høyt oppmøte og gode prøveresultater første år også vil ha høye sluttkarakterer siste år. Disse oppdagelsene gjøres om til regler som deretter kan brukes til å forutsi hvordan nye elever kommer til å prestere på skolen. Reglene kan altså brukes til å forutsi nye elevers sluttkarakter allerede etter første år.
| TABELL 1 | Kjønn | Foreldres inntekt | Skoleoppmøte | Eksamensresultat år 1 | Sluttkarakter |
|---|---|---|---|---|---|
| Martin | Mann | 670000 | 75 % | C | C |
| Johanna | Kvinne | 950000 | 69 % | B | B |
| Mohammed | Mann | 531000 | 83 % | A | A |
| Luciano | Mann | 370000 | 100 % | C | B |
For å forstå maskinlæring bruker vi enda et eksempel. Tenk deg at vi driver en nettbutikk der vi selger klær. Målet vårt er at så mange besøkende som mulig skal kjøpe klær. Dessverre er det vanlig at de besøkende ikke fullfører kjøpene sine (de forlater nettbutikken før kjøpet er fullført). Vi kan bruke maskinlæring til å beregne sannsynligheten for at en besøkende vil forlate butikken før kjøpet er fullført. Vi ønsker nemlig å vise en rabattkode til besøkende som vi beregner har høy sannsynlighet for å avbryte kjøpet. Hensikten med å gi dem en rabattkode er å øke tilbøyeligheten deres til å fullføre kjøpet. Utfordringen ligger i å gi rabattkupongen til riktig besøkende (vi vil ikke dele ut rabattkuponger til besøkende som uansett kommer til å gjennomføre et kjøp). For å løse oppgaven har vi eksempeldata fra våre tidligere besøkende. For hver besøkende har vi opplysninger om vedkommendes alder, kjønn, adresse, tidligere innkjøp, tid på døgnet, dato, produkter som er lagt i handlekurven, sider vedkommende har besøkt, hvor lang tid vedkommende har brukt på hver side og så videre. Vi vet også om den besøkende gjennomførte kjøpet eller forlot butikken. Vi kan bruke maskinlæring til å finne mønstre som skiller personer som gjennomfører kjøp, fra dem som ikke gjennomfører kjøp. Den generelle læringsprosedyren vil finne disse mønstrene, og ut fra dem lages det regler. Disse reglene utgjør dermed en algoritme som deretter kan brukes på nye besøkende for å beregne hvor stor sannsynligheten er for at de vil forlate siden før kjøpet er gjennomført. Vi kan bruke disse sannsynlighetene til å avgjøre hvilke besøkende som skal få en rabattkode og forhåpentligvis fullføre kjøpet sitt.
I begge eksemplene ovenfor bruker datamaskinen en generell læringsprosedyre for å finne mønstre i data. Disse mønstrene brukes til å lage regler. Fordi reglene lages ut fra mønstre i data, sier man at metoden er datadrevet (eng. datadriven methods).
Å predikere (forutsi) for å overleve
En prediksjon er en forutsigelse. Å kunne forutsi fremtiden er ekstremt ettertraktet. Tenk deg at du hadde kunnet forutsi hvilke aksjer som kommer til å stige i verdi, eller hvilke sykdommer du kommer til å bli rammet av i løpet av livet. I løpet av de siste årene har alle virksomheter (bedrifter, forskere, organisasjoner, regjeringer osv.) blitt stadig mer interessert i å kunne predikere. Faktisk kan hele virksomhetens overlevelse avhenge av at man kan predikere, og at man gjør det med høy presisjon.
Fordi nesten alt kan predikeres, har prediksjonsanalyse fått en sentral plass i alle virksomheter. For en bilprodusent er det for eksempel rimelig å predikere hvor mange biler den forventes å selge neste år (dette påvirker produksjonsplanleggingen), prisutviklingen på bensin/diesel/strøm (dette påvirker hvordan motorene skal konstrueres), risikoen for at prisen på råvarer og komponenter skal stige (dette påvirker prisingen av bilene) og så videre. Alle virksomheter må i dag lære seg å predikere.
Det er følgende tre faktorer som har ført til den store interessen for prediksjonsanalyse:
- De fleste virksomheter samler inn store mengder data, som utgjør grunnlaget for all prediksjon. Dette er grunnen til at man i dag sier at data er verdifulle.
- Programvare og maskinvare for prediksjonsanalyse er tilgjengelig for alle.
- Evnen til å analysere data har spredt seg i samfunnet. For 10 år siden var det nesten bare matematikere og statistikere som analyserte data. I dag kan hvem som helst lære seg å analysere data.
Å kunne forutsi fremtiden er maskinlæringens hovedoppgave. Maskinlæring brukes altså til å predikere. I det tidligere eksemplet brukte vi maskinlæring til å predikere skoleelevers sluttkarakter. Det finnes andre metoder enn machine learning for å predikere, men de senere årene har det vist seg at presisjonen i prediksjonene som regel er høyest med machine learning, uansett hvilken type data man analyserer.