
Dyp læring (deep learning)
Deep learning er en type maskinlæring (machine learning). Når man snakker om kunstig intelligens, mener man oftest ulike anvendelser av deep learning. Prinsippet for deep learning er svært enkelt. Med deep learning skapes representasjoner i flere trinn. Disse trinnene kalles lag (eng. layer), og formålet er å skape bedre representasjoner for hvert lag. Det er ikke uvanlig å bruke flere hundre lag.
I deep learning er disse lagene organisert i nevrale nettverk (eng. neural networks). Betegnelsen er hentet fra menneskets hjerneceller (nevroner). Nevrale nettverk i deep learning er inspirert av hjernens nevroner. Dette betyr likevel ikke at nevrale nettverk fungerer som hjernecellene. Det finnes faktisk svært få likheter mellom deep learning og hjernecellenes måte å lære på. Den populærvitenskapelige beskrivelsen av deep learning som en digital versjon av hjernen er altså feil. Nevrale nettverk med mange lag kalles deep neural networks (DNN), eller mer generelt deep learning.
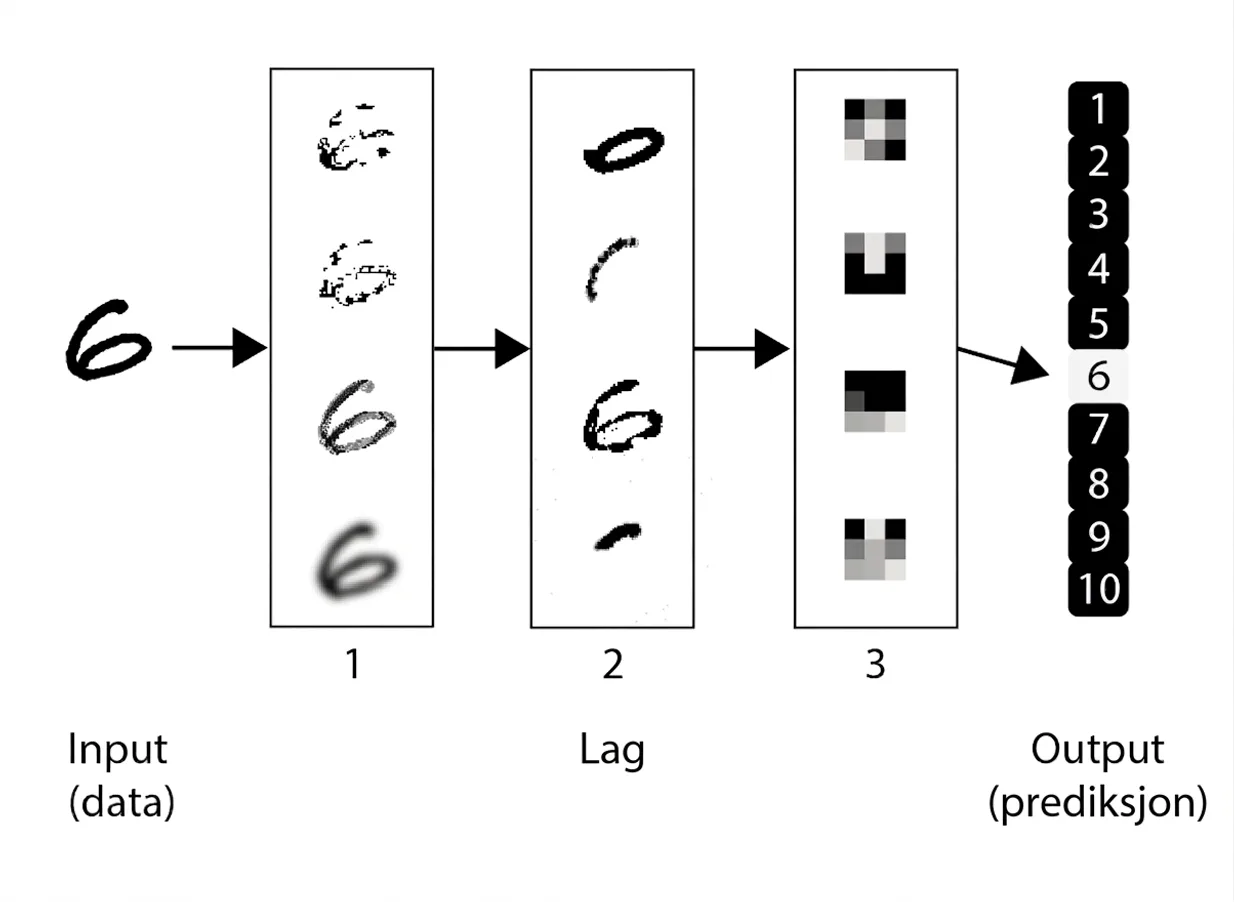
Det nevrale nettverkets oppgave er å transformere input (data som mates inn) til representasjoner som blir stadig mer annerledes (sammenlignet med input), men samtidig mer informative. Nettverket destillerer og filtrerer informasjonen slik at bare de nyttige og karakteristiske trekkene står igjen i det siste laget. I det siste laget er informasjonen kondensert i så stor grad at nettverket, ut fra aktiveringen i laget, kan avgjøre hvilket siffer det er.
Hva skjer i et lag?
Hvert lag skal ta imot informasjon (tall) fra det foregående laget og behandle disse tallene før de sendes videre til neste lag. Etter hvert som informasjonen strømmer gjennom lagene, trekkes nyttige representasjoner ut.
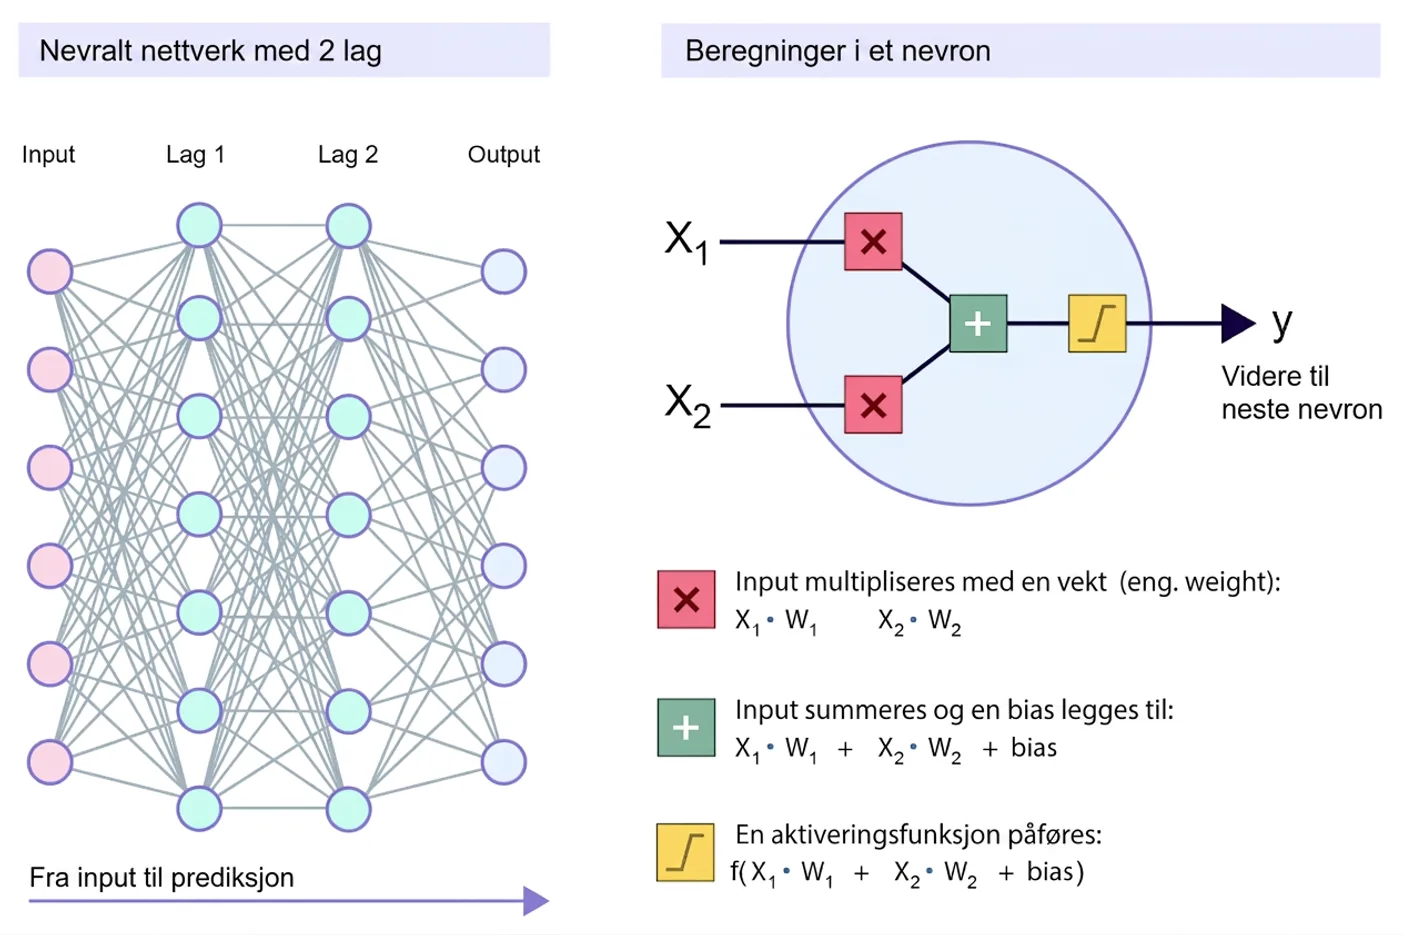
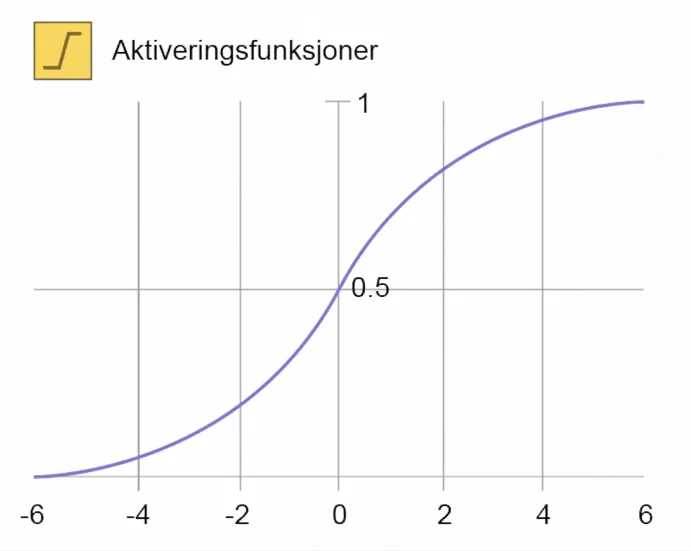
I hvert lag er det nevroner (synonym: noder) som tar imot, behandler og sender videre informasjon. I figuren over tar nevronet imot x1 og x2, utfører beregninger og sender deretter videre verdien y. I nevronet multipliseres hvert input (innkommende tall) med en vekt. Deretter summeres alle input, og en bias legges til. Resultatet passerer så en aktiveringsfunksjon. Formålet med aktiveringsfunksjonen er å omdanne sluttresultatet til et tall som er lett å håndtere. I eksemplet over er aktiveringsfunksjonen en sigmoid funksjon. Denne funksjonen omdanner alle innkommende verdier til et tall mellom 0 og 1. Store positive tall nærmer seg 1, og store negative tall nærmer seg 0.
Vektene er avgjørende for det nevrale nettverket. Med riktige vekter vil nettverket fungere godt og dermed klare oppgaven det er utviklet for. Utfordringen ligger i å finne de riktige vektene. Siden nettverket kan inneholde millioner av vekter, blir dette en svært vanskelig utfordring. Det blir enda vanskeligere når vi konstaterer at justering av en enkelt vekt kan påvirke hele nettverket. Den store utfordringen er altså å justere alle disse vektene slik at de blir optimale for formålet.
Vektene justeres ved hjelp av en loss-funksjon (diskutert over). Loss-funksjonen beregner rett og slett hvor stor forskjellen er mellom nettverkets nåværende gjetning og sannheten. Denne forskjellen kalles loss score. Hvis loss score er stor, er forskjellen mellom gjetningen og sannheten stor, noe som er dårlig. Hvis loss score er liten, har nettverket gjort en god gjetning. Loss score fungerer som et tilbakekoblingssignal (feedback signal) som brukes til å justere vektenes verdi. Det betyr at nettverket evaluerer sin egen evne, kobler resultatet tilbake til seg selv og deretter justerer vektene for å forbedre evnen sin. Vektene justeres så i den retningen som gjør at loss score blir mindre.
Hvert nevralt nettverk har en optimerer (eng. optimizer). Det er optimererens oppgave å håndtere tilbakekoblingen og justere vektene i nettverket. Optimereren bruker en algoritme som kalles backpropagation algorithm.
Når nettverket aktiveres første gang, er verdiene på alle vektene helt tilfeldige. Dette fører til at nettverkets gjetning blir dårlig (loss score blir stor) i første runde. Men for hvert eksempel nettverket trener på, justerer det vektene i riktig retning, og dermed forbedres evnen gradvis. Hvis nettverket får trene på tusenvis, eller til og med hundretusenvis, av eksempler, minimeres til slutt loss-funksjonen, noe som betyr at nettverket har maksimert evnen sin.
Denne enkle mekanismen (som innebærer at hvert nevron tar imot input, gjør en enkel transformasjon og sender videre et output) viser seg å være ekstremt kraftfull.
Et nevralt nettverk kan ha et vilkårlig antall lag, og i disse lagene kan det finnes et vilkårlig antall nevroner. Prinsippet for nevrale nettverk er det samme uansett nettverkets størrelse: mat inn inputverdier, la dem strømme gjennom lagene og få til slutt et output i det siste laget. I et nevralt nettverk kalles det aller første laget input layer, og det aller siste laget (laget før label) kalles output layer. Alle lag imellom kalles hidden layers. Etter hvert som data passerer disse lagene, lærer algoritmen hvilke mønstre som finnes og hvordan disse mønstrene korrelerer med utfallet som studeres.
Hva er bias?
Bias er enda en parameter som justeres når det nevrale nettverket kalibreres. Ved å justere bias kan man øke eller redusere et nevrons aktivitet. Det betyr at det er to ting som justeres når nettverket kalibrerer seg: vekter og bias.
Prinsippet for deep learning
Det nevrale nettverket skaper representasjoner etter hvert som informasjonen strømmer gjennom lagene. Når vektene justeres, blir noen nevroner sterkere mens andre nevroner blir svakere, eller til og med slukker. Nettverket styrer seg selv ved hjelp av loss-funksjonen. Deep learning kan dermed betraktes som en prosess der data filtreres i flere trinn, og etter hvert som data strømmer gjennom lagene, dechiffreres de.
Denne mekanismen fører til at lagene trekker ut nøkkelkomponenter i dataene, og ved hjelp av disse lærer datamaskinen hvilke komponenter som skiller hunder fra katter.
Når en datamaskin skal tolke innholdet i et bilde, kan den ikke umiddelbart se de større trekkene i bildet. I datamaskinen omdannes nemlig bildet til et rutenett av tall, og disse tallene mates så inn i det nevrale nettverket der informasjonen transformeres. Under transformasjonen trekkes den viktige informasjonen ut. Datamaskinen kan da oppdage linjer, hjørner, sirkler osv. Kombinasjonen av ulike geometrier brukes deretter til å skille ulike objekter fra hverandre.
Hvorfor er deep learning så effektivt?
Det finnes mange metoder for å predikere. Noen metoder er generelle og kan predikere på mange ulike typer data, mens andre metoder er mer spesifikke. De aller fleste metoder krever en viss grad av feature engineering, noe som betyr at rådataene må bearbeides før de kan analyseres. Dette kan for eksempel innebære at man manuelt må omdanne innholdet i et fotografi til et format som kan analyseres. Dette manuelle arbeidet er som regel svært tidkrevende og komplisert. Med deep learning er feature engineering fullstendig automatisert. Det nevrale nettverket håndterer dette helt automatisk, uansett hvordan dataene ser ut. I motsetning til andre analysemetoder kan deep learning håndtere tabelldata, bilder og video.