
Et ensemble skaper bedre musikk. Tusen prediksjonsmodeller er bedre enn én.
Mennesket har en tendens til å strukturere tenkningen og beslutningene sine. En struktur vi ofte bruker, både bevisst og ubevisst, er hierarkier. Du skaper og bruker hierarkier hver dag. Se for deg at du befinner deg i en butikk der du prøver å ta en beslutning om å kjøpe en datamaskin. For å ta en klok beslutning begynner du med å spørre deg selv: “Har jeg råd til å kjøpe en ny datamaskin”. Hvis svaret på dette spørsmålet er “nei”, avstår du sannsynligvis fra å kjøpe datamaskinen. Hvis svaret på spørsmålet er “ja”, går du trolig videre til neste spørsmål: “Trenger jeg en ny datamaskin?” . Hvis svaret er “nei”, avstår du sannsynligvis fra å kjøpe datamaskinen. Hvis svaret er “ja”, spør du deg kanskje: “Er dette den riktige datamaskinen for meg?” . Du har med andre ord forsøkt å ta en beslutning ved å stille deg selv en rekke spørsmål med hierarkisk struktur. Som det fremgår av bilde X, ser denne typen beslutningsflyt ut som et opp-ned-vendt tre, og dette kalles et beslutningstre (eng. decision tree).
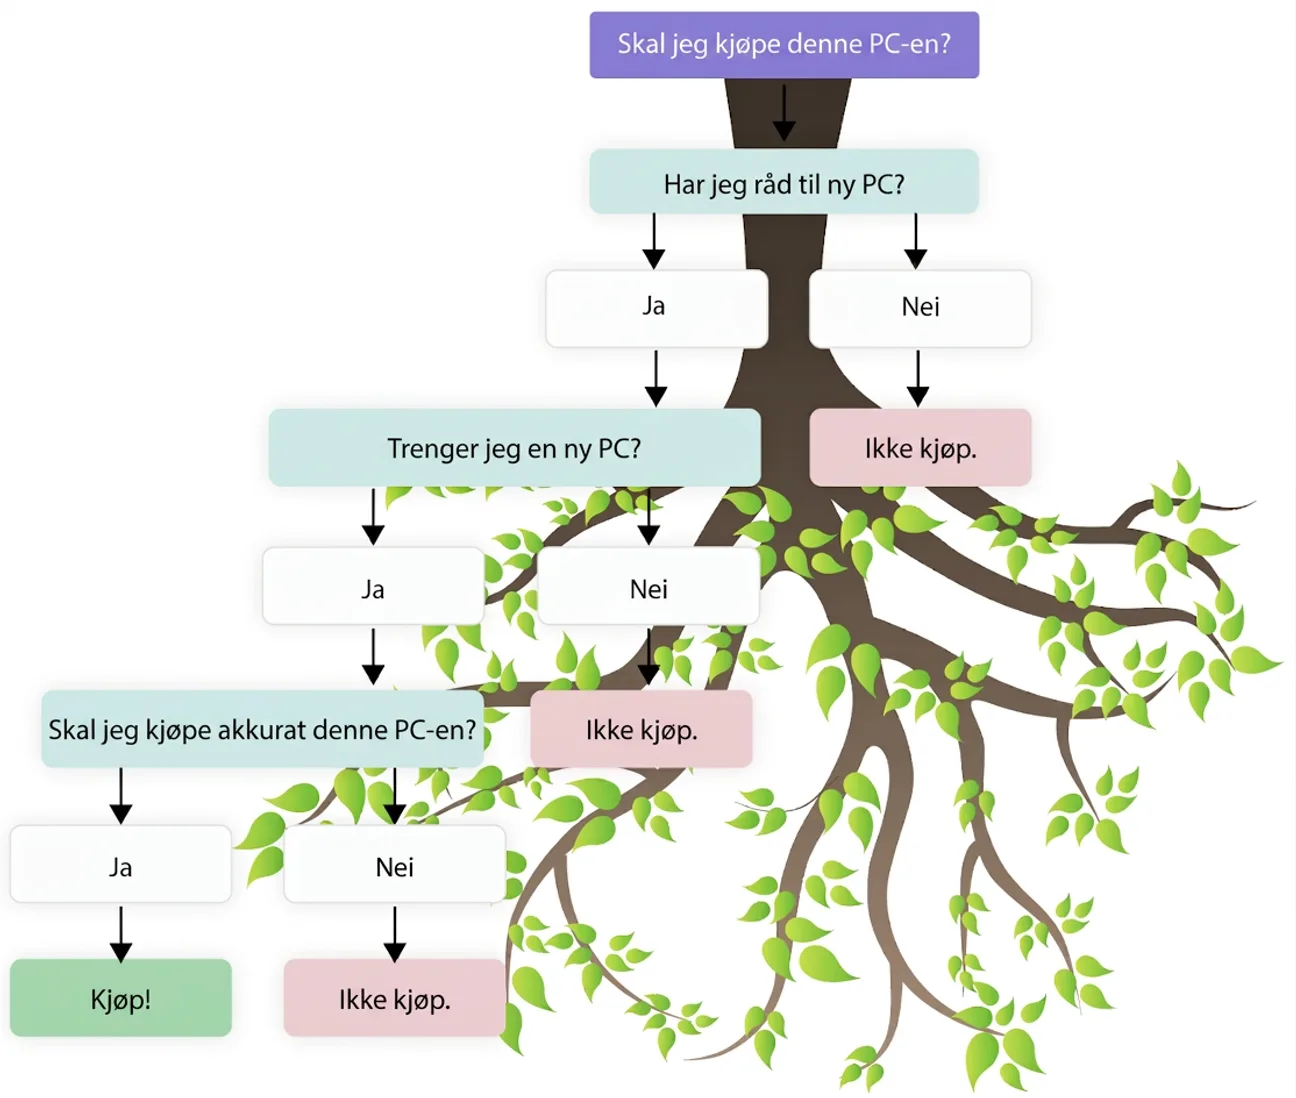
Beslutningstrær: en briljant idé
I dag dominerer beslutningstrærne nesten all maskinlæring som gjelder strukturerte data (dvs. data som presenteres i rader og kolonner). På Kaggle (www.kaggle.com) konkurrerer tusenvis av eksperter om å lage de beste prediksjonsmodellene, og konkurranseresultatene viser at beslutningstrær som oftest presterer bedre enn noen annen modell for strukturerte data. Faktisk bruker du allerede beslutningstrær hver dag, f.eks. når du bruker Googles søkemotor eller e-posttjenesten din. Forklaringen på at beslutningstrær kan brukes til prediksjon er enkel: i eksemplet ovenfor kan du bruke beslutningsalgoritmen på en annen datamaskin og vurdere om du heller burde kjøpe den.
Med moderne maskinlæring lager man beslutningstrær på en svært sofistikert måte. Man bruker en generell læringsprosedyre som ut fra mønstrene i dataene lager regler og dermed bygger treet. Treets struktur, og dermed prediksjonsmodellen, blir altså datadrevet (se tidligere diskusjon). Vi skal nå gå gjennom nøyaktig hvordan disse trærne lages og hvordan de brukes.
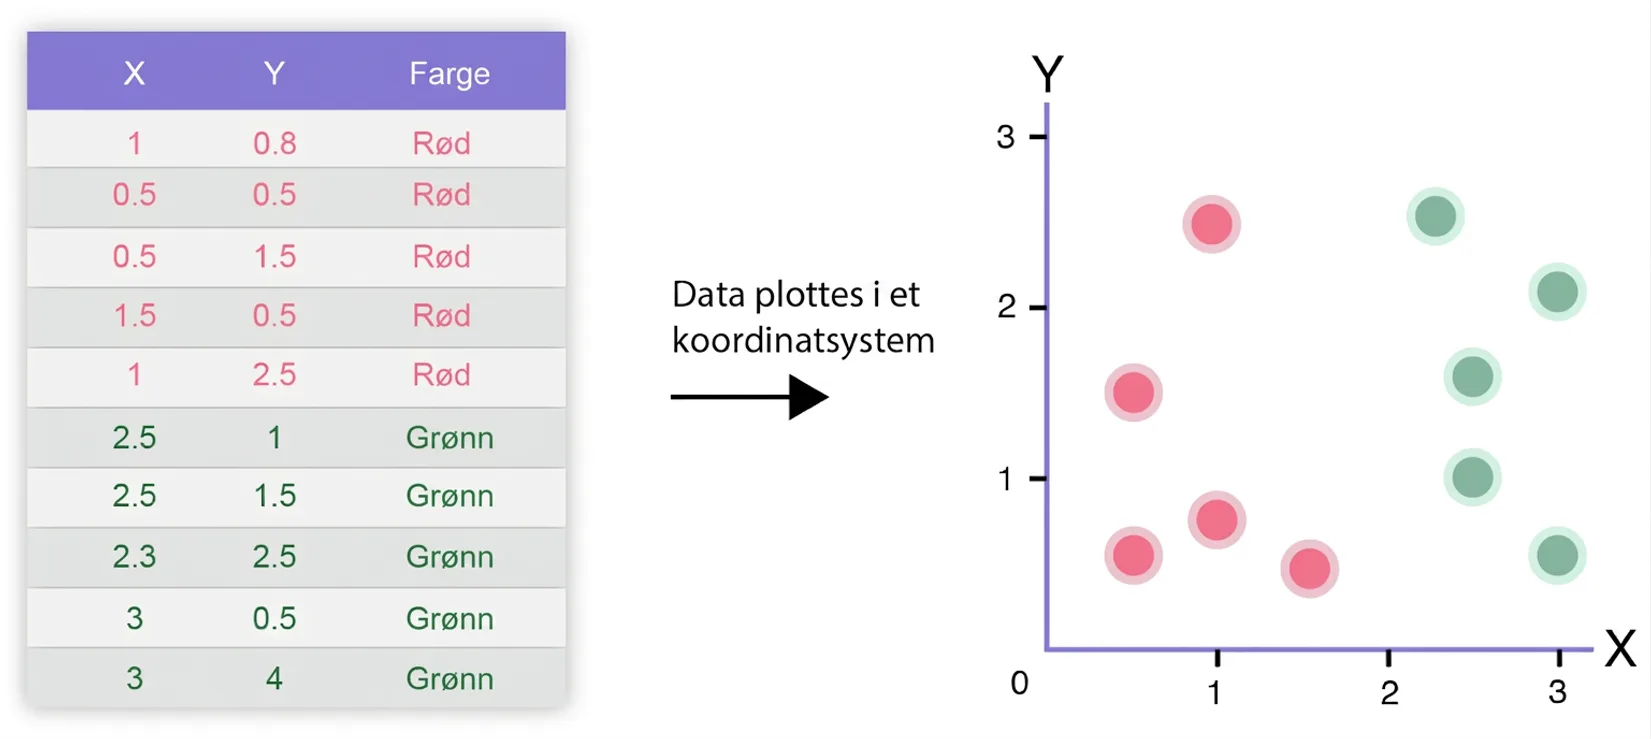
I figuren nedenfor presenteres de samme dataene i tabellen og i koordinatsystemet. Se for deg at vi skal legge til et punkt i koordinatsystemet, og at punktets x-verdi er 2,0. Hvilken farge tror du punktet vil ha? Sannsynligvis grønn, og dermed har du laget og evaluert et beslutningstre i hodet! Beslutningstreets struktur vises i neste figur.
I dette beslutningstreet brukes én enkelt regel basert på x-verdien. Hvis x er mindre enn 2, velger vi den venstre grenen, og der ser verdiene ut til å være røde. Hvis x er 2 eller større, velger vi den høyre grenen, og der ser observasjonene ut til å være grønne. Hver observasjon vil altså bli testet for å se om x er mindre enn 2, og deretter tas en beslutning om hvilken gren som skal velges. Dette punktet der dataene skal skilles fra hverandre, kalles en node. Selve delingen kalles split.
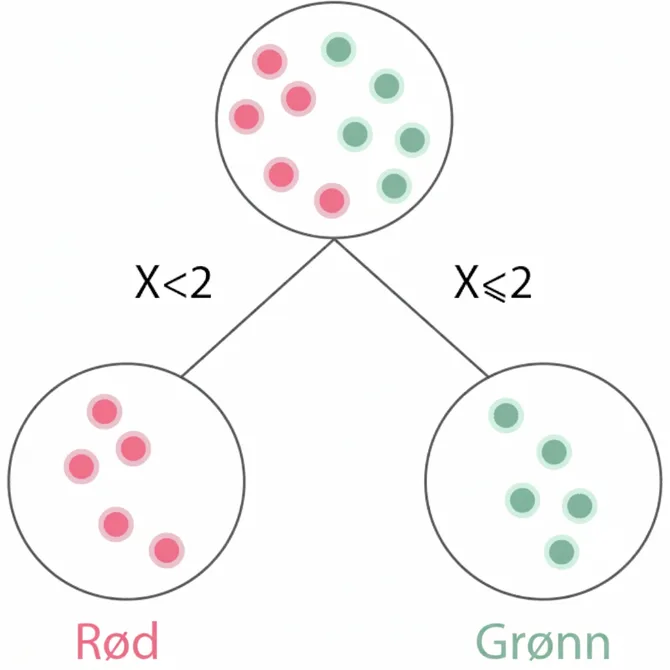
Dette beslutningstreet kan altså brukes til å gjette hvilken farge en observasjon vil ha basert på x-verdien. Vi kan altså predikere farge basert på én av variablene. Man sier at beslutningstreet kan brukes til å klassifisere observasjonene (som grønne eller røde).
I neste koordinatsystem ser vi nå tre ulike farger på observasjonene. Vi prøver å bruke vårt første beslutningstre. X-verdier som er 2 eller større, vil fortsatt klassifiseres som grønne, men verdier mindre enn 2 kan ikke klassifiseres korrekt hver gang, fordi noen av observasjonene er blå. Vi trenger altså enda en node!
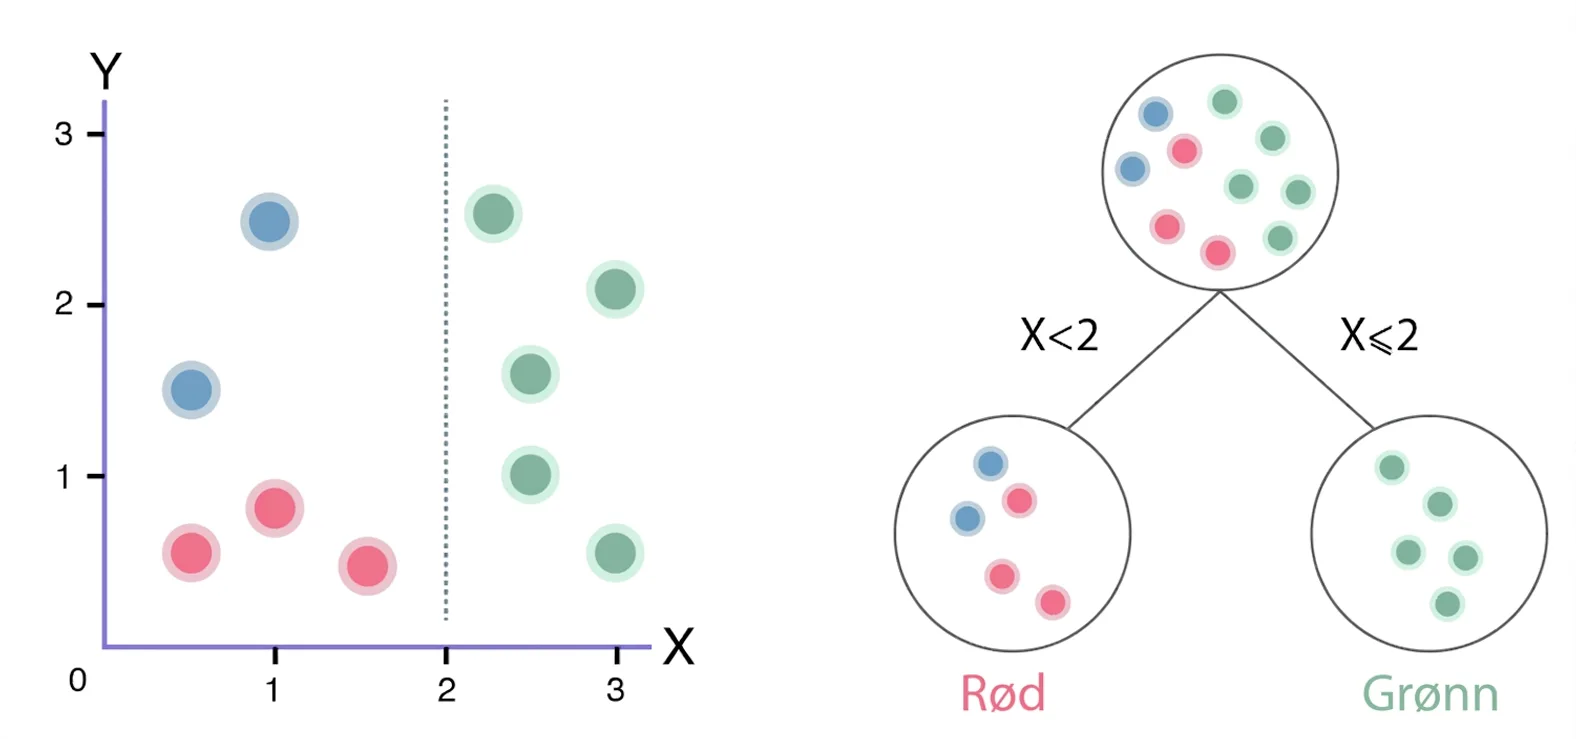
Vi lager nå enda en node, og vi lager en ny regel basert på y-verdien. Hvis y-verdien er mindre enn 1, klassifiserer vi observasjonen som rød, og ellers som blå, slik:
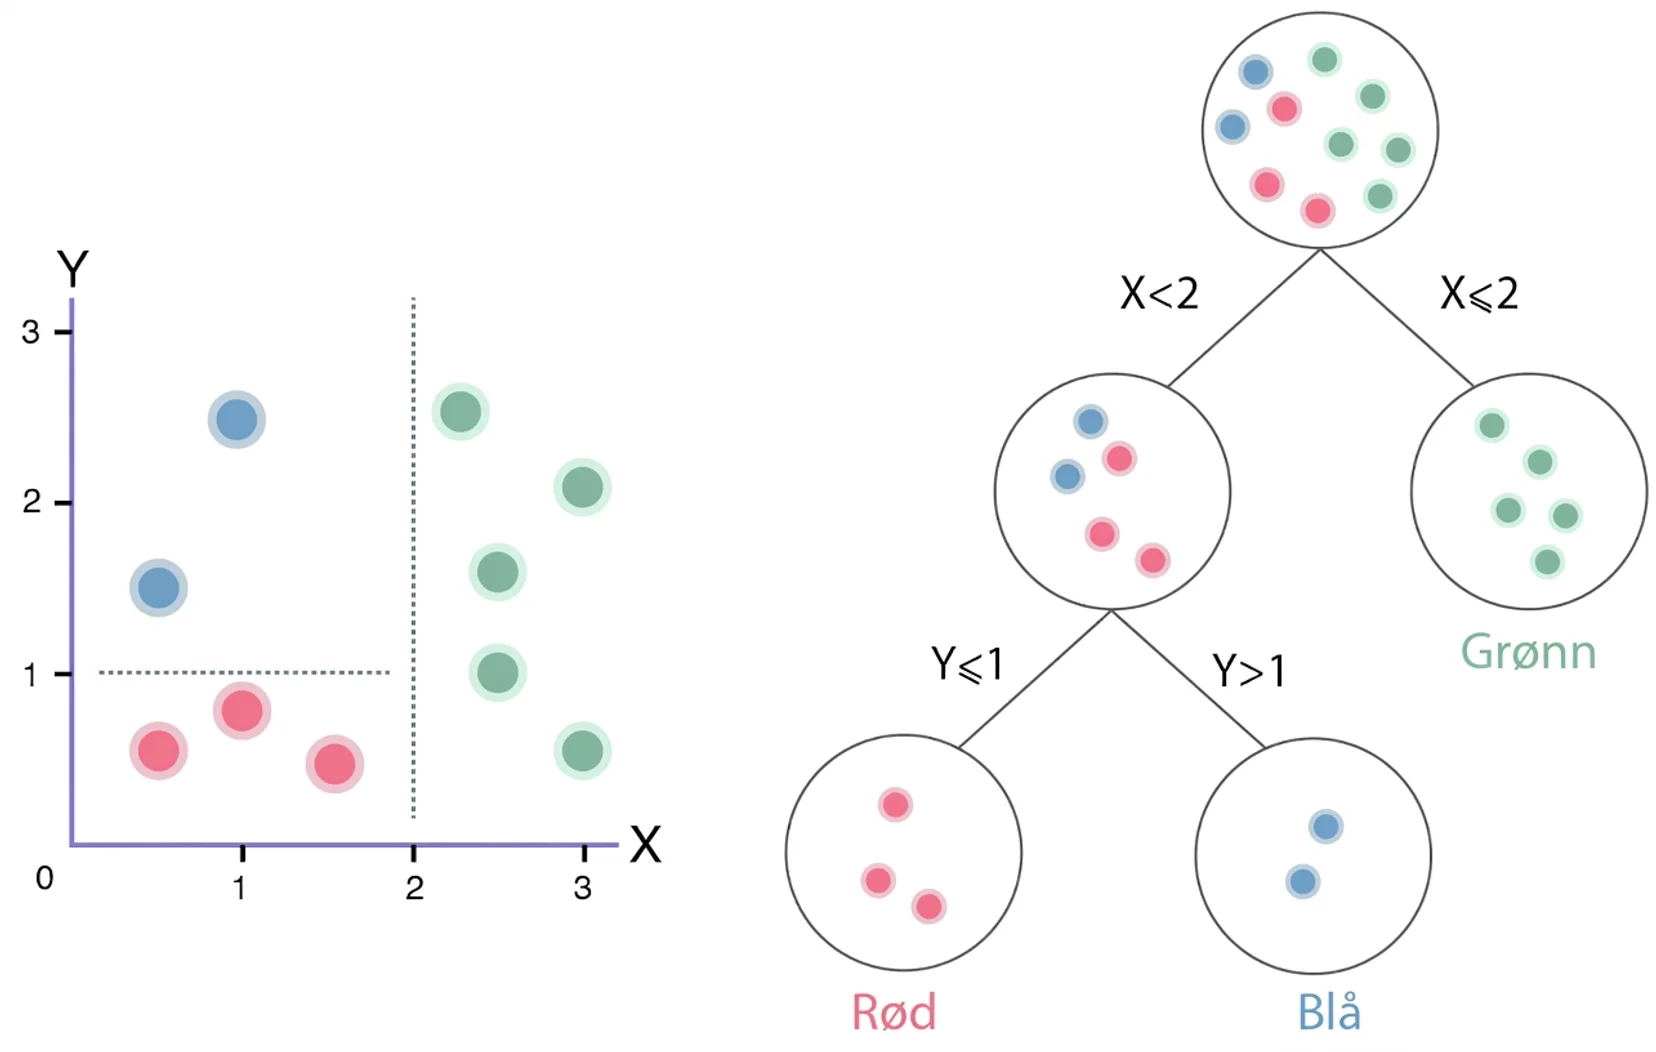
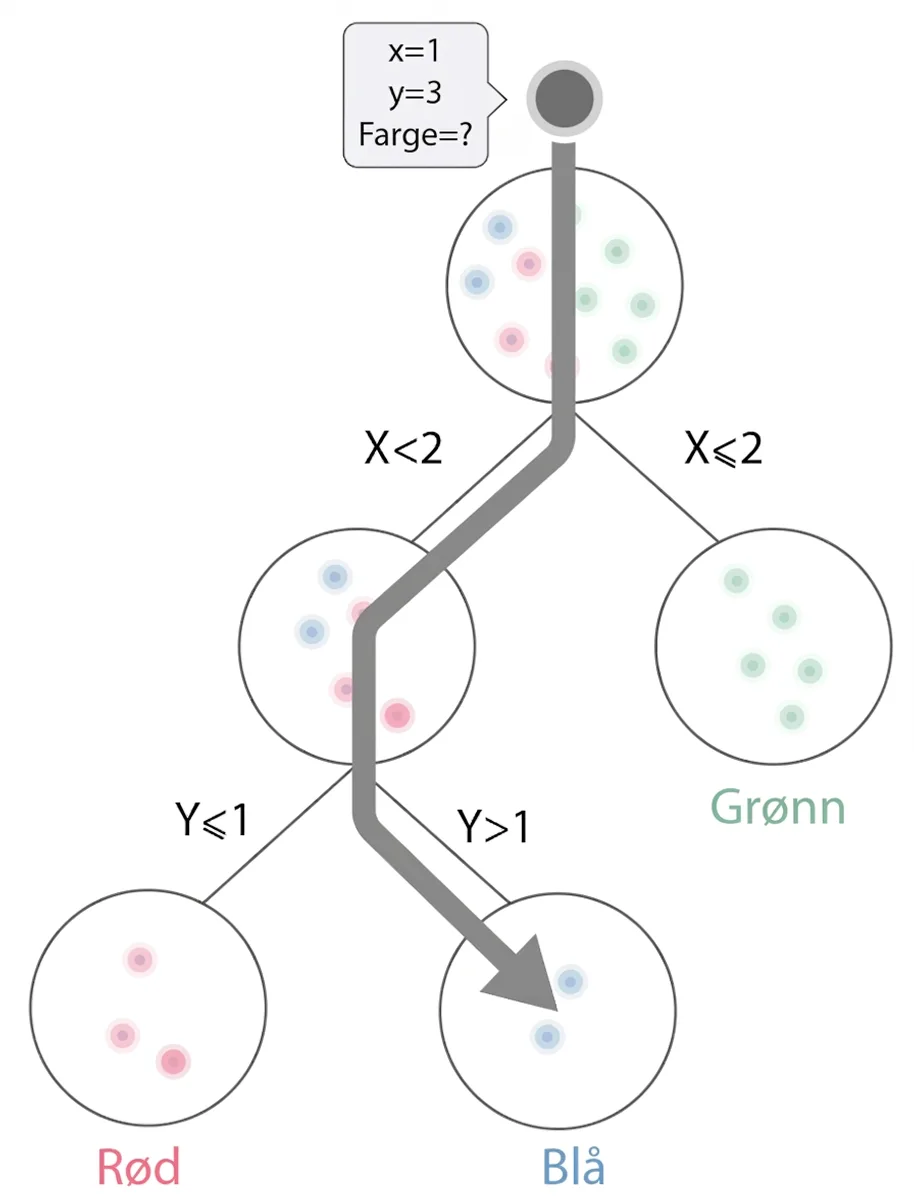
Dette er faktisk hele prinsippet for å lage beslutningstrær. Som det fremgår av denne diskusjonen, kan vi nå bruke beslutningstreet vårt til å predikere hvilken farge en ny observasjon vil ha, basert på x- og y-verdien. Treet kan altså brukes som en prediksjonsmodell. Du ser et eksempel på dette i neste figur, der vi lar en helt ny observasjon flyte gjennom beslutningstreet for til slutt å gjette hvilken farge observasjonen sannsynligvis har.
Maskinlæring med beslutningstrær
Hvert enkelt tre er en prediksjonsmodell. Prinsippet for å gjøre maskinlæring med beslutningstrær er å lage hundrevis, eller tusenvis, av trær og bruke dem samlet for å predikere. Man bruker altså et datasett til å lage hundrevis eller tusenvis av trær som deretter brukes til å predikere. Akkurat som med nevrale nettverk må trærne trenes og evalueres, noe som gjøres etter de samme prinsippene. Ettersom disse prediksjonsmodellene består av mange enkeltmodeller (dvs. enkeltstående trær), kalles de også ensemblemetoder (eng. ensemble methods), noe som viser til at man bruker et ensemble av prediksjonsmodeller. Noen ganger brukes også betegnelsen trebasert metode (eng. tree-based method).
Å konstruere mange trær
Som regel konstruerer man altså flere hundre eller tusenvis av beslutningstrær når man lager maskinlæring med beslutningstrær. Man lager disse trærne ut fra det samme datasettet. Hvis du for eksempel studerer besøkende på et nettsted og har data om 1000 besøkende, er dette datasettet som brukes til å bygge alle trærne. Dette gjøres ved at hvert tre bare får bruke en liten andel (oftest en tredjedel) av det totale datasettet. Denne andelen skal dessuten velges helt tilfeldig. Så det første treet får analysere en tilfeldig utvalgt tredjedel av alle de besøkende. Det neste treet får en ny, tilfeldig utvalgt, tredjedel av alle de besøkende og bygger treet basert på deres informasjon. Det samme gjelder det tredje, fjerde, femte og alle etterfølgende trær. Så hvert tre bygges med en tilfeldig utvalgt delmengde av dataene. Slik blir hvert tre unikt.
Å finne optimale noder og splitter
Følgende koordinatsystem viser det samme datasettet med ulike regler for å skille datapunktene. Til venstre ser vi splitter som lykkes i å skille alle fargene fra hverandre. Til høyre ser vi at kriteriene (reglene) ikke fører til at punktene kan skilles helt fra hverandre. For at treets prediksjon skal bli god, må det finne regler som kan skille observasjonene fra hverandre. For å lykkes med dette må datamaskinen evaluere hver split. En god split defineres ved at gruppene som dannes, skiller seg så mye som mulig fra hverandre med hensyn til det som studeres, som i dette tilfellet er farge.
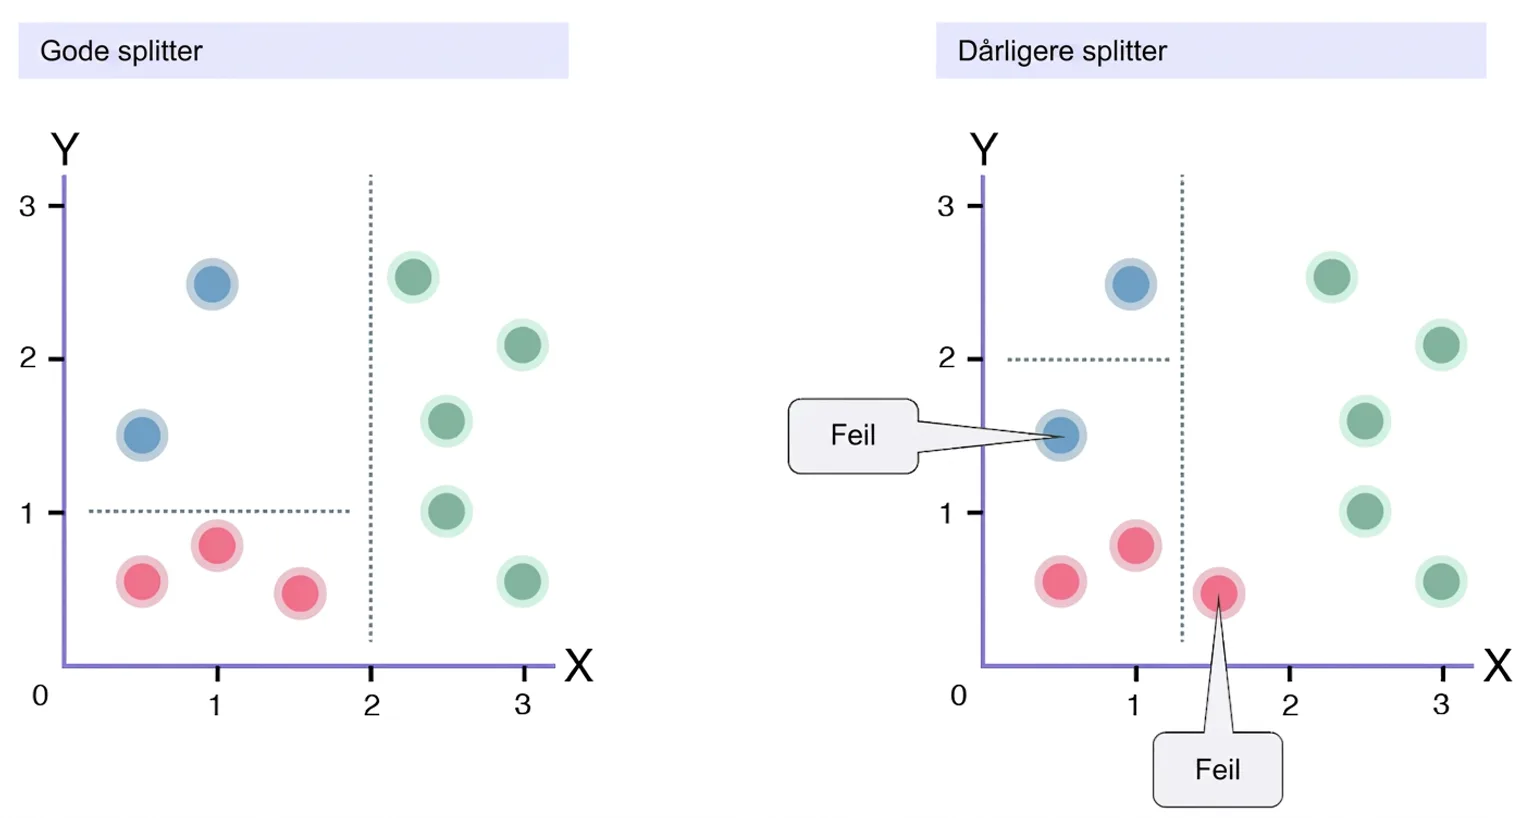
Det finnes en rekke ulike varianter for å gjøre denne evalueringen. Alle variantene fungerer ved å beregne hvor godt ulike splitter kan separere fargene fra hverandre. Datamaskinen kan altså prøve seg frem for å se hvilken split som gir maksimal separasjon av observasjonene med hensyn til fargen deres.
Denne metoden for å finne optimale splitter er generell og kan brukes på alle typer strukturerte data, dvs. data i tabellformat (kolonner og rader). Det har ingen betydning om man studerer pasienter med kreft, besøkende i en nettbutikk, solstråler eller bilbatterier. Beslutningstrær er ekstremt kraftfulle og kan predikere på alle typer strukturerte data. Forklaringen på dette er den generelle læringsprosedyren, dvs. beregningen som gjøres for å lage hver split. Denne måten å “lære” på ligner faktisk menneskets måte å tenke på og gis her en eksakt matematisk funksjon.