Da du aktiverte tidyverse, fikk du også tilgang til en data frame kalt mpg, som er en forkortelse for miles per gallon. Den inneholder data om bilers drivstofforbruk og er nyttig for øvelsene nedenfor. Disse dataene ble samlet inn av US EPA (Environmental Protection Agency) og omfattet 38 ulike bilmodeller (https://fueleconomy.gov/).
Hvis du ikke allerede har tidyverse, installeres det med følgende kommando:
install.packages("tidyverse")Aktiver tidyverse:
library(tidyverse)Se de første radene i dataene:
mpg| manufacturer | model | displ | year | cyl | trans | drv | cty | hwy | fl |
|---|---|---|---|---|---|---|---|---|---|
| audi | a4 | 1.8 | 1999 | 4 | auto(l5) | f | 18 | 29 | p |
| audi | a4 | 1.8 | 1999 | 4 | manual(m5) | f | 21 | 29 | p |
| audi | a4 | 2.0 | 2008 | 4 | manual(m6) | f | 20 | 31 | p |
| audi | a4 | 2.0 | 2008 | 4 | auto(av) | f | 21 | 30 | p |
| audi | a4 | 2.8 | 1999 | 6 | auto(l5) | f | 16 | 26 | p |
| audi | a4 | 2.8 | 1999 | 6 | manual(m5) | f | 18 | 26 | p |
| audi | a4 | 3.1 | 2008 | 6 | auto(av) | f | 18 | 27 | p |
| audi | a4 quattro | 1.8 | 1999 | 4 | manual(m5) | 4 | 18 | 26 | p |
| audi | a4 quattro | 1.8 | 1999 | 4 | auto(l5) | 4 | 16 | 25 | p |
| audi | a4 quattro | 2.0 | 2008 | 4 | manual(m6) | 4 | 20 | 28 | p |
De første radene i mpg.
mpg-data
I mpg-dataene finnes 234 rader og følgende 11 variabler:
- manufacturer: manufacturer name
- model: model name
- displ: engine displacement, in litres
- year: year of manufacture
- cyl: number of cylinders
- trans: type of transmission
- drv: the type of drive train, where f = front-wheel drive, r = rear wheel drive, 4 = 4wd
- cty: city miles per gallon
- hwy: highway miles per gallon
- fl: fuel type
- class: "type" of car
For at koden i øvelsene nedenfor skal være kortfattet, kommer vi ikke til å angi noen labels med labs() før grafen er ferdig. I eksemplet nedenfor lager vi en graf med ggplot(). I ggplot() angir vi at dataene kommer fra mpg, og vi bruker aes() for å mappe displ til x-aksen og hwy til y-aksen. Deretter legger vi til geom_point(), som visualiserer verdiene på x og y med punkter. Vi trenger ikke å angi estetisk mapping (aes()) i geom_point(), fordi den arves automatisk fra ggplot().
ggplot(data = mpg, aes(x = displ, y = hwy)) +
  geom_point()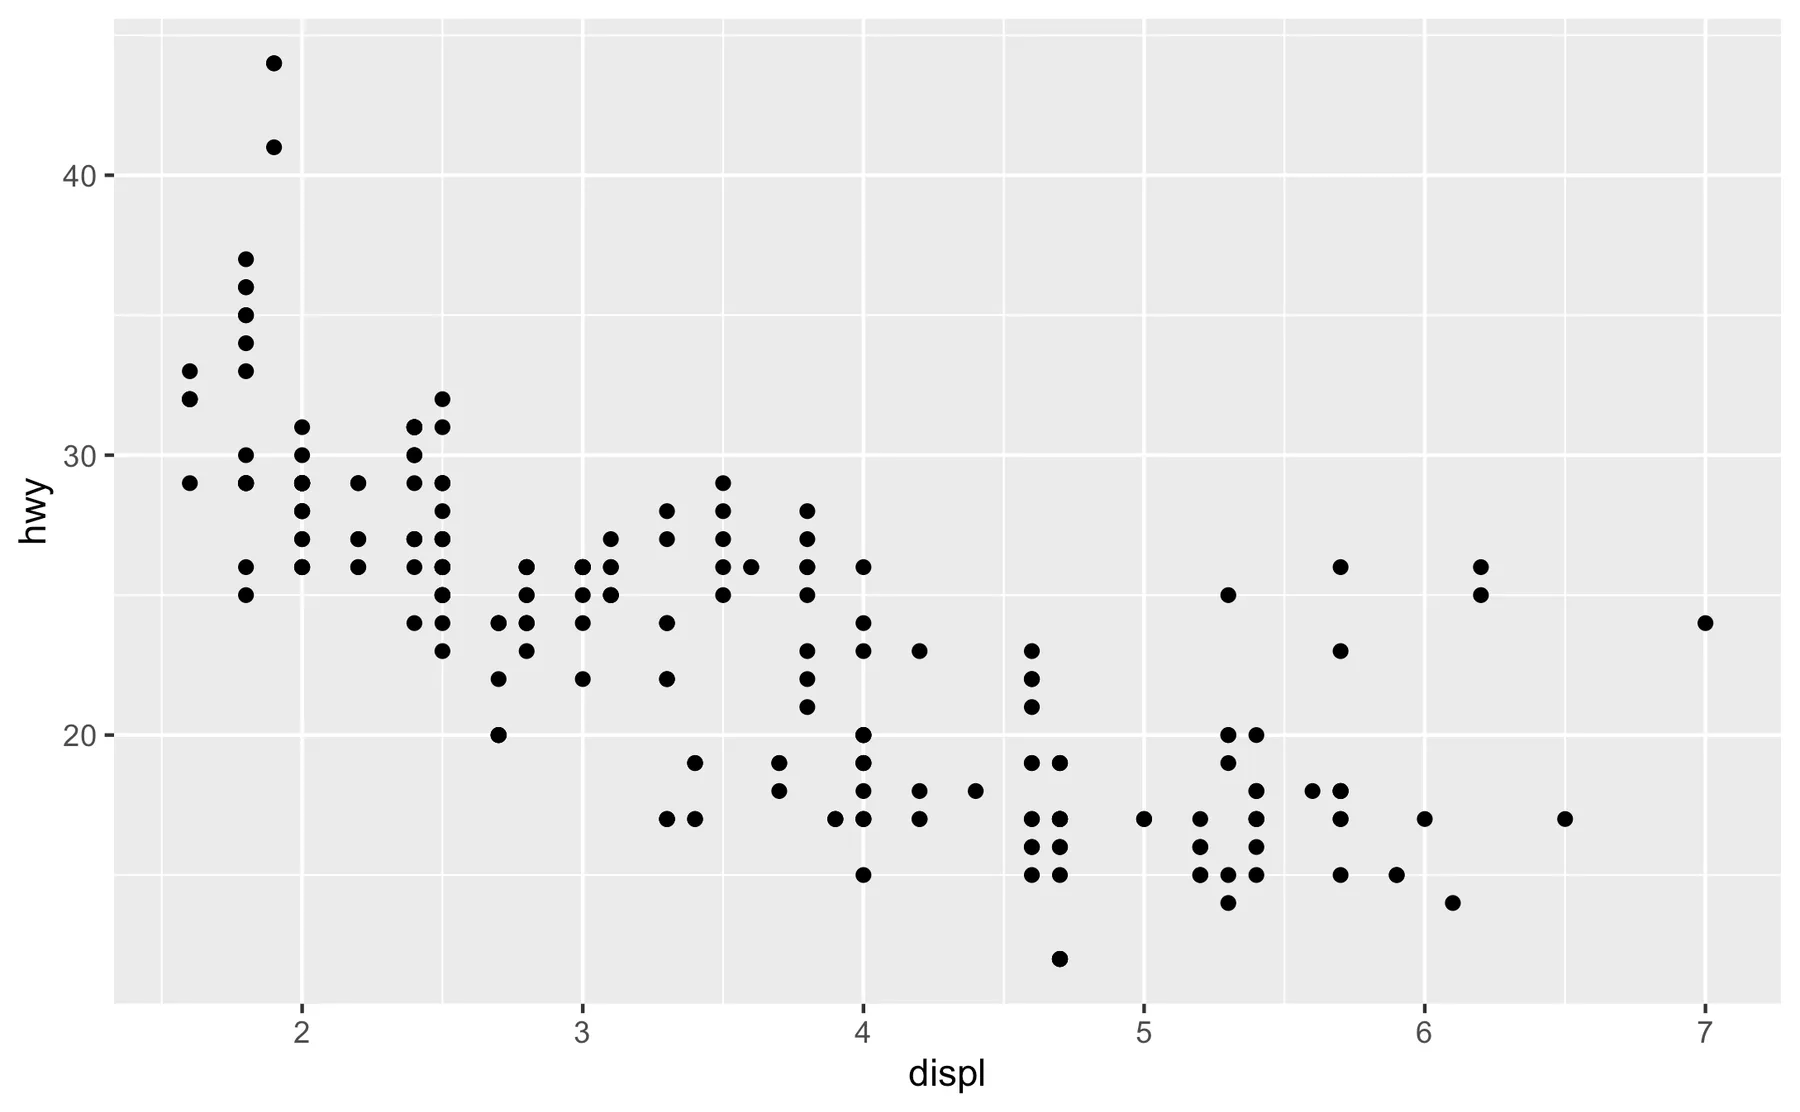
Du har nettopp sett det vakre ved ggplot(), nemlig muligheten til å bygge opp en graf ved hjelp av lag. Grafen ovenfor har bare ett eneste lag, nemlig geom_point().
Estetisk mapping (aesthetic mapping)
Ved å bygge opp en graf med lag kan vi styre hvilke data som vises i hvert lag. I neste graf lager vi separate punkter for biler som forbruker henholdsvis mer og mindre enn gjennomsnittet for drivstofforbruket (hwy). Merk at vi ikke angir aes() i ggplot(), men i stedet i hver geom_point().
## Beregn gjennomsnittet for drivstofforbruk (hwy)
median_hwy <- median(mpg$hwy)

## Lag grafen
ggplot() +
  # Biler som forbruker mer enn eller like mye som medianverdien
  geom_point(data = filter(mpg, hwy>=median_hwy),
             aes(x = displ, y = hwy),
             color="gold1",
             size=2) +
  # Biler som forbruker mindre enn medianverdien
  geom_point(data = filter(mpg, hwy<median_hwy),
             aes(x = displ, y = hwy),
             color="cyan4",
             size=2)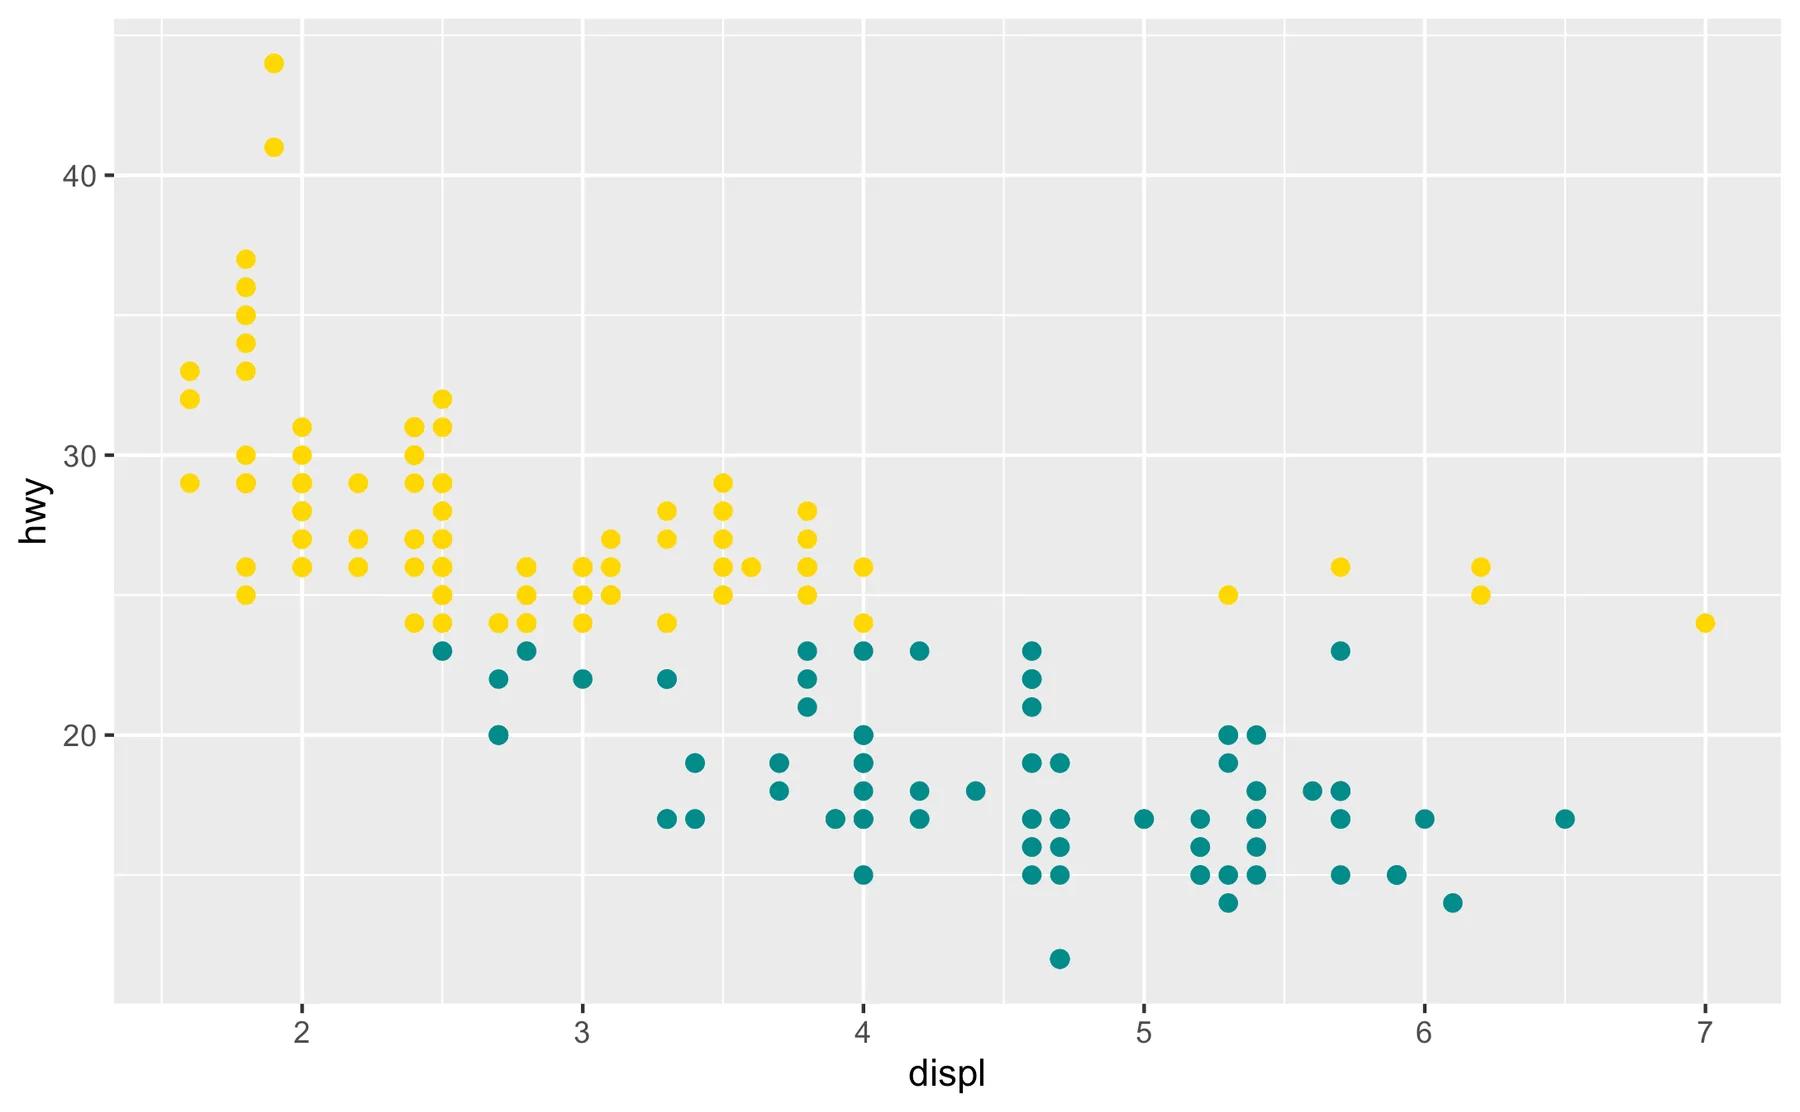
Deretter legger vi til en horisontal linje som viser hvor gjennomsnittet ligger på y-aksen. Dette gjøres med geom_hline() på linje 16.
## Beregn gjennomsnittet for drivstofforbruk (hwy)
median_hwy <- median(mpg$hwy)

## Lag grafen
ggplot() +
  # For biler som forbruker mer enn eller like mye som medianverdien
  geom_point(data = filter(mpg, hwy>=median_hwy),
             aes(x = displ, y = hwy),
             color="gold1",
             size=2) +
  # For biler som forbruker mindre enn medianverdien
  geom_point(data = filter(mpg, hwy<median_hwy),
             aes(x = displ, y = hwy),
             color="cyan4",
             size=2) +
  geom_hline(yintercept=median_hwy)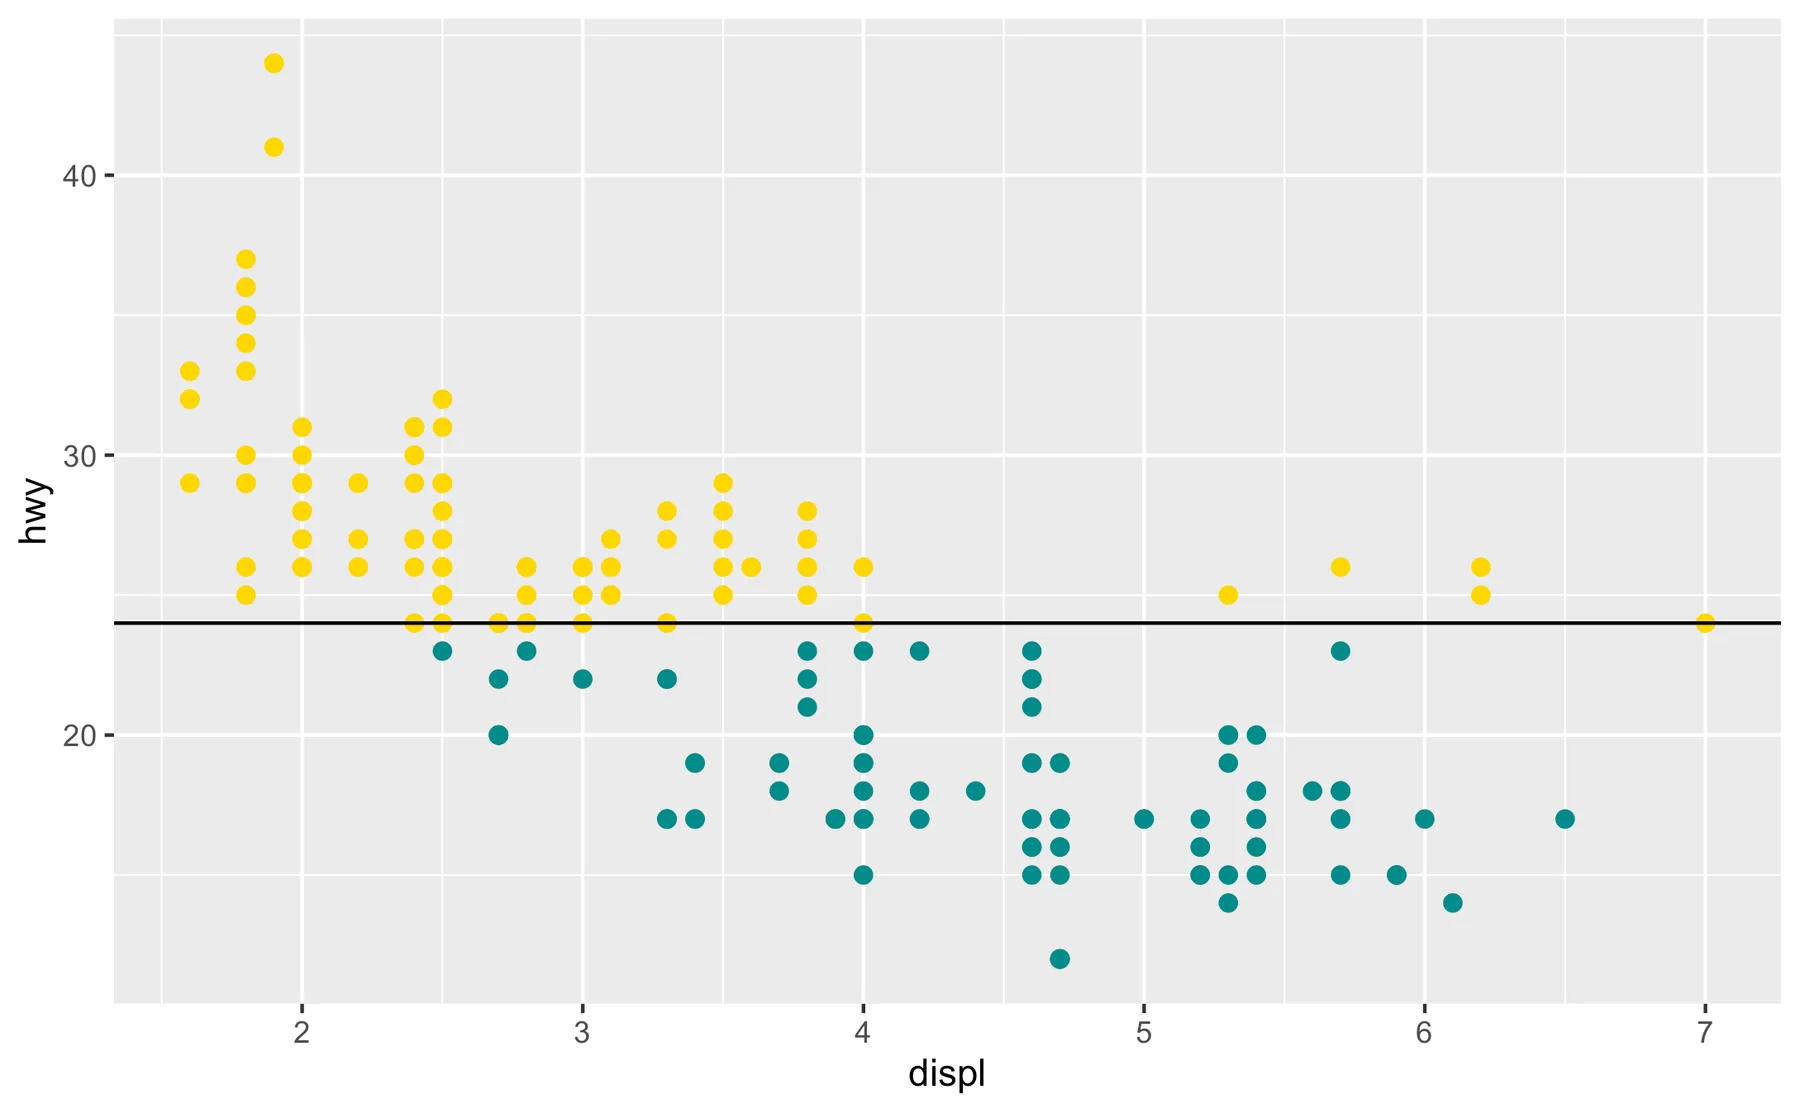
Vi fortsetter med å legge til tekst (med geom_label()) som viser medianverdien på den horisontale linjen. Teksten skal plasseres helt til venstre på x-aksen og ved medianverdien på y-aksen. I funksjonen geom_label() finnes argumentet label, som utgjør teksten som skal vises på grafen, og i dette tilfellet er det rett og slett medianverdien (linje 17). Merk nedenfor at vi angir «helt til venstre» på x-aksen ved å skrive x=-Inf (negative infinity). Hvis vi ønsker å plassere noe helt til høyre på x-aksen, angir vi i stedet x=Inf. På den måten trenger vi ikke selv å finne den minste og den største verdien på x-aksen.
## Beregn gjennomsnittet for drivstofforbruk (hwy)
median_hwy <- median(mpg$hwy)

## Lag grafen
ggplot() +
  # For biler som forbruker mer enn eller like mye som medianverdien
  geom_point(data = filter(mpg, hwy>=median_hwy),
             aes(x = displ, y = hwy),
             color="gold1",
             size=2) +
  # For biler som forbruker mindre enn medianverdien
  geom_point(data = filter(mpg, hwy<median_hwy),
             aes(x = displ, y = hwy),
             color="cyan4",
             size=2) +
  geom_hline(yintercept=median_hwy) +
  geom_label(aes(x=-Inf, y=median_hwy), label=median_hwy)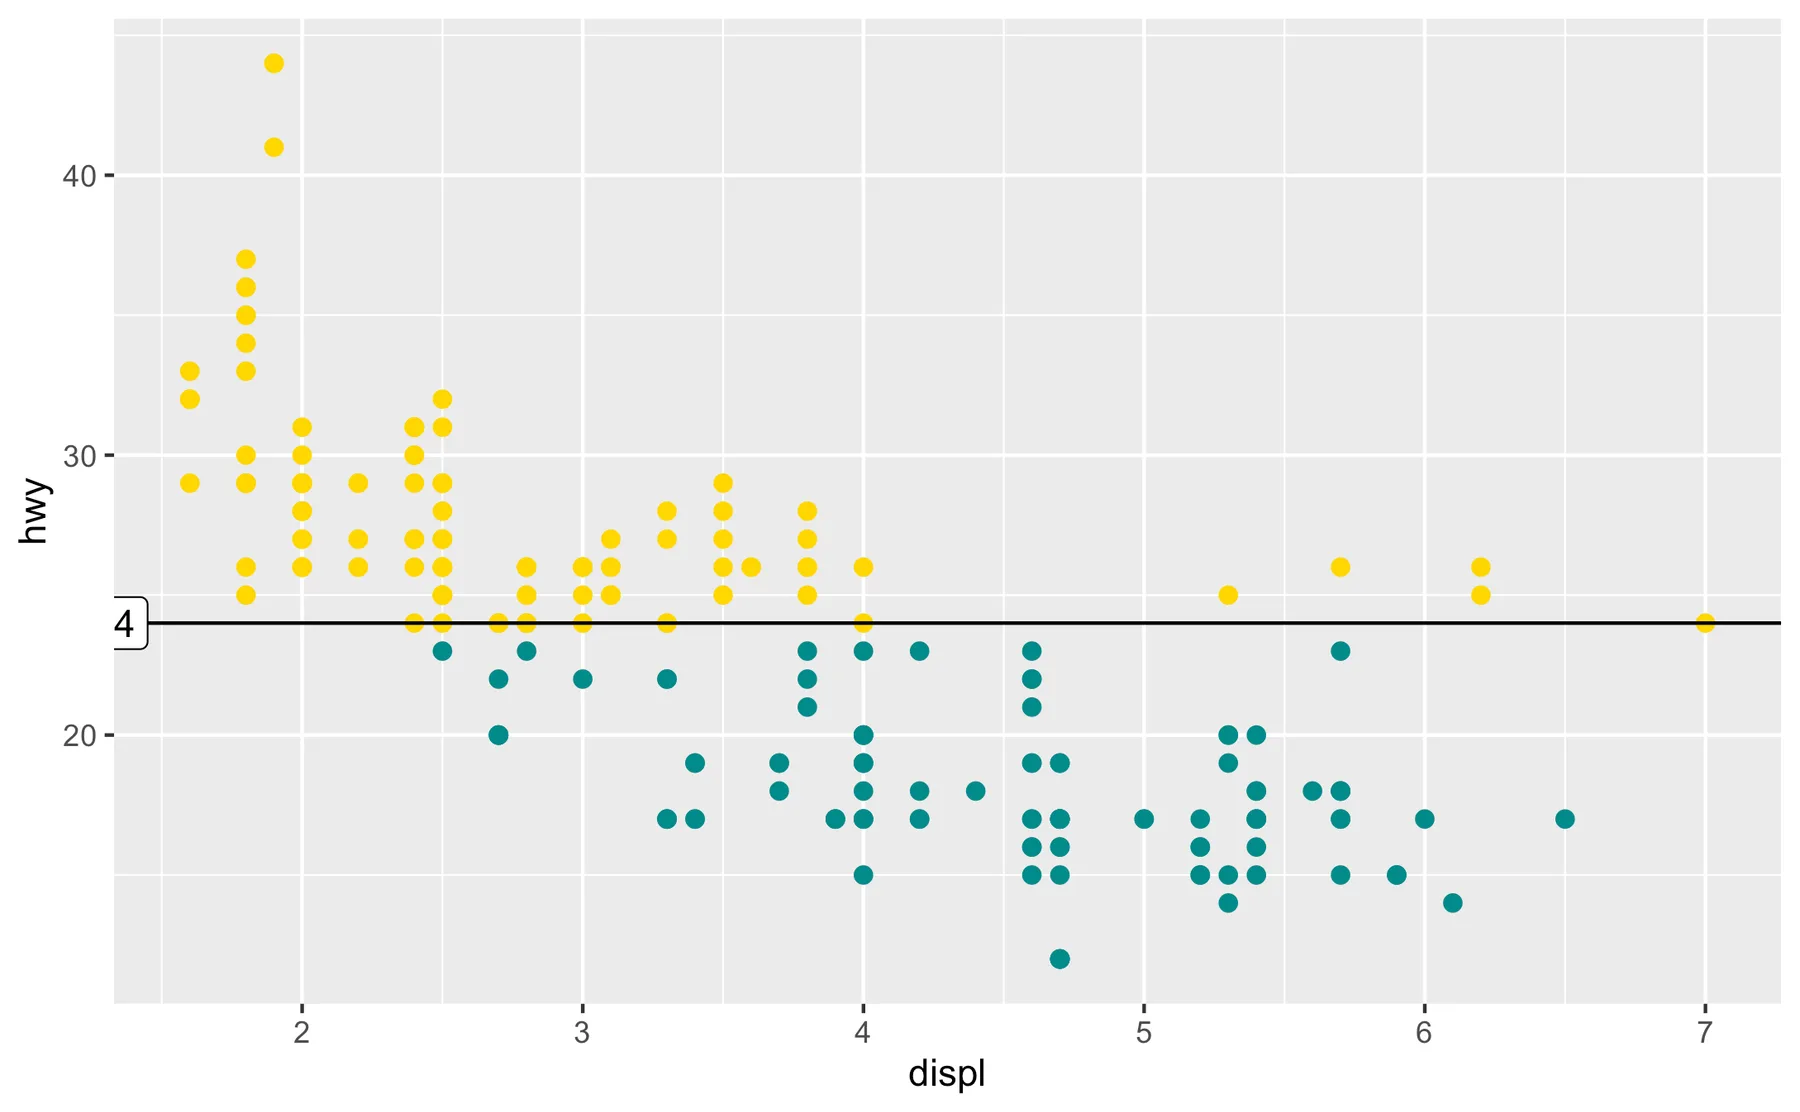
Horisontal og vertikal justering (hjust, vjust)
Dessverre havnet en del av etiketten utenfor grafen, slik det fremgår av figuren ovenfor. Heldigvis har de fleste geom() også argumentene hjust og vjust, som gjør det mulig å forskyve en komponent (f.eks. et datapunkt eller en etikett) horisontalt eller vertikalt. Det kan i begynnelsen være litt vanskelig å forstå hvordan hjust og vjust forskyver komponenter, men følgende huskelapp gjør det mye enklere:
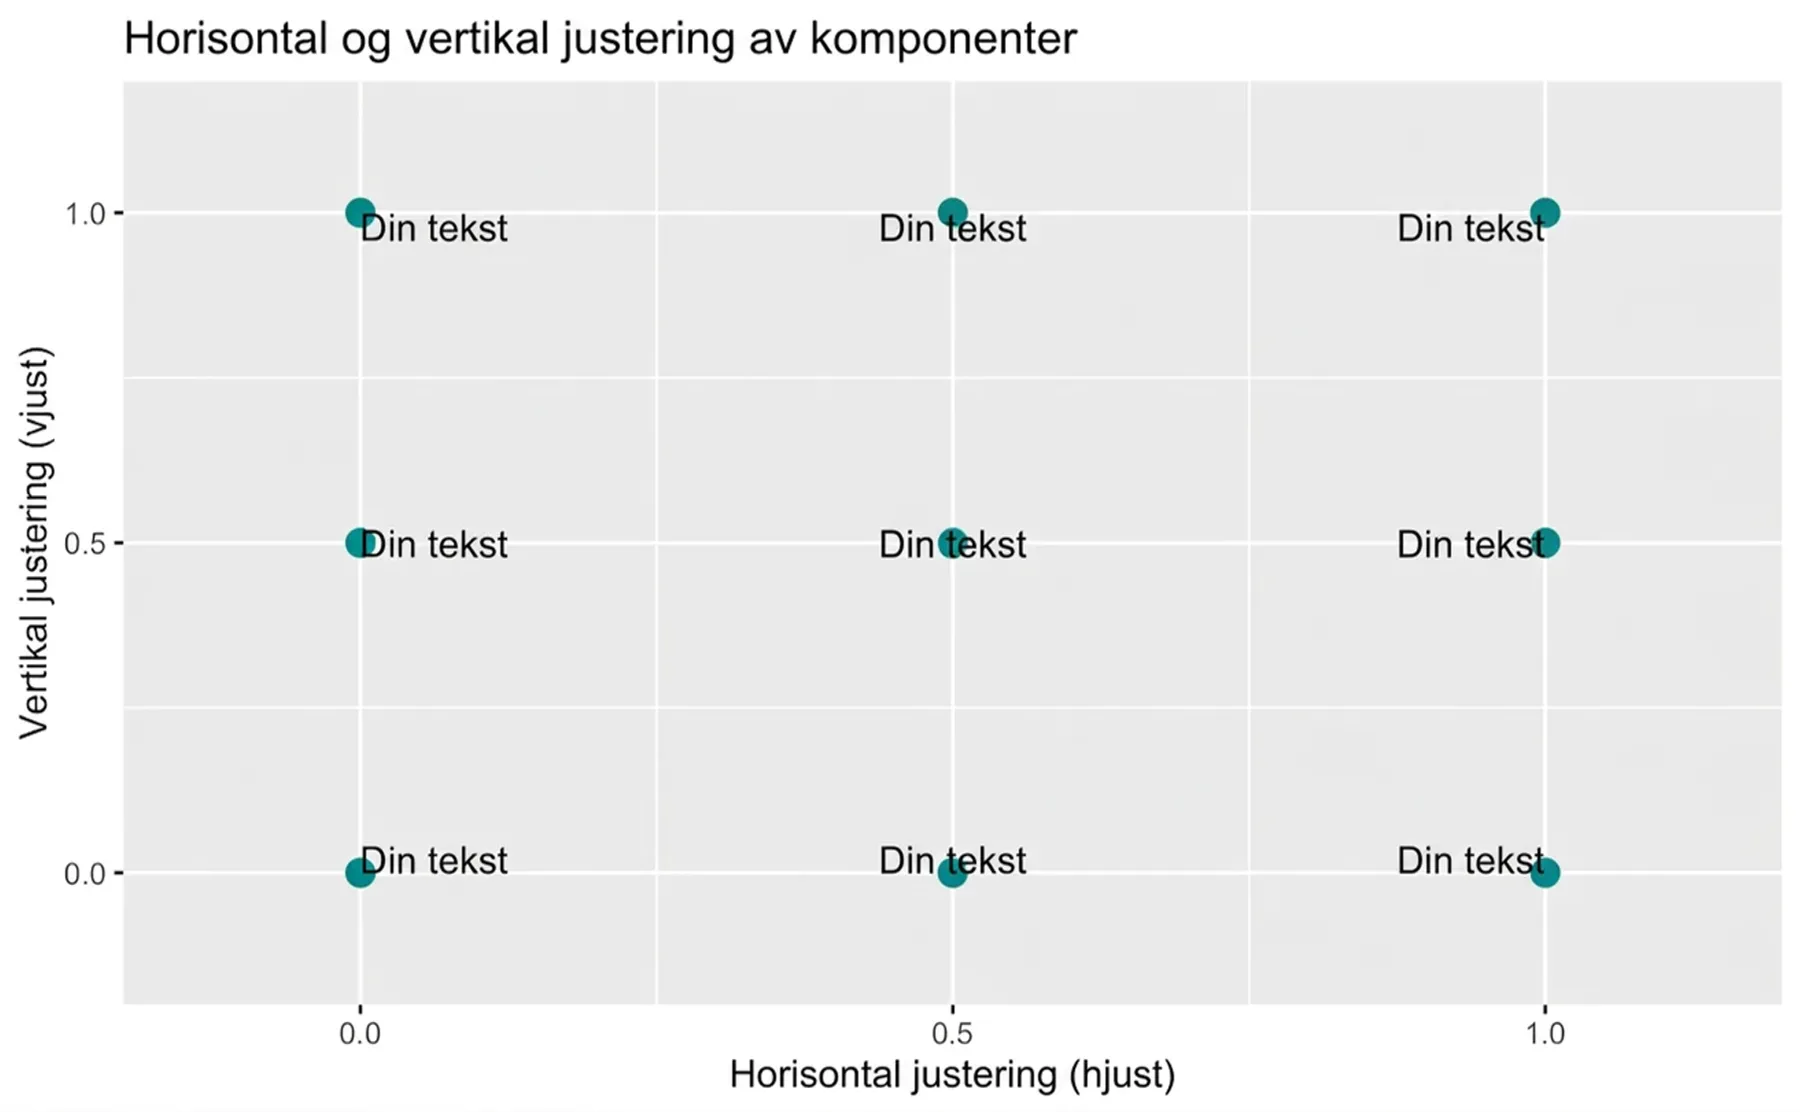
Av det ovenstående fremgår det at hjust=0 og vjust=0.5 burde forskyve etiketten mot høyre på x-aksen. La oss prøve dette (linje 17):
## Beregn gjennomsnittet for drivstofforbruk (hwy)
median_hwy <- median(mpg$hwy)

## Lag grafen
ggplot() +
  # For biler som forbruker mer enn eller like mye som medianverdien
  geom_point(data = filter(mpg, hwy>=median_hwy),
             aes(x = displ, y = hwy),
             color="gold1",
             size=2) +
  # For biler som forbruker mindre enn medianverdien
  geom_point(data = filter(mpg, hwy<median_hwy),
             aes(x = displ, y = hwy),
             color="cyan4",
             size=2) +
  geom_hline(yintercept=median_hwy) +
  geom_label(aes(x=-Inf, y=median_hwy), label=median_hwy, hjust=0, vjust=0.5)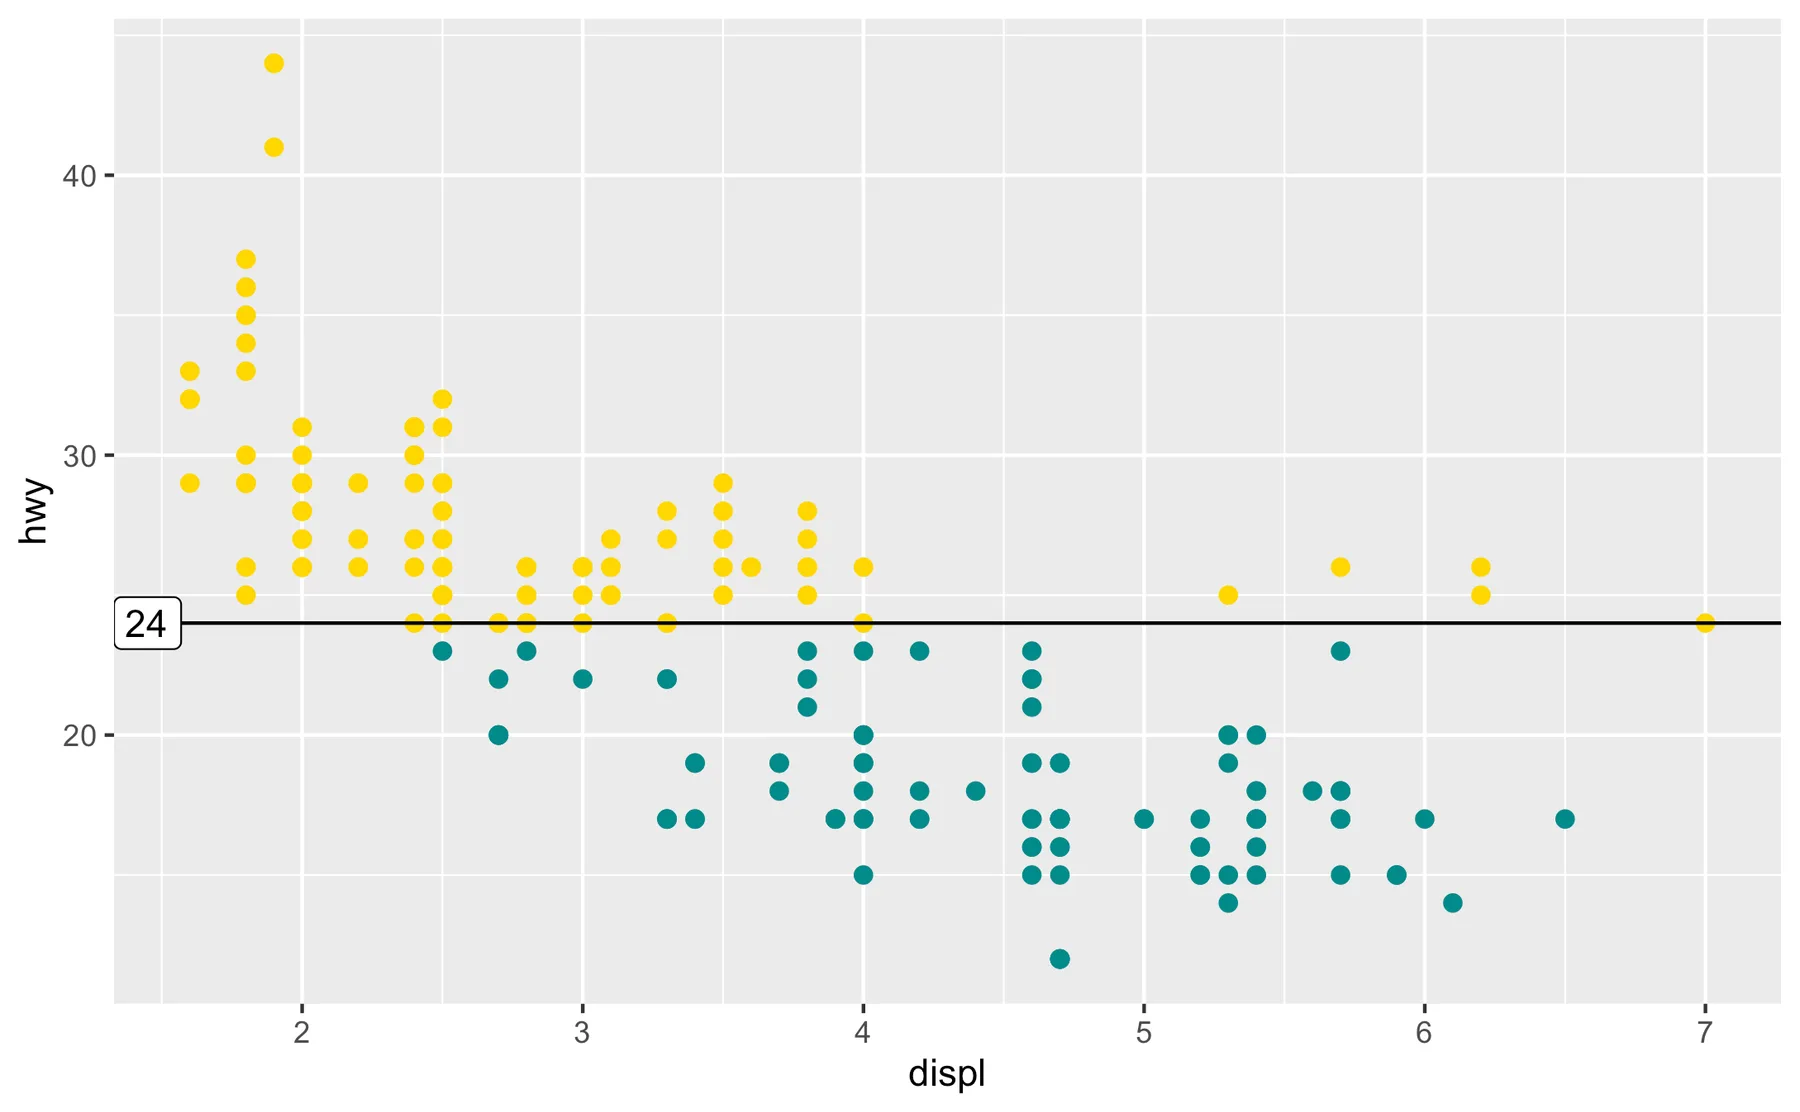
Koden justeres nå slik at den estetiske mappingen (aes()) skjer i ggplot(). I mpg finnes kolonnen class, som angir hvilken type bil det er. Vi vil bruke class til å fargelegge datapunktene. Dette gjør vi ved å angi color=class i aes(). Hensikten med dette er å undersøke om det finnes en sammenheng mellom hvilken klasse bilen tilhører og drivstofforbruket (mwy).
ggplot(data=mpg, aes(x = displ,
                     y = hwy,
                     color=class)) +
  geom_point()

## Du kan skrive "color" eller "colour", begge variantene godtas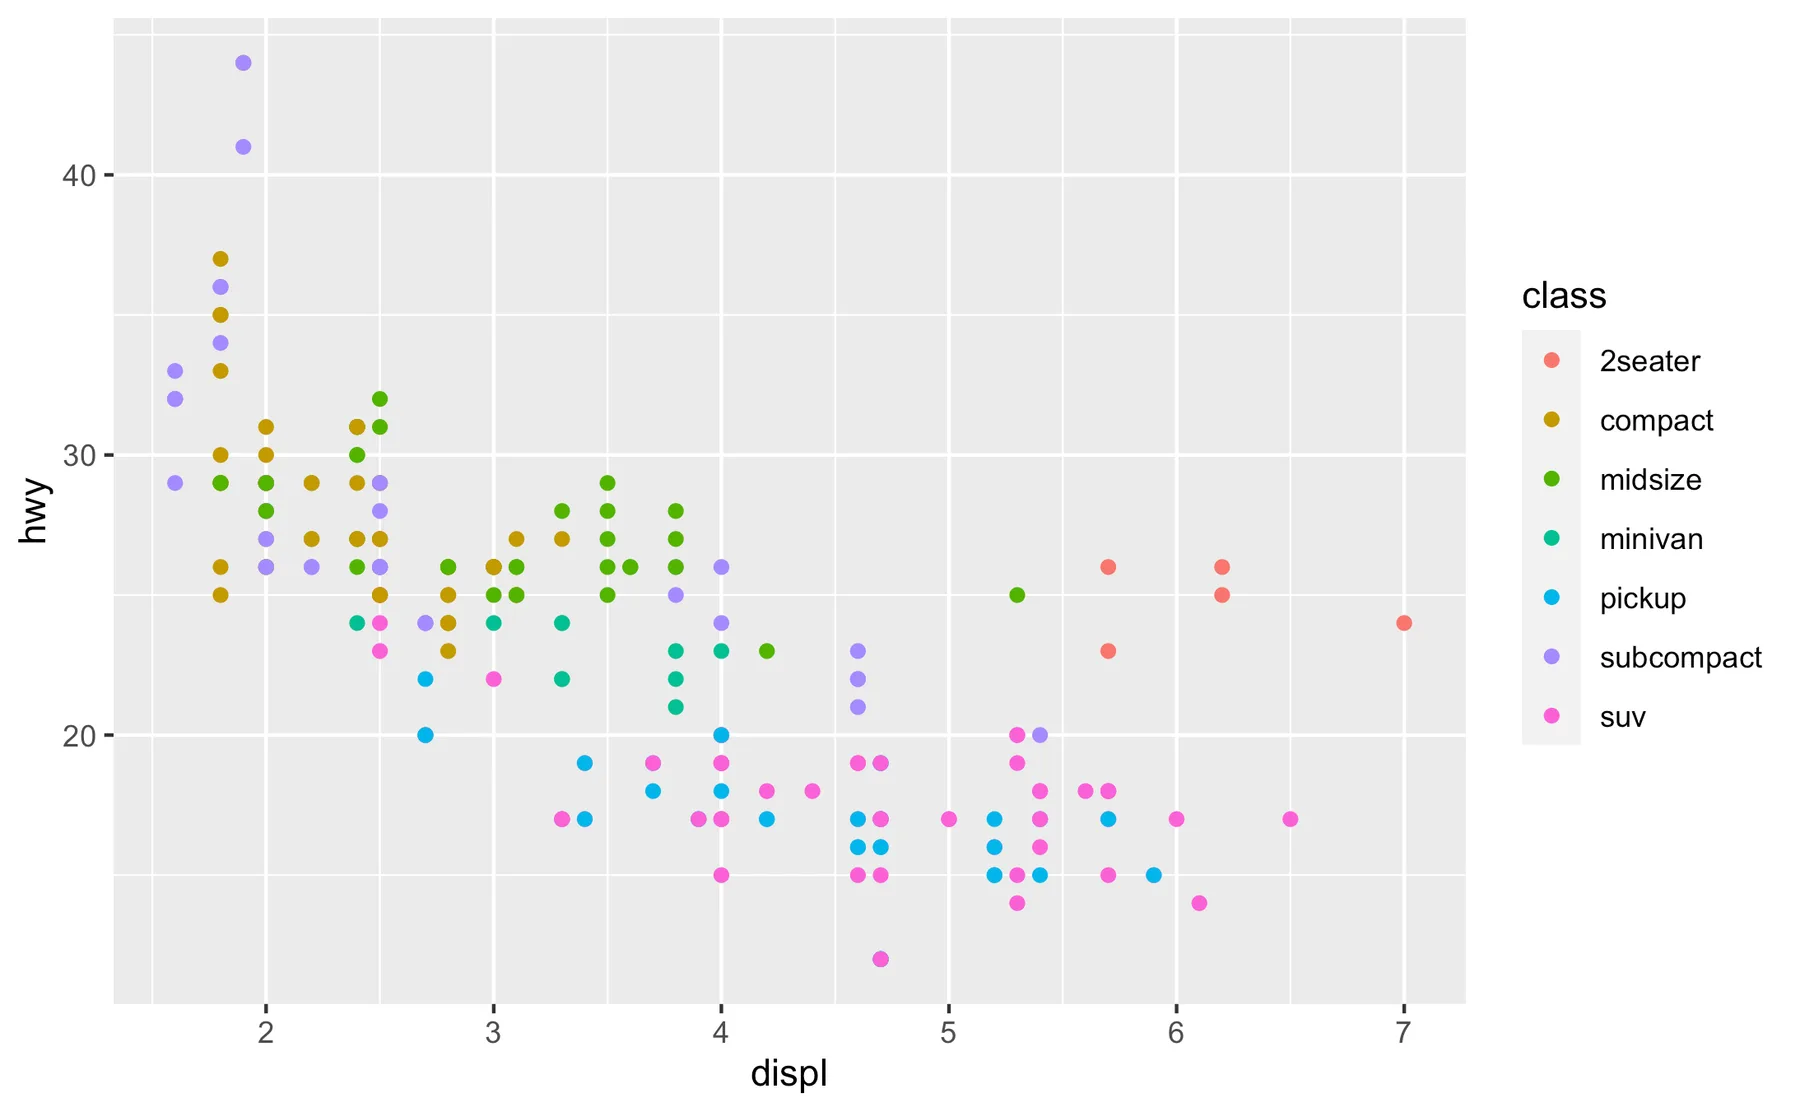
Den estetiske mappingen i aes() påvirker altså alle datapunktene. I eksemplet ovenfor anga vi at datapunktene skulle få en unik farge for hvert nivå i kolonnen class. Fargenes betydning vises til høyre for figuren. Merk at fargeforklaringen til høyre har overskriften «class», som er kolonnen som ble angitt i color.
Vi fortsetter å endre grafen ved å legge til mer informasjon. Vi ønsker nå at størrelsen på hvert datapunkt skal være en funksjon av antall sylindre i motoren. Da mapper vi variabelen cyl til parameteren size i aes():
ggplot(data=mpg, aes(x = displ,
                     y = hwy,
                     color=class,
                     size=cyl)) +
  geom_point()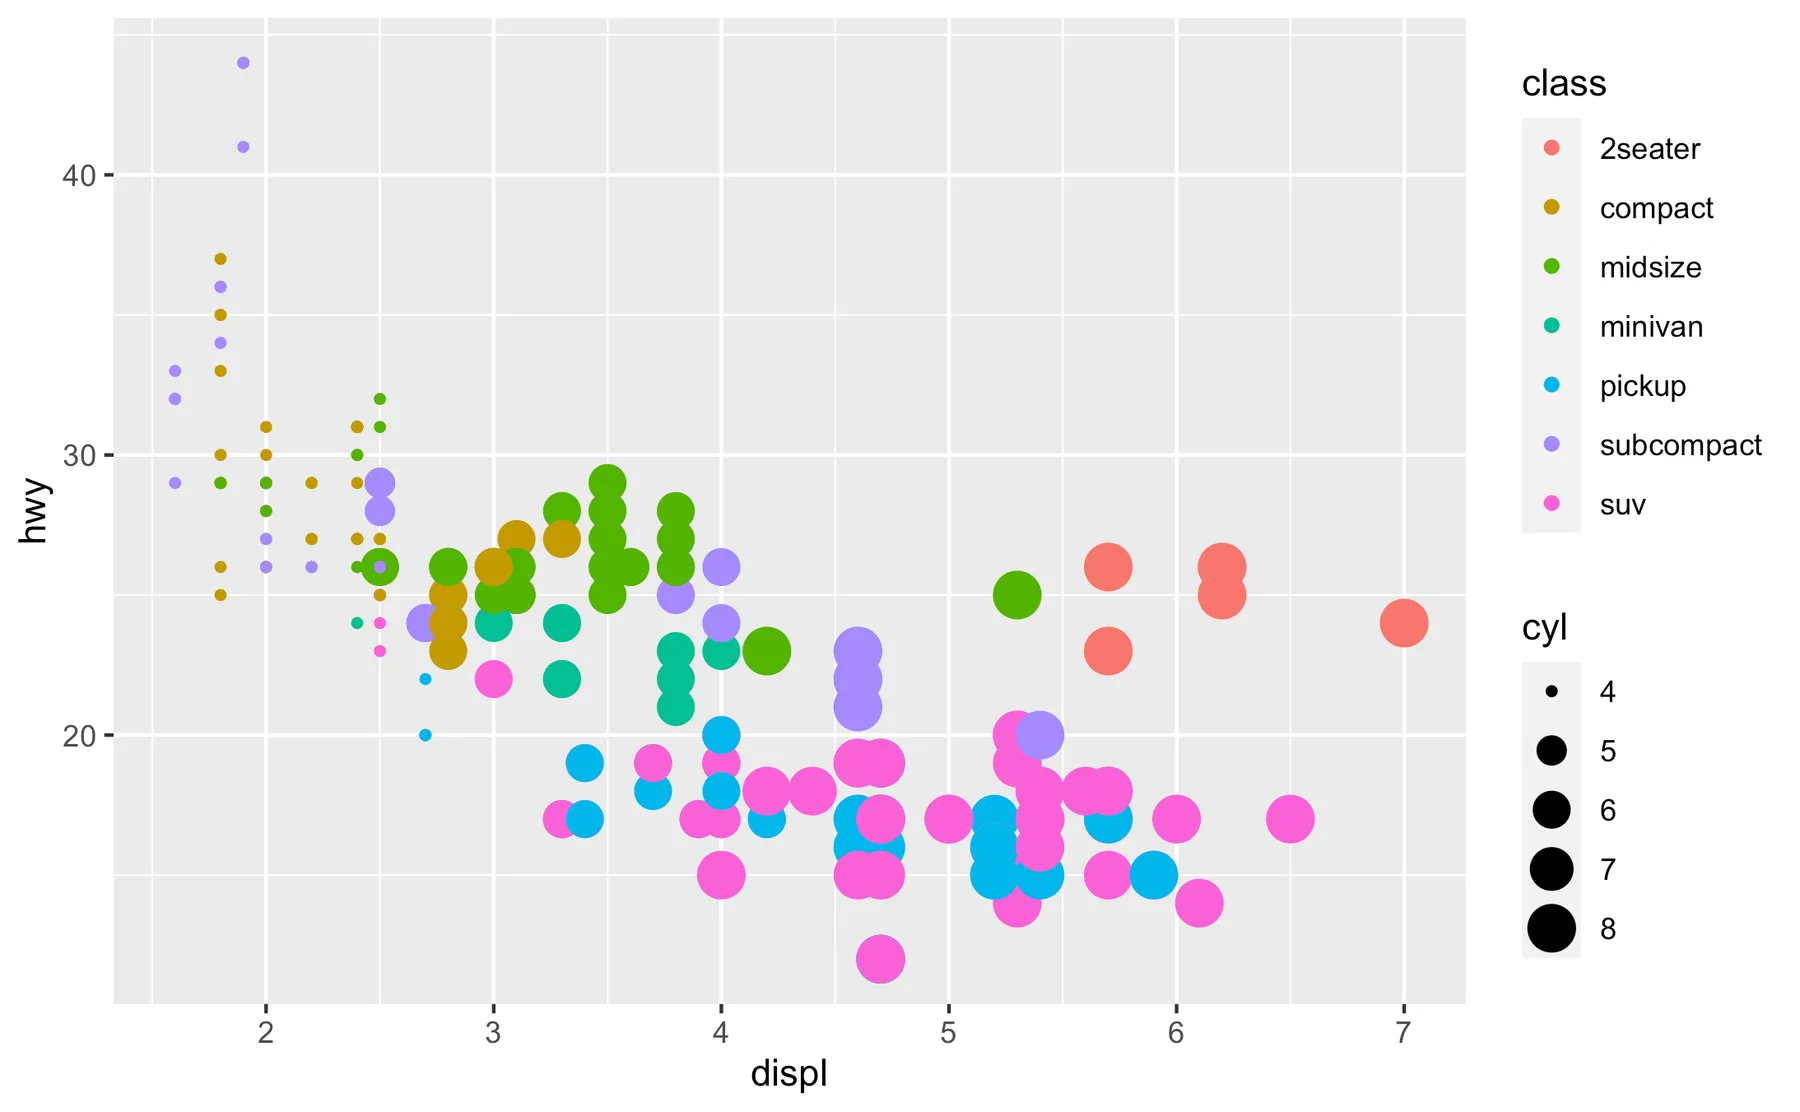
Det ser ut til at det finnes en sterk sammenheng mellom antall sylindre og størrelsen på motoren (displ) samt drivstofforbruket (hwy). Biler med lavt drivstofforbruk har liten motor (displ) og færre sylindre (cyl). Merk også at det finnes en størrelsesskala til høyre for grafen, og den har overskriften cyl, som vi mappet til size i aes(). I dette tilfellet fungerer det utmerket å mappe cyl til size, fordi cyl er en numerisk variabel som kan rangeres.
Shape (form) og alpha (gjennomsiktighet, transparency)
I aes() kan man også angi alpha, som styrer punktenes gjennomsiktighet, og shape, som styrer punktenes form. Du kan angi en bestemt verdi for alpha (f.eks. alpha=0.5 for 50 % gjennomsiktighet) og shape (f.eks. shape=2 for å bruke trekanter i stedet for punkter). Alternativt mapper du en kolonne til alpha og shape, noe som gjør at ggplot() mapper dette automatisk. Vi prøver nå å mappe cyl til alpha:
ggplot(data=mpg, aes(x = displ,
                     y = hwy,
                     color=class,
                     size=cyl,
                     alpha=cyl)) +
  geom_point()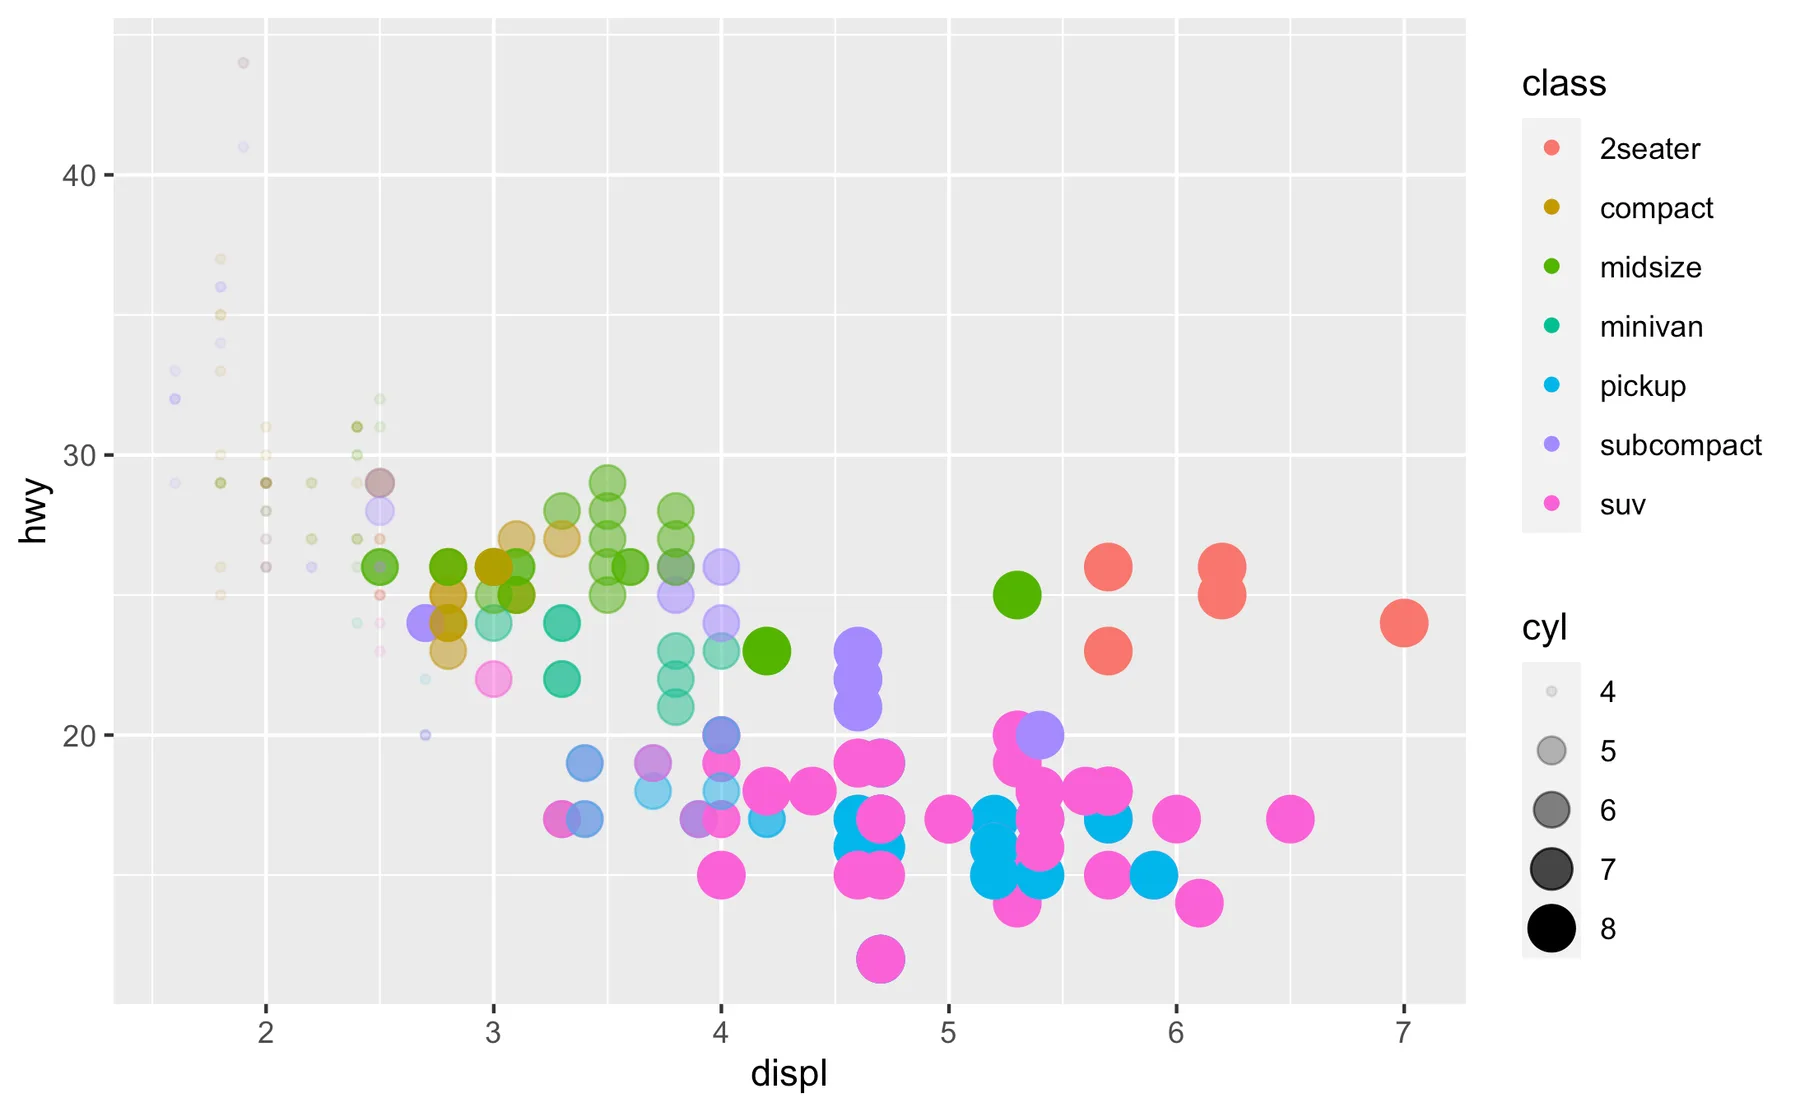
Merk ovenfor at cyl nå brukes til å mappe punktenes størrelse og gjennomsiktighet, og dette fremgår også av forklaringen til høyre for grafen. Vi prøver nå å mappe shape til cyl:
Vi prøver nå å mappe class til shape. Vi justerer også størrelsen på punktene ved å angi size=3, slik:
ggplot(data=mpg, aes(x = displ,
                     y = hwy,
                     color=class,
                     shape=class)) +
  geom_point(size=3)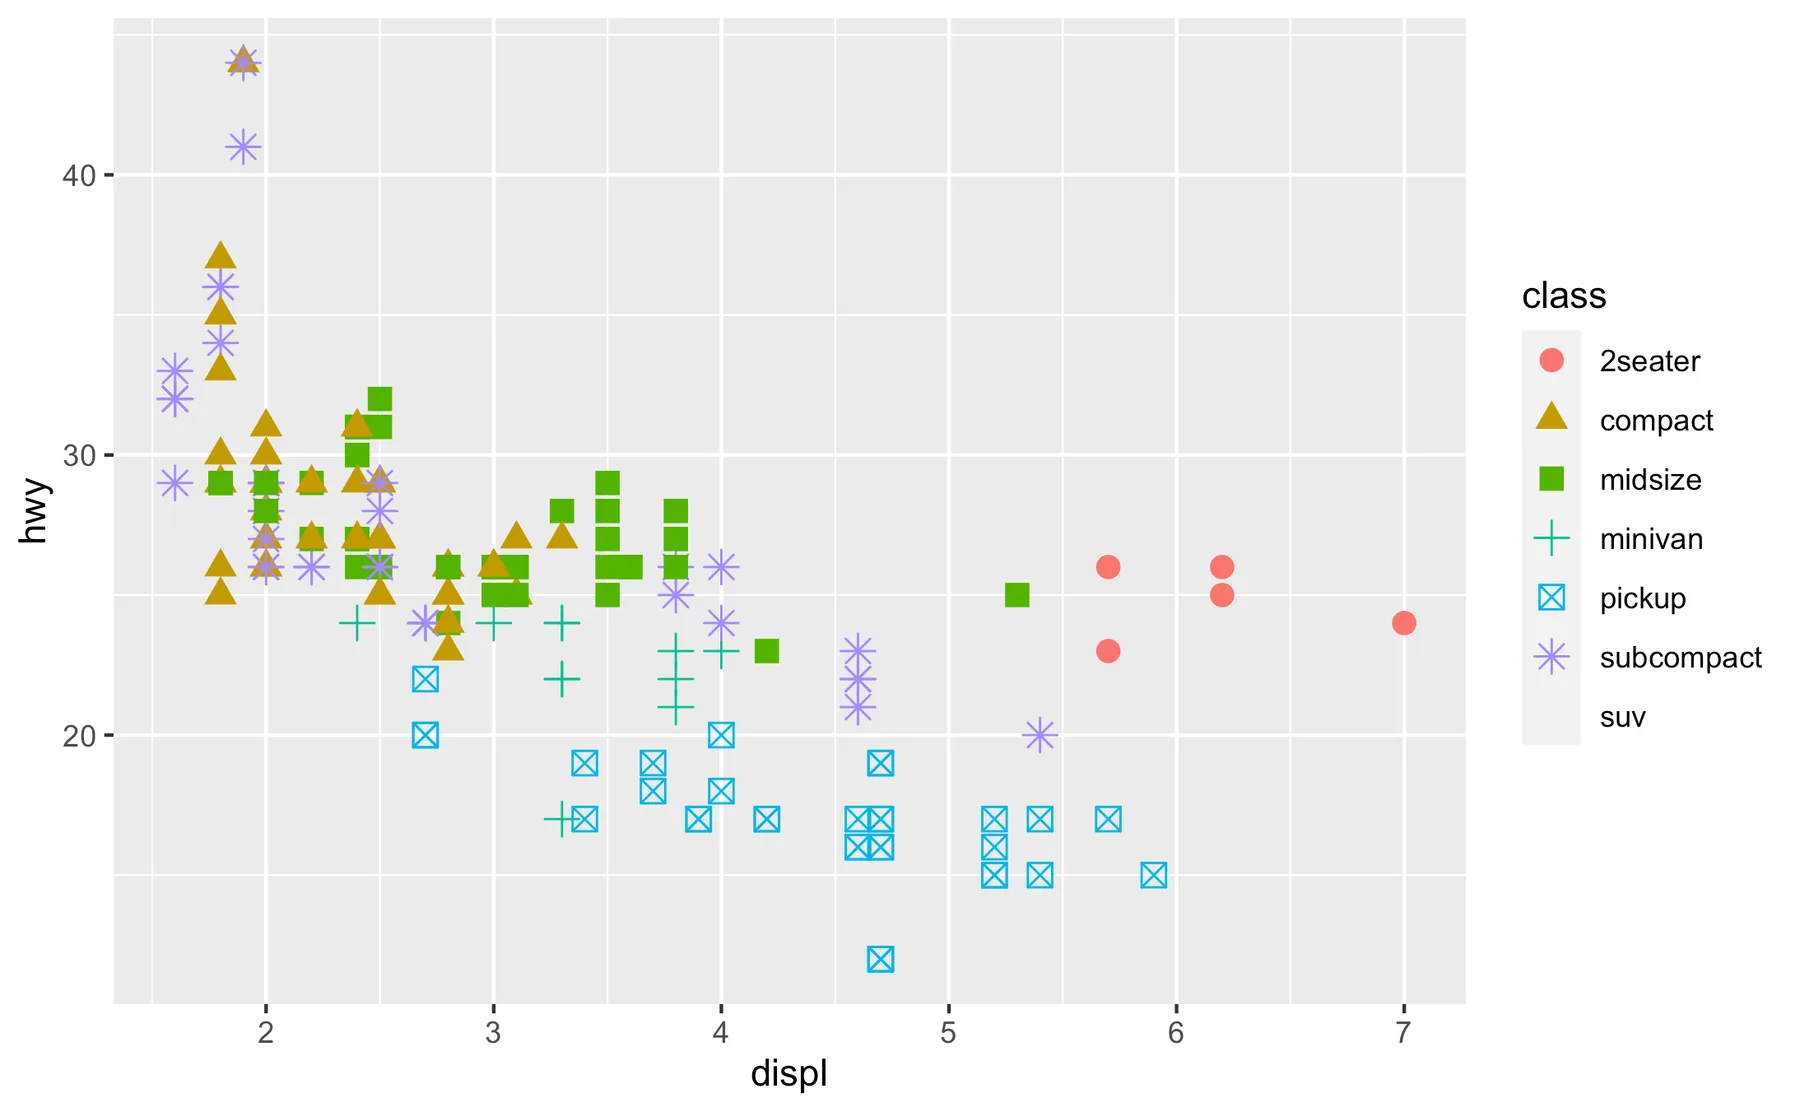
Du kan vise alle punktene med en bestemt shape (form). Det gjøres ved å angi shape manuelt i geom_point(). Du skal ikke angi dette i aes(), men som et argument i geom_point(), som i følgende eksempel der alle punktene får shape=2, som er trekanter:
ggplot(data=mpg, aes(x = displ,
                     y = hwy,
                     color=class)) +
  geom_point(size=3, shape=2)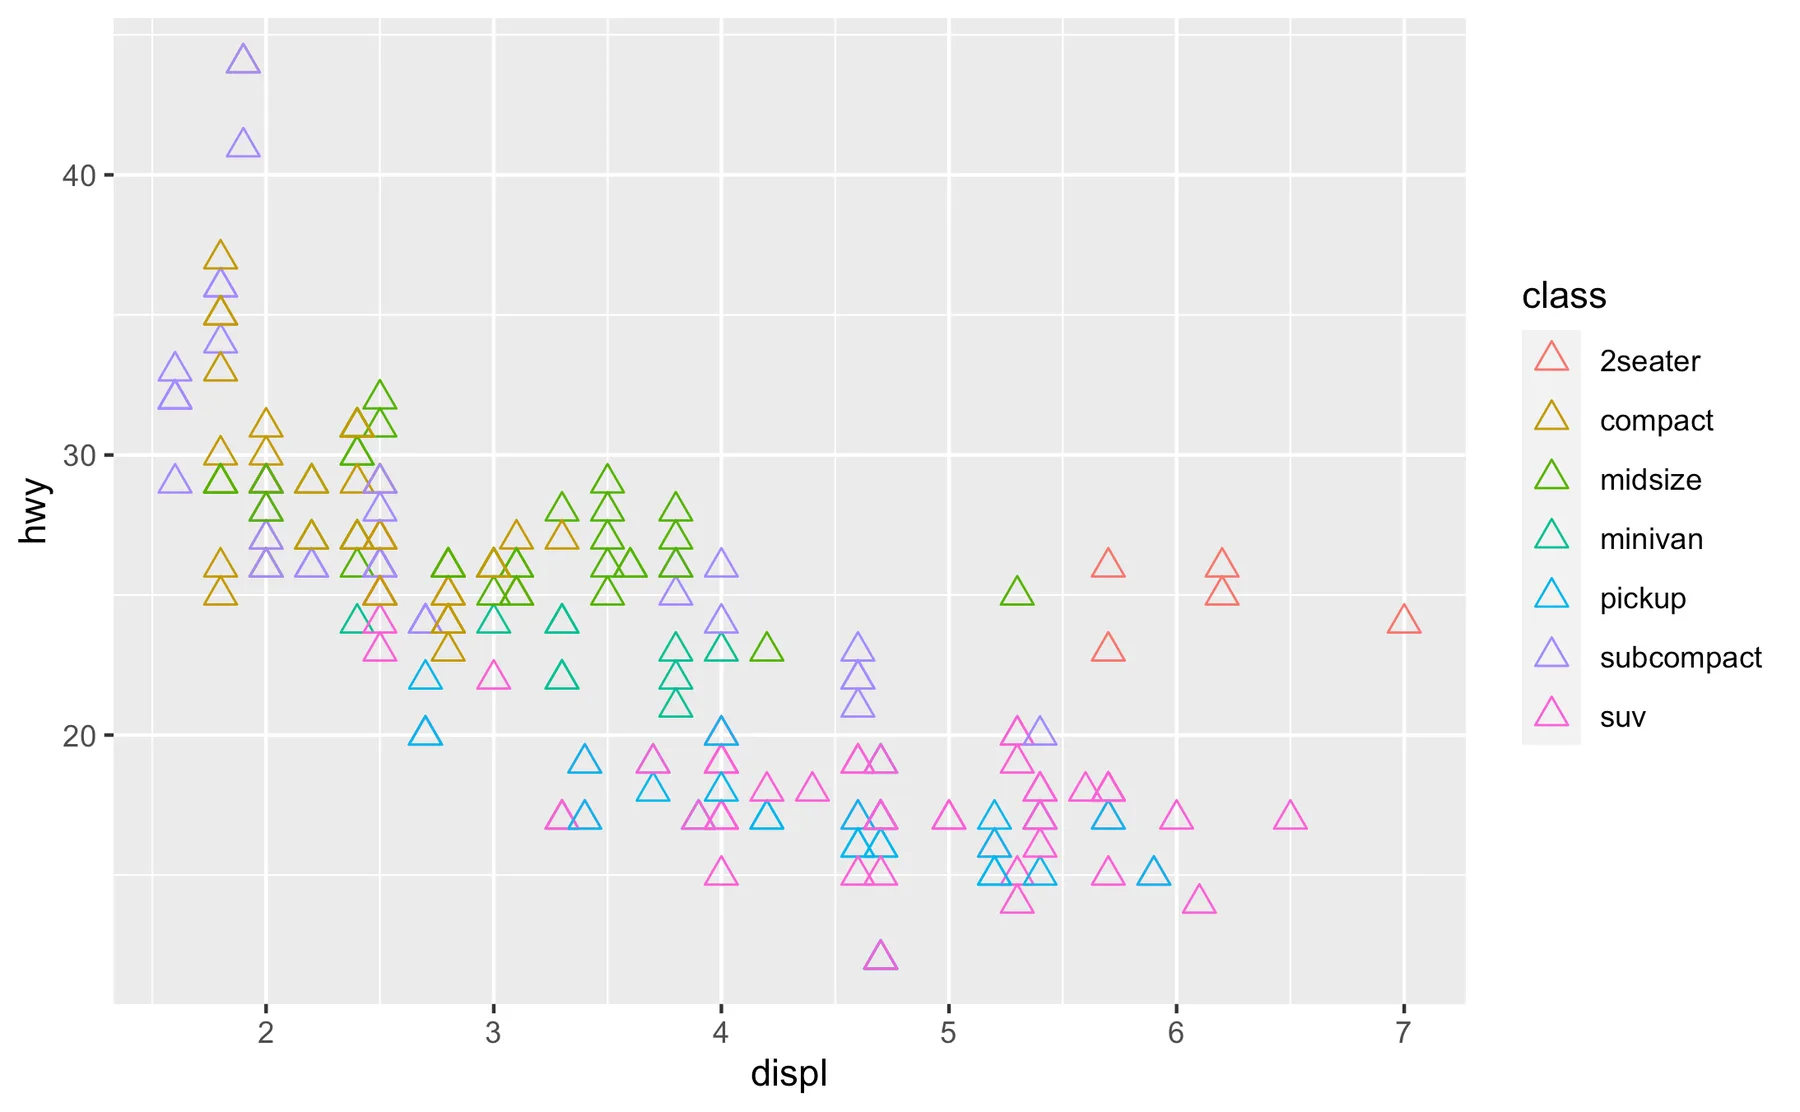
Du kan angi shape, color og size ved å mappe disse egenskapene til variabler i din data frame, eller ved å angi bestemte verdier. Følgende gjelder for shape, color og size:
| Egenskap | Funksjon | Kan angis med en variabel | Kan angis manuelt |
|---|---|---|---|
shape |
Endrer formen på geom_point(). |
Ja. Gir hvert nivå (maks 6 ulike) en egen form. Eksempel: shape=class |
Ja. Eksempel: shape=2 |
size |
Endrer størrelsen på geom_point(). Angis i millimeter (mm). |
Nei. | Ja, med numerisk verdi. |
color |
Endrer fargen på geom_point(). |
Ja. Eksempel: shape=class |
Ja, med tekststreng eller HEX-kode. Eksempel tekststreng: color="blue" Eksempel HEX: color="#33333" |
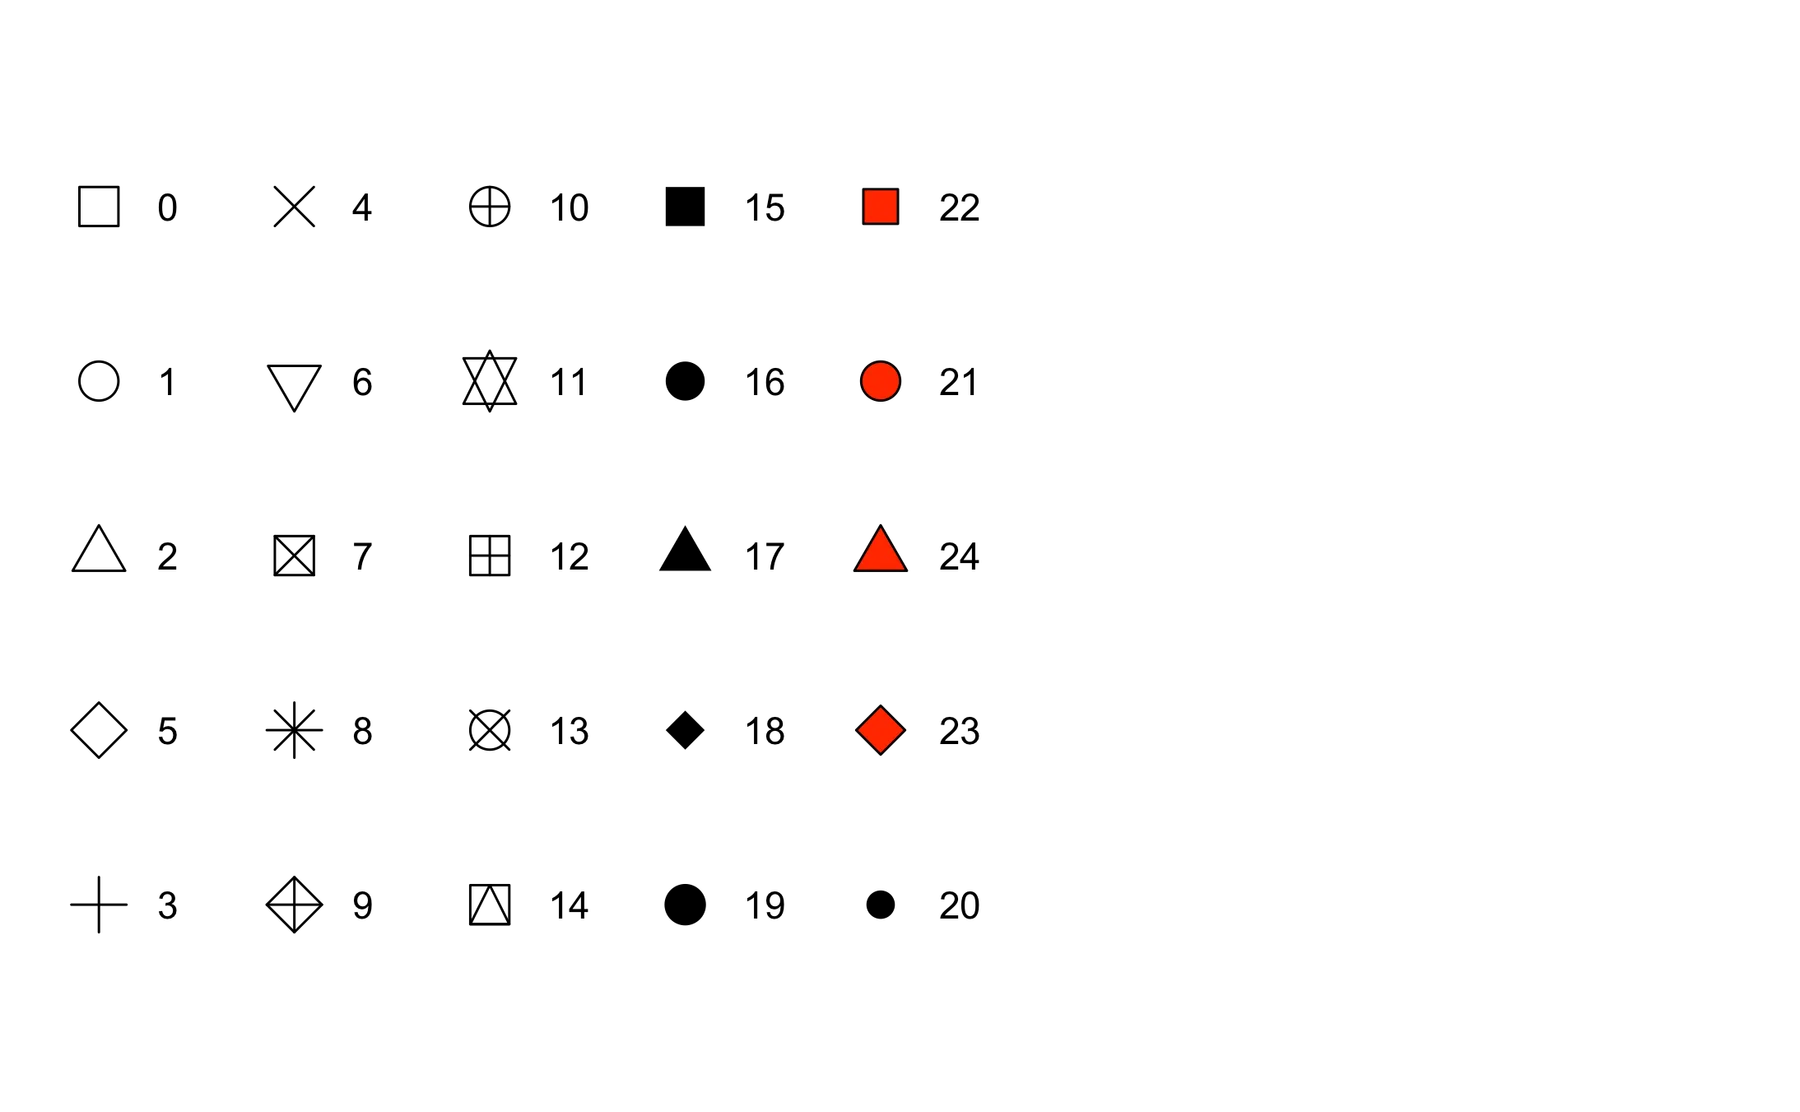
Når det gjelder shape, viser huskelappen nedenfor formene og det tilhørende tallet.