
Strenger og regular expressions (regex)
Strenger er informasjon som består av tall, symboler og/eller bokstaver. En streng kan altså være en blanding av disse komponentene. I R defineres en streng ved hjelp av anførselstegn. Nedenfor defineres en streng som lagres i objektet my_string:
## Lagre en streng i et objekt
my_string <- "Detta är en sträng!"

## Skriv ut objektet
my_string[1] "Detta är en sträng!"Før vi går videre, skal vi aktivere pakken tidyverse, som inkluderer pakken stringr, som inneholder alle funksjonene som trengs for å håndtere strenger.
library(tidyverse)── Attaching packages ─────────────────────────────────────── tidyverse 1.3.2 ──
ggplot2 3.3.6 purrr 0.3.4
tibble 3.1.8 dplyr 1.0.10
tidyr 1.2.0 stringr 1.4.1
readr 2.1.2 forcats 0.5.1
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
dplyr::filter() masks stats::filter()
dplyr::lag() masks stats::lag()Flere strenger kan defineres med funksjonen [c()](https://rdrr.io/r/base/c.html), som kombinerer flere elementer til en vektor:
my_string <- c("Detta är en sträng!", "Detta är en annan sträng")

my_string[1] "Detta är en sträng!" "Detta är en annan sträng"Strengene ovenfor ble laget med doble anførselstegn (" "). Strenger kan bestå av ett enkelt tegn, eller inneholde hele bøker. Nedenfor defineres tre strenger: en kort streng (my_string_short), en streng som bare består av tall (my_string_numbers) og en lang streng (my_string_long):
## En kort streng
my_string_short <- c("Detta är en sträng!")

## En streng med bare tall
my_string_numbers <- c("123")

## En lang streng
my_string_long <- c("Salvador Domingo Felipe Jacinto Dalí i Domènech, 1:e markis av Púbol, född 11 maj 1904 i Figueres, Katalonien, Spanien, död 23 januari 1989 i Figueres, var en katalansk (spansk) surrealistisk konstnär. Dalí är mest känd för sina bisarra, absurda och drömska målningar, influerade av bland annat Freuds psykoanalys, Einsteins relativitetsteorier och renässansmåleri.[2][3] Ett av hans mest kända verk, Minnets envishet, blev klart 1931. Utöver måleri omfattade Dalís praktik även film, skulptur, fotografi och text. Han samarbetade med Walt Disney kring den Oscars-nominerade tecknade kortfilmen Destino, som släpptes postumt 2003. Han samarbetade också med Alfred Hitchcock i arbetet med filmen Trollbunden.")
Strenger og anførselstegn
Bruk doble anførselstegn ("") når du definerer en streng. Bruk bare enkle anførselstegn ('') for å definere en streng som inneholder doble anførselstegn.
En streng kan også lages med enkle anførselstegn (' '):
my_string <- c('Detta är en sträng!')
my_string[1] "Detta är en sträng!"Det anbefales likevel at strenger defineres med doble anførselstegn.
La oss prøve å definere en streng som inneholder anførselstegn:
my_string <- c("Han fick smeknamnet "Yoggi" men det gillade han inte")
my_stringError: unexpected symbol in "my_string <- c("Han fick smeknamnet "Yoggi"Det oppstår Error (feil) fordi R ikke vet hvordan anførselstegnene rundt Yoggi ("Yoggi") skal tolkes. Dette skyldes at anførselstegn har en spesiell betydning i strenger, nemlig å markere hvor strengen starter og slutter. R tror at strengen er slutt ved det første anførselstegnet foran bokstaven Y ("Y..), men siden det anførselstegnet etterfølges av flere bokstaver, oppstår det Error. Vi trenger derfor en metode for å fortelle R at anførselstegnene i strengen faktisk er en del av strengen, i stedet for et tegn med en spesiell funksjon! Det finnes flere tegn (., *, ] osv.) som kan forårsake slik tvetydighet, slik at det oppstår Error.
For å unngå denne tvetydigheten brukes omvendt skråstrek (\, backslash*). Backslash forteller R at anførselstegnene rundt “Yoggi” skal betraktes som en del av strengen. Det betyr at **backslash (\) brukes til å oppheve (eng. escape) anførselstegnets spesielle funksjon*. La oss prøve å lese inn strengen en gang til, men denne gangen med \ foran hvert anførselstegn i strengen:
my_string <- c("Han fick smeknamnet \"Ylle\" men det gillade han inte")Det fungerte uten Error! La oss skrive ut strengen:
my_string[1] "Han fick smeknamnet \"Ylle\" men det gillade han inte"Legg merke til at backslash (\) vises når strengen skrives ut. Grunnen til dette er at R viser hvor escape er brukt. Hvis du vil skrive ut (*eng*. print) en streng uten escape (\), bruker du funksjonen [writeLines()](https://rdrr.io/r/base/writeLines.html):
writeLines(my_string)Han fick smeknamnet "Ylle" men det gillade han intePå samme måte må enkle anførselstegn ha \ foran seg for å unngå tvetydighet:
my_string <- c('Han fick smeknamnet \'Ylle\' men det gillade han inte')
writeLines(my_string)
Han fick smeknamnet 'Ylle' men det gillade han inteNår det gjelder anførselstegn, kan man også unngå tvetydighet ved å bruke doble anførselstegn for å definere strengen og enkle anførselstegn inne i strengen, eller omvendt. Her er et eksempel:
my_string1 <- c("Han fick smeknamnet 'Svurre' men det gillade han inte")
writeLines(my_string)
Han fick smeknamnet 'Svurre' men det gillade han intemy_string2 <- c('Han fick smeknamnet "Svurre" men det gillade han inte')
writeLines(my_string)Han fick smeknamnet 'Svurre' men det gillade han inteTabellen nedenfor viser andre spesialtegn og formateringer der escape trengs for å unngå tvetydighet:
| Escape character | Betydning |
|---|---|
| \n | newline |
| \r | carriage return |
| \t | tab |
| \b | backspace |
| \a | alert (bell) |
| \f | form feed |
| \v | vertical tab |
| \\ | backslash \ |
| \’ | ASCII apostrophe ’ |
| \” | ASCII quotation mark ” |
| \` | ASCII grave accent (backtick) ` |
| \nnn | character with given octal code (1, 2 or 3 digits) |
| \xnn | character with given hex code (1 or 2 hex digits) |
| \unnnn | Unicode character with given code (1--4 hex digits) |
| \Unnnnnnnn | Unicode character with given code (1--8 hex digits) |
8.1 Stringr og regular expressions (regex)
Pakken stringr inneholder alle nødvendige funksjoner for å håndtere strenger i R. Nedenfor gjennomgås de viktigste funksjonene, og deretter hvordan regular expressions kan brukes til å lage kraftige matchinger i strenger. De fleste funksjonene i stringr har prefikset str_. La oss begynne med å definere en streng:
my_string <- c("Det är roligt att lära sig R!")8.1.1 Identiske strenger
Vi lager nå to vektorer som består av en identisk streng (“Sommarlov”) og bruker funksjonen [identical()](https://rdrr.io/r/base/identical.html) for å avgjøre om de er identiske:
word_1 <- "Sommarlov"
word_2 <- "Sommarlov"
identical(word_1, word_2)[1] TRUESom med mange andre R-funksjoner kan du bruke utropstegn (!) foran funksjonsnavnet for å få motsatt effekt. Hvis funksjonen [identical()](https://rdrr.io/r/base/identical.html) avklarer om to strenger er identiske, så avklarer [identical()](https://rdrr.io/r/base/identical.html) om strengene ikke er identiske. Vi undersøker nå om ordene ikke er identiske:
!identical(word_1, word_2)[1] FALSE8.1.2 Endre mellom store og små bokstaver
Med funksjonene [str_to_lower()](https://stringr.tidyverse.org/reference/case.html), [str_to_sentence()](https://stringr.tidyverse.org/reference/case.html), [str_to_title()](https://stringr.tidyverse.org/reference/case.html) og [str_to_upper()](https://stringr.tidyverse.org/reference/case.html) i pakken stringr kan du endre bruken av store og små bokstaver i en streng slik:
## Konverterer bokstaver til små bokstaver
str_to_lower(my_string)[1] "det är roligt att lära sig r!"## Konverterer strengen til setningsform
str_to_sentence(my_string)[1] "Det är roligt att lära sig r!"## Konverterer strengen til tittelform
str_to_title(my_string)[1] "Det Är Roligt Att Lära Sig R!"## Konverterer bokstaver til store bokstaver
str_to_upper(my_string)[1] "DET ÄR ROLIGT ATT LÄRA SIG R!"8.1.3 Lengden på en streng
Lengden (antall tegn) på en streng kan beregnes med [str_length()](https://stringr.tidyverse.org/reference/str_length.html):
str_length(my_string)[1] 29Som alle andre funksjoner i stringr er [str_length()](https://stringr.tidyverse.org/reference/str_length.html) vektorisert, noe som betyr at hvis du bruker den på en vektor, gjøres beregningen på hvert element i vektoren:
str_length(c("Hej", "Ja", "Kanske"))[1] 3 2 68.1.4 Posisjoner i strenger
Vi kan identifisere hvor i strengen et bestemt tegn befinner seg. Dette gjøres med funksjonen [str_locate()](https://stringr.tidyverse.org/reference/str_locate.html). Følgende eksempel beregner i hvilken posisjon bokstaven “t” finnes, hvis den forekommer:
my_string <- c("Det är roligt att lära sig R!")
str_locate(my_string, 't')
start end
[1,] 3 3Ifølge resultatet ble “t” matchet mellom posisjon 3 og 3, noe som betyr at bokstaven er det tredje tegnet i strengen. Legg likevel merke til at det finnes flere “t” i strengen, og for å identifisere alle disse må vi bruke funksjonen [str_locate_all()](https://stringr.tidyverse.org/reference/str_locate.html):
str_locate_all(my_string, 't')[[1]]
     start end
[1,]     3   3
[2,] 13 13
[3,] 16 16
[4,] 17 17Vi ser at det finnes totalt 4 “t”, og de forekommer som tegn 3, 13, 16 og 17.
8.1.5 Sortere strenger
For å sortere en character-vektor brukes funksjonen [str_sort()](https://stringr.tidyverse.org/reference/str_order.html):
my_names <- c('Benny', 'Adam', 'Caesar')
str_sort(my_names)[1] "Adam" "Benny" "Caesar"Nå lager vi en data frame med fornavn og etternavn. Heretter kommer vi til å bruke funksjoner fra pakken dplyr for å lage og endre kolonner.
## Lager fornavn
first_name <- c('Maria', 'Mohammed', 'Magnus')

## Lager etternavn
last_name <- c('Svensson', 'Ayman', 'Bentzel')

## Kombinerer til en tibble (data frame)
my_data <- tibble(first_name, last_name)

## Skriver ut vår data frame
my_data
## A tibble: 3 × 2
first_name last_name
<chr> <chr>
1 Maria Svensson
2 Mohammed Ayman
3 Magnus Bentzel8.1.6 Kombinere strenger
Vi slår sammen fornavn og etternavn til én streng med funksjonen [str_c()](https://stringr.tidyverse.org/reference/str_c.html). Funksjonen har argumentet sep, som angir hvilket tegn som skal skille strengene. Vi velger å skille strengene med et mellomrom.
Eksempel med base R (ikke dplyr):
my_data$full_name <- str_c(my_data$first_name,
                           my_data$last_name,
                           sep = " ")

my_data
## A tibble: 3 × 3
first_name last_name full_name
<chr> <chr> <chr>
1 Maria Svensson Maria Svensson
2 Mohammed Ayman Mohammed Ayman
3 Magnus Bentzel Magnus BentzelEksempel med dplyr:
my_data %>%
  mutate(full_name = str_c(first_name, last_name, sep = " "))
## A tibble: 3 × 3
first_name last_name full_name
<chr> <chr> <chr>
1 Maria Svensson Maria Svensson
2 Mohammed Ayman Mohammed Ayman
3 Magnus Bentzel Magnus BentzelVed å bruke dplyr får vi ren og enkel kode, uten å bruke $, [] eller lignende. Nye kolonner lages med funksjonen mutate().
Du kan lime sammen flere enn to strenger med [str_c()](https://stringr.tidyverse.org/reference/str_c.html):
a = "Hej"
b = "jag"
c = "heter"
d = "Adam"

str_c(a, b, c, d, sep = " ")[1] "Hej jag heter Adam"8.1.7 Telle antall matchinger i en streng
Med [str_count()](https://stringr.tidyverse.org/reference/str_count.html) kan vi beregne hvor mange ganger en bestemt streng eller et bestemt tegn forekommer i en streng. La oss sjekke hvor mange ganger bokstaven ‘m’ forekommer i fornavnene. Vi lager en ny variabel som vi kaller antal_m for dette:
my_data %>%
  mutate(antal_m = str_count(first_name, 'm'))
## A tibble: 3 × 4
first_name last_name full_name antal_m
<chr> <chr> <chr> <int>
1 Maria Svensson Maria Svensson 0
2 Mohammed Ayman Mohammed Ayman 2
3 Magnus Bentzel Magnus Bentzel 0R skiller mellom store og små bokstaver. Bokstaven m er ikke ekvivalent med bokstaven M. Vi prøver igjen med bokstaven M:
my_data %>%
  mutate(antal_m = str_count(first_name, 'M'))
## A tibble: 3 × 4
first_name last_name full_name antal_m
<chr> <chr> <chr> <int>
1 Maria Svensson Maria Svensson 1
2 Mohammed Ayman Mohammed Ayman 1
3 Magnus Bentzel Magnus Bentzel 18.1.8 Detektere strenger, tegn og symboler i strenger
Med funksjonen [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html) kan vi avgjøre om tall, bokstaver, symboler, tegn eller strenger forekommer i en streng. Funksjonen [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html) returnerer en boolsk verdi (TRUE, FALSE). Vi lager nå variabelen finns_m, som avklarer om bokstaven "m" finnes i strengen:
my_data %>%
  mutate(finns_m = str_detect(first_name, 'm'))
## A tibble: 3 × 4
first_name last_name full_name finns_m
<chr> <chr> <chr> <lgl>
1 Maria Svensson Maria Svensson FALSE
2 Mohammed Ayman Mohammed Ayman TRUE
3 Magnus Bentzel Magnus Bentzel FALSEMed funksjonene string_ends() og string_starts() kan man avgjøre om en streng begynner eller slutter med en bestemt streng. Vi sjekker om strengen begynner med M og slutter med s. Vi lager to nye variabler som angir dette:
my_data %>%
  mutate(starts_M = str_starts(first_name, 'M'),
         ends_s = str_ends(first_name, 's'))
## A tibble: 3 × 5
first_name last_name full_name starts_M ends_s
<chr> <chr> <chr> <lgl> <lgl>
1 Maria Svensson Maria Svensson TRUE FALSE
2 Mohammed Ayman Mohammed Ayman TRUE FALSE
3 Magnus Bentzel Magnus Bentzel TRUE TRUE8.1.9 Erstatte strenger og tegn
Erstatt hele eller deler av en streng med funksjonen [str_replace()](https://stringr.tidyverse.org/reference/str_replace.html). Nå erstatter vi bokstaven M med en asterisk (*):
my_data %>%
  mutate(new_first_name = str_replace(first_name, 'M', '*'))
## A tibble: 3 × 4
first_name last_name full_name new_first_name
<chr> <chr> <chr> <chr>
1 Maria Svensson Maria Svensson *aria
2 Mohammed Ayman Mohammed Ayman *ohammed
3 Magnus Bentzel Magnus Bentzel *agnusFunksjonen [str_replace()](https://stringr.tidyverse.org/reference/str_replace.html) erstatter bare den første forekomsten av mønsteret du søker etter. Bruk funksjonen [str_replace_all()](https://stringr.tidyverse.org/reference/str_replace.html) for å erstatte alle forekomster. Nedenfor erstatter vi alle m med *:
my_data %>%
  mutate(new_first_name = str_replace_all(first_name, 'm', '*'))
## A tibble: 3 × 4
first_name last_name full_name new_first_name
<chr> <chr> <chr> <chr>
1 Maria Svensson Maria Svensson Maria
2 Mohammed Ayman Mohammed Ayman Moha**ed
3 Magnus Bentzel Magnus Bentzel Magnus8.1.10 Erstatte NA med “NA”
Missing data er den engelske betegnelsen på informasjon som mangler. Som oftest brukes bare ordet missing for å vise til data som mangler. Missing betegnes med NA (Not Available) i R. Vi kan lage missing i en character-vektor ved å sette verdien til NA uten anførselstegn:
x <- c("abc", NA)
x[1] "abc" NALegg merke til at strengen “abc” er omgitt av anførselstegn for å vise at det er en streng. NA er derimot ikke omgitt av anførselstegn, fordi det er missing. Vi kan erstatte missing (NA) med strengen NA (“NA").
x <- c("abc", NA)
str_replace_na(x)[1] "abc" "NA"8.1.11 Trekke ut deler av strenger (substring)
Funksjonen [str_sub()](https://stringr.tidyverse.org/reference/str_sub.html) kan trekke ut deler av strenger. Funksjonen har argumentene start og end, som angir hvor uttrekket begynner og slutter. Her trekker vi ut første til andre posisjon:
x <- c("Sommarlov")
str_sub(string=x, start=1, end=2)[1] "So"Som vanlig kan vi angi verdier for argumentene string, start og end uten å oppgi argumentnavnene, forutsatt at vi angir verdiene i riktig rekkefølge:
x <- c("Sommarlov")
str_sub(x, 1, 2)[1] "So"Negative start og end betyr at uttrekket regnes fra slutten av strengen. Her trekker vi ut alle tegn fra det nest siste til det siste:
x <- c("Sommarlov")
str_sub(x, -2, -1)[1] "ov"Hvis du prøver å trekke ut mer enn det som finnes i strengen, vil [str_sub()](https://stringr.tidyverse.org/reference/str_sub.html) returnere så mye som mulig:
x <- c("Sommarlov")
str_sub(x, 1, 100)[1] "Sommarlov"8.2 Regular expressions (Regex)
I praksis kan du trenge å gjøre enda mer sofistikerte matchinger, og da er regular expressions uvurderlige. Regular expressions (regex) er en sekvens av tegn som søker etter et mønster i en streng.
Andre ressurser for regular expressions:
- https://www.regular-expressions.info/ gir detaljert informasjon om hvordan regular expressions fungerer.
- https://regex101.com er et interaktivt verktøy som lar deg teste regular expressions live for å se om de oppfører seg slik du forventer.
Regular expressions kan ved første øyekast virke kompliserte, men når du har forstått hvordan de fungerer, vil du se at de er ekstremt kraftige for å håndtere strenger. Ofte kreves det en del prøving før man har et fungerende regular expression, og for å se hvordan ditt regular expression matcher tegnene i en streng, finnes funksjonene [str_view()](https://stringr.tidyverse.org/reference/str_view.html) og [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html). Disse viser hvordan regular expressions matcher en streng. Funksjonene markerer den delen av strengen som matcher ditt regular expression. Vi bruker nå funksjonen for å se om vårt regular expression identifiserer bokstaven X i strengene nedenfor. Strengen som skal gjennomsøkes, angis i argumentet string, og mønsteret vi vil finne, angis i pattern:
my_strings <- c("Xxx", "Yyy", "Xxx")
str_view(string=my_strings, pattern='X')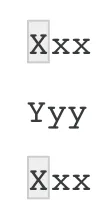
Den loddrette streken (|) betyr “eller”. Med den loddrette streken kan vi lete etter ulike tegn, og bare ett av disse trenger å matches. Nedenfor angir vi pattern='X|x', noe som betyr at vi leter etter X eller x.
my_strings <- c("Xxx", "xXx")
str_view(string=my_strings, pattern='X|x')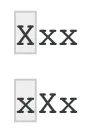
Som det fremgår ovenfor, ble bare første X eller x matchet, noe som skyldes at vi brukte [str_view()](https://stringr.tidyverse.org/reference/str_view.html). Funksjonen [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html) kan matche alle forekomster av en streng. Her er et eksempel:
my_strings <- c("Xxx", "xXx")
str_view_all(string=my_strings, pattern='X|x')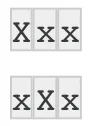
Med funksjonene [str_view()](https://stringr.tidyverse.org/reference/str_view.html) og [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html) kan du altså se hvordan et regular expression (regex) matcher en streng. Her følger et eksempel der vi bruker [str_view()](https://stringr.tidyverse.org/reference/str_view.html) for å undersøke om vårt regular expression kan matche H i begynnelsen av en streng. I regular expressions brukes ^ for å angi begynnelsen av en streng. For å matche H i begynnelsen av en streng skriver man derfor følgende:
str_view(string='Hej', pattern='^H')
Det ser ut til at vårt regular expression matcher H, som forventet.
Punktum (.) er et regular expression som matcher hvilket som helst tegn. Nedenfor tester vi om vi kan matche A. med noen av flere strenger i en vektor:
my_strings <- c("A", "AB", "ABC")
str_view(my_strings, 'A.')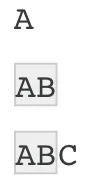
Den første strengen A matches ikke, fordi det ikke finnes noe tegn etter A. Strengene AB og ABC matches fordi de inneholder A etterfulgt av enda et tegn.
I neste eksempel har vi strengen X.X, som vi vil matche eksakt. Punktumet skal ikke behandles som et spesialtegn, men matches eksakt. Hvis det bare hadde vært en streng, kunne vi ha matchet på X\.X, men siden vi vil bruke regex for å matche, må vi legge til enda en backslash \, noe som skyldes at regex også bruker dette symbolet som escape-symbol. Derfor trengs følgende kode for å matche X.X eksakt:
Hvis du i stedet vil matche eksakt “A.C”, må escape (\) brukes, slik:
my_strings <- c("X.X")
str_view(my_strings, "X\\.X")
Hvordan matches \ i en streng med regular expression? Først og fremst må \ tolkes som et vanlig tegn (uten spesiell funksjon), noe som krever enda en \. Vi begynner med å skrive et fornavn og et etternavn adskilt med \\. Dette bør gi én \ når vi skriver det ut med [writeLines()](https://rdrr.io/r/base/writeLines.html):
my_string <- "Monika \\ Svensson"
writeLines(my_string)
Monika \ SvenssonVi trenger altså to backslash (\\) for å få en streng med én backslash. For å lage en regex trengs nå enda en backslash per backslash. For å matche en backslash i en streng trengs altså følgende kode:
str_view(my_string, "\\\\")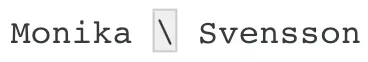
Det betyr at siden regular expressions og strenger bruker samme escape-symbol (\), trengs doble escapes når du bruker regular expressions for spesielle tegn og symboler. Det er mulig å unngå escape på selve tegnet og bare angi escape for regular expression ved å bruke [raw()](https://rdrr.io/r/base/raw.html). Dette står for raw vectors,
str_view(my_string, r"(\\)")For å matche en asterisk (*) gjelder samme prinsipp:
str_view(string=c("abc", "a.c", "a*c", "a c"), pattern="\\*")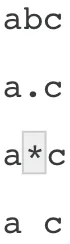
Det finnes flere regular expressions for å matche i strenger, og disse kan kombineres. De er som følger:
| Sequence | Matches |
|---|---|
. |
Any character except newline |
[xyz] |
Any character listed between the brackets (x, y, and z in this example) |
[a-z] |
Any character between a and z, inclusive |
[^xyz] |
The opposite of [xyz] |
\d |
ASCII digits (0 through 9, inclusive) |
\D |
Anything except ASCII digits |
\s |
ASCII spaces (space, tab, newline, carriage return, form feed) |
\S |
Anything except ASCII spaces |
\w |
The same as [0-9A-Za-z_] |
\W |
Anything except the characters matched by \w |
[[:alnum:]] |
The same as [0-9A-Za-z] |
[[:alpha:]] |
The same as [A-Za-z] |
[[:ascii:]] |
Any ASCII character |
[[:blank:]] |
ASCII tab or space |
[[:cntrl:]] |
ASCII/Unicode control characters |
[[:digit:]] |
The same as [0-9] |
[[:graph:]] |
All “graphical” (printable) ASCII characters |
[[:lower:]] |
The same as [a-z] |
[[:print:]] |
The same as [[:graph:]] |
[[:punct:]] |
The same as [!-/:-@[-`{-~] |
[[:space:]] |
The same as [\t\n\v\f\r ] |
[[:upper:]] |
The same as [A-Z] |
[[:word:]] |
The same as \w |
[[:xdigit:]] |
The same as [0-9A-Fa-f] |
\pN |
Unicode character class by using single-letter class names (“N” in this example) |
\p{Greek} |
Unicode character class by unicode name (“Greek” in this example) |
\PN |
The opposite of \pN |
\P{Greek} |
The opposite of \p{Greek} |
xy |
x followed immediately by y |
x|y |
either x or y, preferring x |
x* |
zero or more x, preferring more |
x*? |
zero or more x, preferring fewer |
x+ |
one or more x, preferring more |
x+? |
one or more x, preferring fewer |
x? |
zero or one x, preferring one |
x?? |
zero or one x, preferring zero |
x{n,m} |
between n and m repetitions of x, preferring more |
x{n,m}? |
between n and m repetitions of x, preferring fewer |
x{n,} |
at least n repetitions of x, preferring more |
x{n,}? |
at least n repetitions of x, preferring fewer |
x{n} |
exactly n repetitions of x |
(x) |
unnamed capture group for sub-pattern x |
(?P<name>x) |
named capture group, named name, for sub-pattern x |
(?:x) |
non-capturing sub-pattern x |
\* |
Literal * for any punctuation character * |
\Q...\E |
Literal ... for any text ... as long as it does not include literally \E |
8.3 Ankre (^, $)
Det finnes også regular expressions som angir hvor matchinger skal skje. De vanligste symbolene er ^, som angir at matchingen skal skje i begynnelsen av en streng, og $, som angir at matchingen skal skje på slutten av strengen.
| Sequence | Matches |
|---|---|
^ |
At the beginning of the given string |
$ |
At the end of the given string |
\A |
At the beginning of the given string |
\z |
At the end of the given string |
\b |
At an ASCII word boundary (transition between \w and either \W, \A or \z, or vice-versa) |
\B |
Not at an ASCII word boundary |
8.3.1 Character set (class)
Et character set er en liste over tegn som skal matches. Listen angis i []. For å matche på bokstavene a, b eller c brukes følgende character set: [abc]. Character set er en fordel fordi man slipper å angi escape (\) for regular expression-symboler. Du trenger ikke escape for følgende symboler: $ . | ? * + ( ) [ {. Det betyr at du kan skrive disse symbolene og matche på dem direkte i et character set (uten å angi escape). For å matche på ., , a b eller c brukes følgende character set: [.*abc]
Det finnes likevel symboler som har en spesiell funksjon også inne i et character set, og disse er som følger:
]^negerer listen.[^abc]matcher alt unntatt a, b og c.[a-zA-Z0-9]matcher alle små bokstaver, store bokstaver og tall
-definerer et intervall som følger alfabetisk eller numerisk rekkefølge.- Eksempel:
[a-d]matcher bokstavene a, b, c eller d. - Eksempel:
[0-4]matcher tallene 0, 1, 2, 3, 4
- Eksempel:
\brukes til å escape],^og-i et character set.[a\\-c]matchera-c.[\^\-]matcher^-.
Nå matcher vi strenger som begynner med a og slutter med b, og som mellom disse har enten en asterisk (*) eller bokstaven b:
str_view(c("abc", "a.c", "a*c", "a c"), "a[*b]c")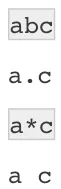
Legg merke til at vi klarte å matche asterisken (*) uten å bruke \\, noe som forklares med at vi i stedet brukte [], som kalles character class. La oss prøve igjen, men nå bytter vi ut første a med hvilket som helst tegn (.):
str_view(c("abc", "a.c", "a*c", "a c"), ".[*]c")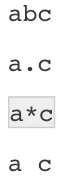
For å matche på mellomrom kan man bruke et vanlig mellomrom, med eller uten character class:
str_view(string=c("a c", "a.c", "a*c"), pattern="a[ ]c")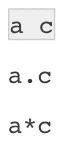
str_view(string=c("a c", "a.c", "a*c"), pattern="a c")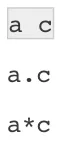
8.3.2 Alternerende matching
Du kan matche på flere alternativer ved å bruke den loddrette streken (|), slik:
str_view(c("a", "b", "c", "d"), "a|b")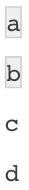
Du kan matche på flere enn to alternativer:
str_view(c("a", "b", "c", "d"), "a|b|c")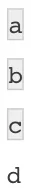
Hvis du matcher inne i et ord, trengs parenteser, slik:
str_view(c("glad", "glöd"), "gl(a|ö)d")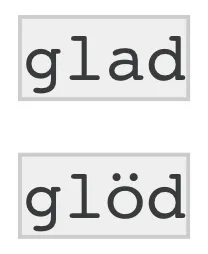
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")

## Starter ordet med bokstaven S?
str_detect(my_words, "^S")[1] TRUE FALSE FALSE FALSE## Hvor mange ord slutter på bokstaven i eller r?
str_detect(my_words, "[ir]$")[1] FALSE TRUE TRUE FALSEstr_subset(my_words, "x$")character(0)8.3.3 Negere matching
I stedet for å finne alle strenger som inneholder et bestemt symbol, kan vi negere matchingen. Dette kan gjøres ved å bruke utropstegn (!) foran [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html). Utropstegn (!) betyr “omvendt” eller “ikke”. Det betyr at !str_detect() angir at en streng ikke kan matches. La oss teste:
## Hvilke ord begynner ikke med S?
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")
!str_detect(my_words, "^S")[1] FALSE TRUE TRUE TRUEDu kan også negere matching ved hjelp av character class. Dette gjøres ved å begynne character class med ^ . Med følgende kode identifiseres ord som ikke begynner med S:
## Hvilke ord begynner ikke med S?
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")
str_detect(my_words, "^[^S]")[1] FALSE TRUE TRUE TRUE8.4 Gjentatt matching
Vi kan kontrollere antall ganger en streng kan matches med følgende tegn:
my_string <- "AAAAAA"

str_view(my_string, "AA?")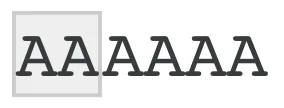
str_view(my_string, "AA+")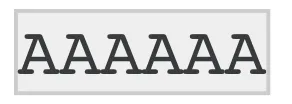
str_view(my_string, "AA*")Med klammeparenteser kan du angi hvor mange ganger en matching skal skje:
{n}: n antall ganger{n,}: n eller flere ganger{,m}: maksimalt m ganger{n,m}: mellom n og m ganger
str_view(my_string, "A{2}")str_view(my_string, "A{2,}")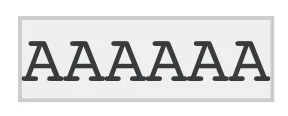
str_view(my_string, "A{2,3}")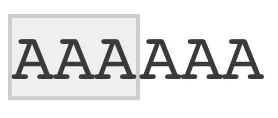
8.4.1 Shorthand character classes
Det finnes character sets som er forkortet fordi de brukes så ofte. Disse er som følger:
\d: matcher hvilket som helst siffer\D: matcher alt som ikke er et siffer\s: matcher alle mellomrom (f.eks. mellomrom, tab, linjeskift);\S: matcher matcher alt som ikke er mellomrom\w: matcher alle sifre og bokstaver\W: matcher alt som ikke er siffer eller bokstav
I regular expressions skal de angis med en ekstra backslash. For \d blir det altså \\d.
La oss matche alle sifre og deretter alt som ikke er sifre:
str_view_all("Hej! 123456 @ # %", "\\d")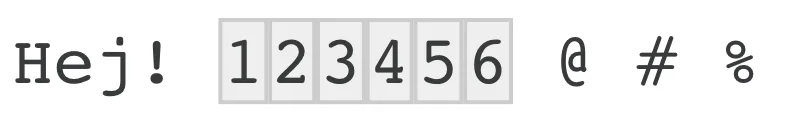
str_view_all("Hej! 123456 @ # %", "\\D")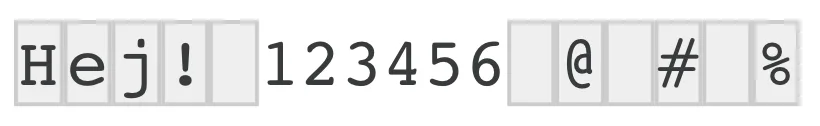
Match alle bokstaver og sifre, og deretter det motsatte.
str_view_all("Hej! 123456 @ # %", "\\w")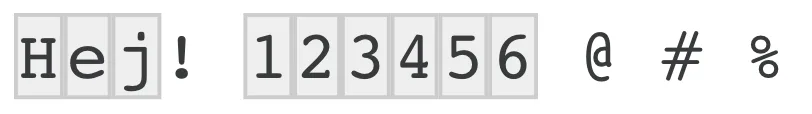
str_view_all("Hej! 123456 @ # %", "\\W")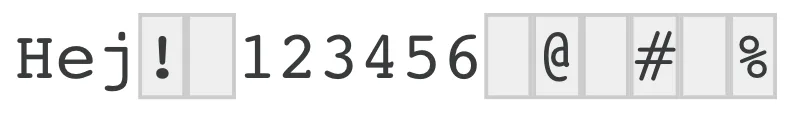
Match alle mellomrom, og deretter det motsatte.
str_view_all("Hej! 123456 @ # %", "\\s")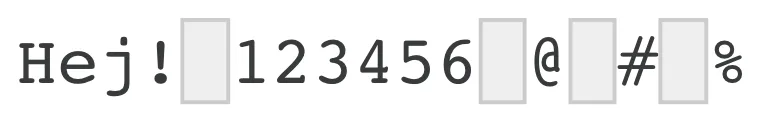
str_view_all("Hej! 123456 @ # %", "\\S")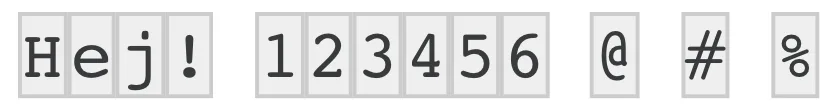
Match alle sekvenser med 5 bokstaver eller sifre, eller 2 sifre:
str_view_all("Hej jag heter Maggi och har telefonnummer 123456", "\\w{5}|\\d{2}")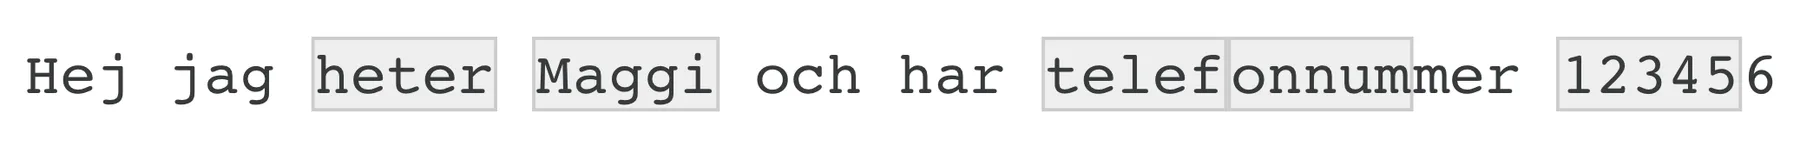
8.4.2 Operatorprioritet
Ved matematiske beregninger finnes det en prioritering av operander. Multiplikasjon går foran addisjon og subtraksjon. Beregningen 1*2+3 vil bli beregnet som (1*2)+3 fordi multiplikasjon prioriteres. Også for regular expressions finnes det prioriteringer. Kvantifikatorer (for eksempel +) prioriteres høyere enn alternering (|). Hvis et regular expression gir et uventet resultat, kan prioriteringen trenge å tydeliggjøres ved hjelp av parenteser. Her er et eksempel:
## Mindre tydelig regular expression
str_view("Jag hittade en vattenkanna", "an+")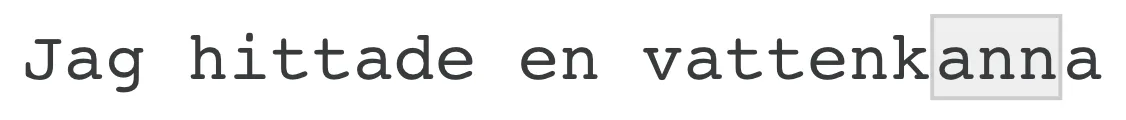
## Tydeligere regular expression
str_view("Jag hittade en vattenkanna", "a(n+)")
8.4.3 Boolske matchinger og betingelser
Du kan bruke den loddrette streken og & som vanlig også med strenger. Det betyr at disse to kommandoene er ekvivalente:
## Lag en vektor med ord
my_words <- c("hej", "bra", "ja", "kanske", "lite", "mycket", "troligen", "sannolikt", "utmärkt")

## Identifiser alle ord som inneholder "a" eller "b"
my_words[str_detect(my_words, "a") | str_detect(my_words, "b")][1] "bra" "ja" "kanske" "sannolikt"## Identifiser alle ord som inneholder "a" eller "b"
my_words[str_detect(my_words, "a|b")][1] "bra" "ja" "kanske" "sannolikt"Du kan på lignende måte lage andre nyttige betingelser:
## Identifiser alle ord som inneholder "a" og "n" og "k"
my_words[str_detect(my_words, "a") & str_detect(my_words, "n") & str_detect(my_words, "k")][1] "kanske" "sannolikt"