
5.1 Funksjoner i R
Standardinstallasjonen av R inneholder mange funksjoner for ulike oppgaver, fra enkle matematiske beregninger til kompliserte statistiske modeller og grafer. Noen funksjoner er enkle å bruke, mens andre krever mer innsats. Alle funksjoner har likevel samme anatomi, som vist nedenfor for funksjonen [mean()](https://rdrr.io/r/base/mean.html):
mean(x)Alle funksjoner begynner med navnet på funksjonen. I eksempelet ovenfor heter funksjonen mean. Etter navnet følger en parentes som inneholder alle funksjonens argumenter. Et argument er informasjon som funksjonen trenger. Funksjonen [mean()](https://rdrr.io/r/base/mean.html) har ett obligatorisk argument (det må angis for at funksjonen skal kunne brukes), nemlig x. Argumenter spesifiseres med et likhetstegn (=). I dette tilfellet er argumentet x vektoren som vi vil anvende funksjonen [mean()](https://rdrr.io/r/base/mean.html) på. La oss lage en vektor som vi kaller my_numbers, og anvende funksjonen [mean()](https://rdrr.io/r/base/mean.html) på den:
my_numbers <- c(1, 2, 3, 4)

mean(x=my_numbers)[1] 2.5Funksjonen [mean()](https://rdrr.io/r/base/mean.html) har også argumentet na.rm, som angir om beregningen skal ignorere manglende verdier. Manglende verdier angis som NA (Not Available) i R. Funksjonen [mean()](https://rdrr.io/r/base/mean.html) tolererer ikke at verdier mangler, med mindre det spesifiseres eksplisitt med argumentet na.rm, som betyr “NA remove”. Vi kan teste dette ved å legge inn en manglende verdi i vektoren vår og bruke funksjonen på samme måte igjen:
my_numbers <- c(1, 2, 3, NA)

mean(x=my_numbers)[1] NAResultatet blir NA, noe som betyr at også resultatet mangler! Dette skyldes at argumentet na.rm er satt til FALSE som standard. Da fjernes ikke NA, og dermed kan gjennomsnittet ikke beregnes. Nå gjør vi et nytt forsøk der vi ber R fjerne NA:
my_numbers <- c(1, 2, 3, NA)
mean(x=my_numbers, na.rm=TRUE)[1] 2Nå fungerer det! Argumentet na.rm har en default-verdi, dvs. en grunninnstilling som brukes dersom brukeren ikke spesifiserer noe annet. For na.rm er grunninnstillingen FALSE, noe som forklarer hvorfor vi ikke kunne gjøre beregningen på my_numbers, som inneholdt NA, uten å spesifisere na.rm=TRUE.
Merk følgende:
- En funksjon kan ha mange argumenter, og de skilles med komma når funksjonen brukes.
- Hvert argument i funksjonen har et navn.
- Vi bruker likhetstegn for å spesifisere hva argumentet skal være. For eksempel
na.rm=TRUE.
Vi kan faktisk angi verdier for et argument uten å skrive argumentets navn. Her beregner vi gjennomsnittet uten å angi at my_numbers er argumentet x.
my_numbers <- c(1, 2, 3, 4)
mean(my_numbers)[1] 2.5Hvis du ikke angir argumentenes navn, må du angi dem i nøyaktig den rekkefølgen funksjonen har. For å finne rekkefølgen kan du bruke hjelpedokumentasjonen. Hvis du lar være å skrive ut navnene på argumentene, vil R matche verdiene dine med argumentene i funksjonen etter rekkefølge.
?meanmean(x, trim = 0, na.rm = FALSE, ...)Av dokumentasjonen fremgår det at første argument er x, andre argument er trim og tredje argument er na.rm. Det fremgår også at x mangler en default-verdi, mens det finnes en for trim (trim=0) og na.rm (na.rm=FALSE). Disse standardinnstillingene vil bli brukt dersom brukeren ikke spesifiserer noe annet.
Default for argumenter
Argumenter med default-verdier er ikke obligatoriske å spesifisere når en funksjon brukes. Disse argumentene vil få sine default-verdier dersom brukeren ikke angir noe annet.
Du kan også bruke funksjonen args() for å se hvilke argumenter en funksjon har. Her kontrollerer vi argumentene i funksjonen [rnorm()](https://rdrr.io/r/stats/Normal.html):
args(rnorm)function (n, mean = 0, sd = 1)Den fullstendige dokumentasjonen for mean ser slik ut:
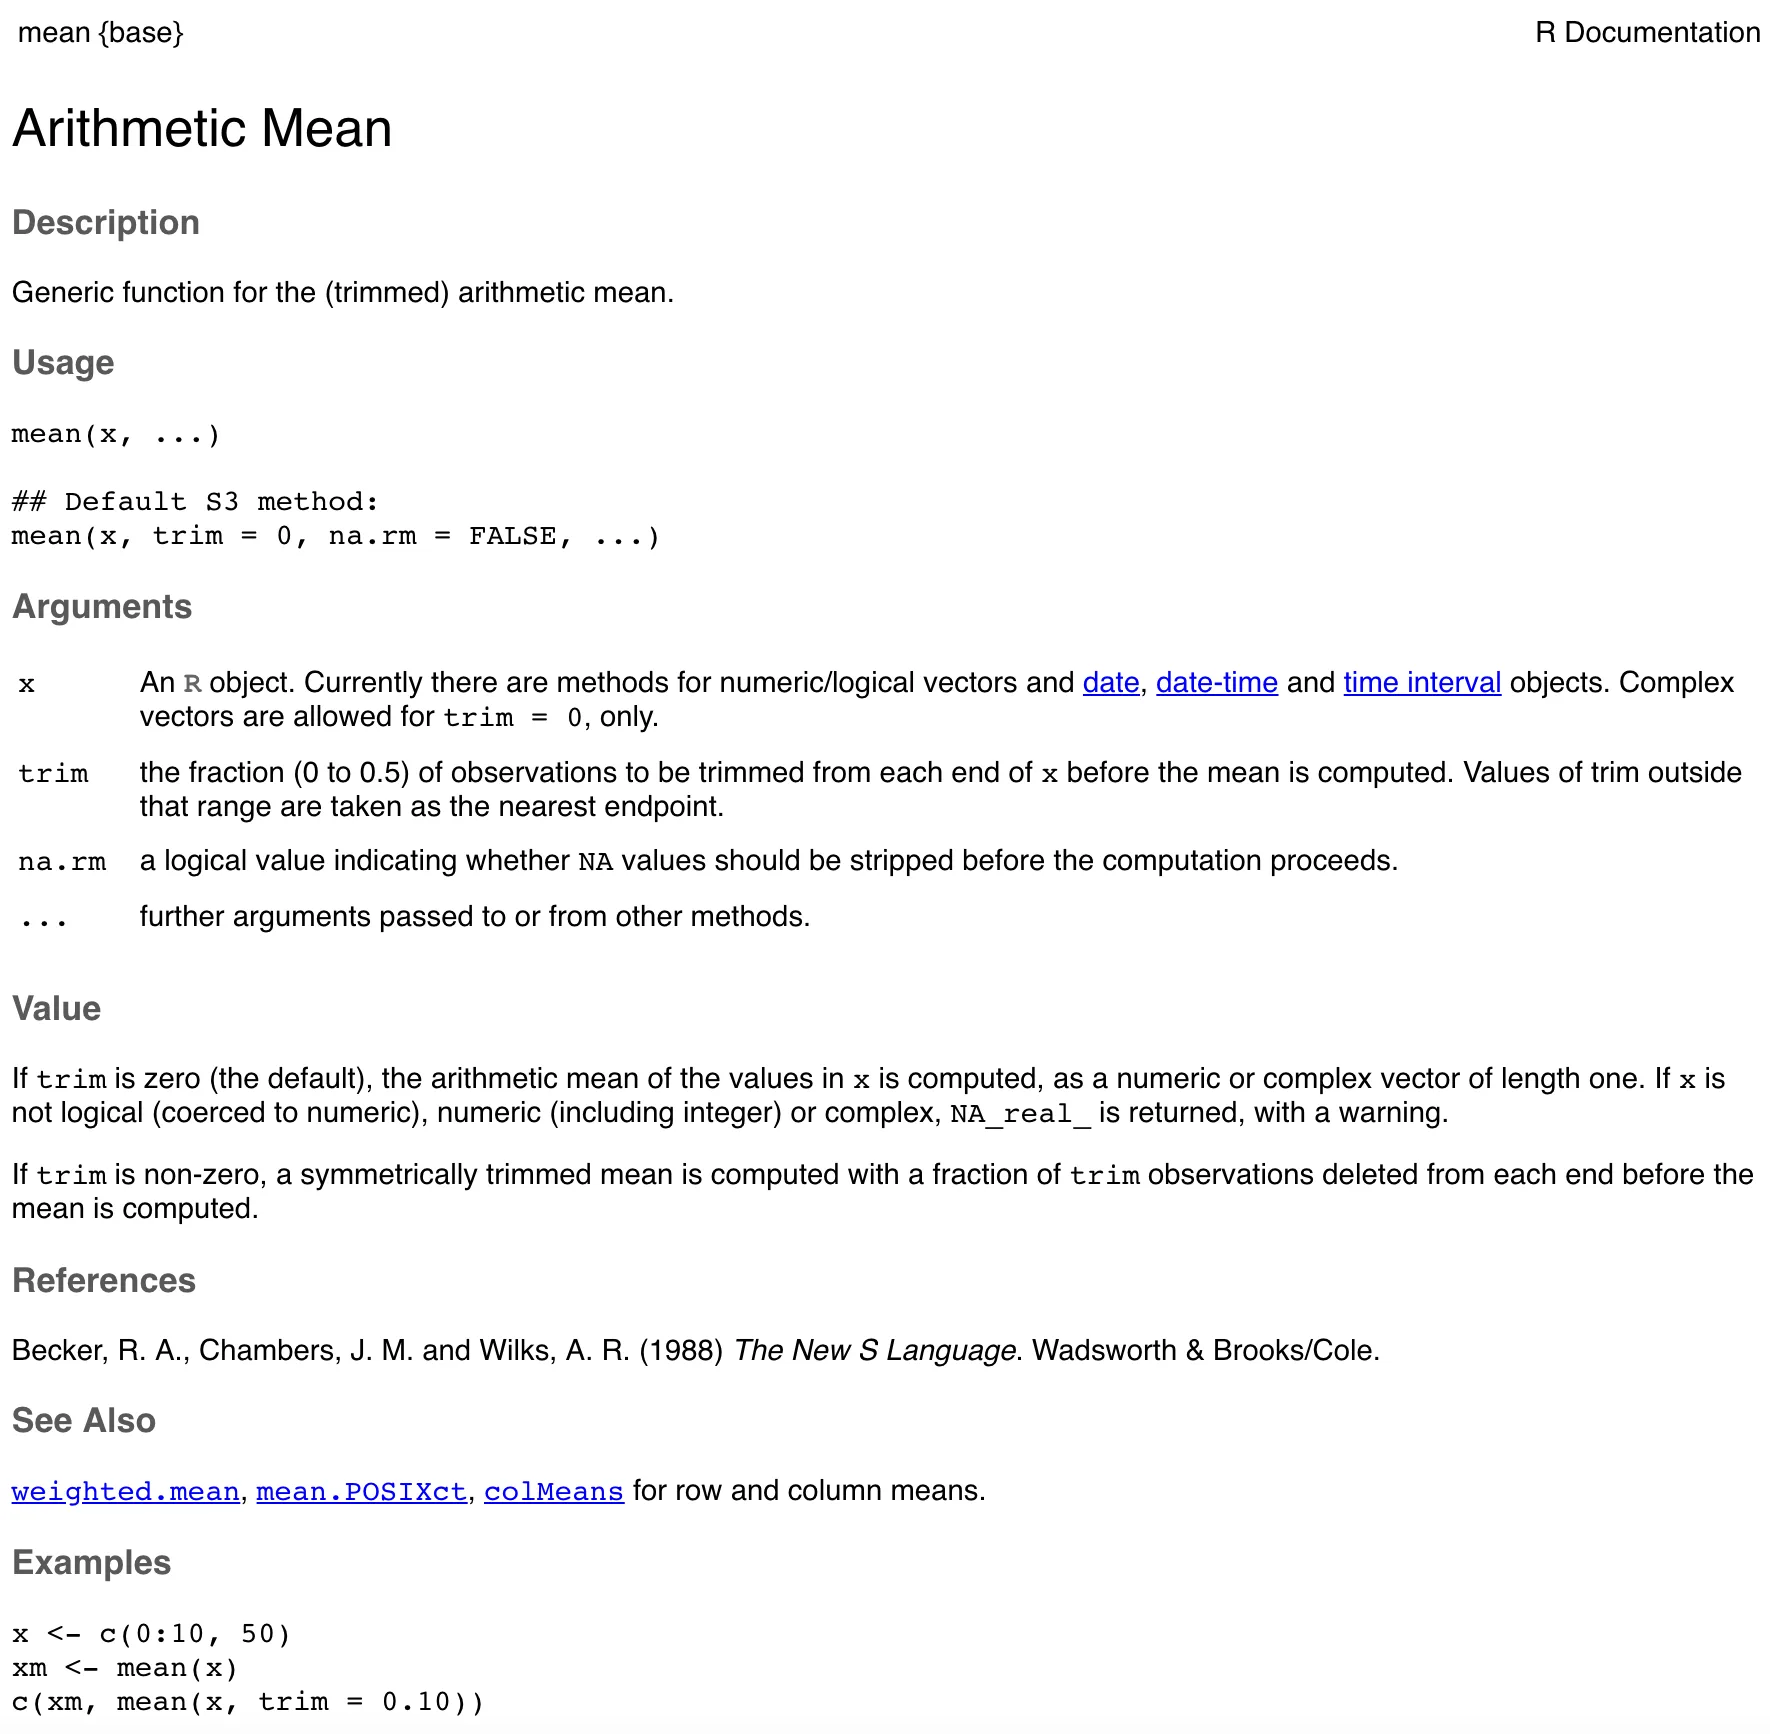
Aller først til venstre i dokumentasjonen ser du følgende: mean {base}
mean er navnet på funksjonen, og base er pakken som inneholder funksjonen.
Deretter kommer overskriften Arithmetic Mean, etterfulgt av Description. Under Description finnes en beskrivelse av funksjonen. Under overskriften Usage får du vite hvilke argumenter funksjonen har og hva default-verdiene deres er. Under overskriften Arguments får du forklaringer på hva som forventes av argumentene. Under overskriften Value fremgår det hva funksjonen forventes å gjøre. Aller nederst får du se eksempler på bruk av funksjonen.
5.2 Funksjoner i funksjoner
R gir deg mulighet til å bygge inn funksjoner i funksjoner, noe som er svært nyttig. Se følgende eksempel, der vi bruker tre ulike funksjoner ([c()](https://rdrr.io/r/base/c.html), [mean()](https://rdrr.io/r/base/mean.html), [round()](https://rdrr.io/r/base/Round.html)) i tre trinn:
## c() lager en vektor
my_values = c(10, 30.5, 99.43, 98.3)

## mean() beregner gjennomsnittet i vektoren
my_mean <- mean(my_values)

## round() runder av til nærmeste heltall
my_result <- round(my_mean)

## Se resultat
my_result[1] 60Du kan bygge inn disse funksjonene i hverandre, slik:
my_result <- round(mean(c(10, 30.5, 99.43, 98.3)))
my_result[1] 60Når du bygger inn en funksjon i en annen funksjon, begynner R med den innerste funksjonen og går trinnvis til den ytterste. I dette eksempelet betyr det at [c()](https://rdrr.io/r/base/c.html) kjøres først og [round()](https://rdrr.io/r/base/Round.html) kjøres sist.
5.2.1 Tips
Bruk argumentenes navn når du bruker dem. Det gjør koden lettere å lese både for deg selv og for andre, og det kan forhindre uventede feil.
5.3 Vanlige funksjoner i base R
Standardinstallasjonen av R kommer med mange nyttige funksjoner. Noen av disse funksjonene er listet opp nedenfor. Husk at mange av disse funksjonene mer eller mindre er forlatt til fordel for nyere og bedre funksjoner.
5.3.1 Generelle funksjoner i base R
builtins() # List all built-in functions
options()  # Set options to control how R computes & displays results
?NA        # Help page on handling of missing data values
abs(x)     # The absolute value of "x"
append()   # Add elements to a vector
c(x)       # A generic function which combines its arguments
cat(x)     # Prints the arguments
cbind()    # Combine vectors by row/column (cf. "paste" in Unix)
diff(x)    # Returns suitably lagged and iterated differences
gl()       # Generate factors with the pattern of their levels
grep()     # Pattern matching
identical()  # Test if 2 objects are *exactly* equal
jitter()     # Add a small amount of noise to a numeric vector
julian()     # Return Julian date
length(x)    # Return no. of elements in vector x
ls()         # List objects in current environment
mat.or.vec() # Create a matrix or vector
paste(x)     # Concatenate vectors after converting to character
range(x)     # Returns the minimum and maximum of x
rep(1,5)     # Repeat the number 1 five times
rev(x)       # List the elements of "x" in reverse order
seq(1,10,0.4)  # Generate a sequence (1 -> 10, spaced by 0.4)
sequence()     # Create a vector of sequences
sign(x)        # Returns the signs of the elements of x
sort(x)        # Sort the vector x
order(x)       # list sorted element numbers of x
tolower(),toupper()  # Convert string to lower/upper case letters
unique(x)      # Remove duplicate entries from vector
system("cmd")  # Execute "cmd" in operating system (outside of R)
vector()       # Produces a vector of given length and mode
formatC(x)     # Format x using 'C' style formatting specifications
floor(x), ceiling(x), round(x), signif(x), trunc(x)   # rounding functions
Sys.getenv(x)  # Get the value of the environment variable "x"
Sys.putenv(x)  # Set the value of the environment variable "x"
Sys.time()     # Return system time
Sys.Date()     # Return system date
getwd()        # Return working directory
setwd()        # Set working directory
?files         # Help on low-level interface to file system
list.files()   # List files in a give directory
file.info()    # Get information about files

## Built-in constants:
pi,letters,LETTERS   # Pi, lower & uppercase letters, e.g. letters[7] = "g"
month.abb,month.name # Abbreviated & full names for months
5.3.2 Matematiske operasjoner
log(x),logb(),log10(),log2(),exp(),expm1(),log1p(),sqrt()   # Fairly obvious
cos(),sin(),tan(),acos(),asin(),atan(),atan2()       # Usual stuff
cosh(),sinh(),tanh(),acosh(),asinh(),atanh()         # Hyperbolic functions
union(),intersect(),setdiff(),setequal()             # Set operations
+,-,*,/,^,%%,%/%                                     # Arithmetic operators
<,>,<=,>=,==,!=                                      # Comparison operators
eigen()      # Computes eigenvalues and eigenvectors
deriv()      # Symbolic and algorithmic derivatives of simple expressions
integrate()  # Adaptive quadrature over a finite or infinite interval.
sqrt(),sum()
?Control     # Help on control flow statements (e.g. if, for, while)
?Extract     # Help on operators acting to extract or replace subsets of vectors
?Logic       # Help on logical operators
?Mod         # Help on functions which support complex arithmetic in R
?Paren       # Help on parentheses
?regex       # Help on regular expressions used in R
?Syntax      # Help on R syntax and giving the precedence of operators
?Special     # Help on special functions related to beta and gamma functions
5.3.3 Grafikk
help(package=graphics)  # List all graphics functions</em>
plot()                  # Generic function for plotting of R objects</em>
par()                   # Set or query graphical parameters</em>
curve(5*x^3,add=T)      # Plot an equation as a curve</em>
points(x,y)             # Add another set of points to an existing graph</em>
arrows()                # Draw arrows [see errorbar script]</em>
abline()                # Adds a straight line to an existing graph</em>
lines()                 # Join specified points with line segments</em>
segments()              # Draw line segments between pairs of points</em>
hist(x)                 # Plot a histogram of x</em>
pairs()                 # Plot matrix of scatter plots</em>
matplot()               # Plot columns of matrices</em>
?device                 # Help page on available graphical devices</em>
postscript()            # Plot to postscript file</em>
pdf()                   # Plot to pdf file</em>
png()                   # Plot to PNG file</em>
jpeg()                  # Plot to JPEG file</em>
X11()                   # Plot to X window</em>
persp()                 # Draws perspective plot</em>
contour()               # Contour plot</em>
image()                 # Plot an image</em>
5.3.4 Regresjonsmodeller
lm          # Fit liner model</em>
glm         # Fit generalised linear model</em>
nls         # non-linear (weighted) least-squares fitting</em>
lqs         # "library(MASS)" resistant regression</em>
optim       # general-purpose optimisation</em>
optimize    # 1-dimensional optimisation</em>
constrOptim # Constrained optimisation</em>
nlm         # Non-linear minimisation</em>
nlminb      # More robust (non-)constrained non-linear minimisation</em>
5.3.5 Statistiske beregninger
help(package=stats)   # List all stats functions
?Chisquare            # Help on chi-squared distribution functions
?Poisson              # Help on Poisson distribution functions
help(package=survival) # Survival analysis
cor.test()            # Perform correlation test
cumsum(); cumprod(); cummin(); cummax()   # Cumuluative functions for vectors
density(x)            # Compute kernel density estimates
ks.test()             # Performs one or two sample Kolmogorov-Smirnov tests
loess(), lowess()     # Scatter plot smoothing
mad()                 # Calculate median absolute deviation
mean(x), weighted.mean(x), median(x), min(x), max(x), quantile(x)
rnorm(), runif()  # Generate random data with Gaussian/uniform distribution
splinefun()           # Perform spline interpolation
smooth.spline()       # Fits a cubic smoothing spline
sd()                  # Calculate standard deviation
summary(x)            # Returns a summary of x: mean, min, max etc.
t.test()              # Student's t-test
var()                 # Calculate variance
sample()              # Random samples & permutations
ecdf()                # Empirical Cumulative Distribution Function
qqplot()              # quantile-quantile plot